Bonjour ! Dans la leçon précédente, nous avons appris à utiliser le théorème de Bayes pour mettre à jour nos croyances face à de nouvelles preuves, en travaillant sur des événements discrets. Nous avons vu que la rareté d'un événement (sa probabilité a priori) a un impact énorme sur la probabilité finale. Mais que se passe-t-il lorsque les données ne sont pas des événements distincts, mais des mesures continues comme la taille, le poids, la température ou une erreur de prédiction ?
Cette leçon se penche sur la distribution de probabilité la plus importante et la plus répandue pour les données continues : la distribution Normale, aussi appelée distribution Gaussienne. Notre objectif est de décrire ses propriétés fondamentales. Vous découvrirez pourquoi sa forme de "cloche" est si familière, comment seulement deux paramètres la définissent entièrement, et comment utiliser une règle simple pour interpréter la dispersion des données autour de la moyenne.
La célèbre courbe en cloche
La distribution Normale est omniprésente dans la nature et les statistiques. De nombreuses caractéristiques, résultant de la somme de nombreux petits processus indépendants, tendent à suivre cette distribution : la taille des individus, la pression artérielle, les erreurs de mesure, et même les scores de QI.
Visuellement, elle est représentée par une courbe symétrique en forme de cloche. Pour vous forger une première intuition visuelle, la vidéo suivante de StatQuest est un excellent point de départ.
The Normal Distribution, Clearly Explained!!!
Cette vidéo, "The Normal Distribution, Clearly Explained!!!", introduit de manière très intuitive la forme de la distribution Normale et ce qu'elle représente.
Regardez le début de la vidéo, de l'introduction de la courbe en cloche jusqu'à la fin de l'explication des axes. L'auteur utilise l'exemple de la taille humaine pour montrer que l'axe des X représente les valeurs possibles (par exemple, la taille) et l'axe des Y représente la probabilité relative de chaque valeur. Les valeurs proches de la moyenne sont très probables (la courbe est haute), tandis que les valeurs extrêmes sont rares (la courbe est basse).
Comme vous l'avez vu, la distribution Normale est symétrique autour d'un pic central. La plupart des observations se regroupent autour de ce pic, et les probabilités diminuent de manière égale des deux côtés à mesure que l'on s'éloigne du centre.
Les deux paramètres qui définissent tout : Moyenne et Écart-type
La beauté de la distribution Normale réside dans sa simplicité : sa forme et ses probabilités sont entièrement déterminées par seulement deux paramètres.
-
La moyenne () : C'est la tendance centrale de la distribution. Elle définit la position du pic de la courbe en cloche. Si vous changez la moyenne, toute la courbe se déplace vers la gauche ou vers la droite sur l'axe des X, mais sa forme reste identique. Dans une distribution normale, la moyenne est également égale à la médiane et au mode.
-
L'écart-type () : C'est une mesure de la variabilité ou de la dispersion des données. Il définit la largeur de la courbe.
- Un petit écart-type () signifie que les données sont très regroupées autour de la moyenne. La courbe sera donc haute et étroite.
- Un grand écart-type () signifie que les données sont plus étalées. La courbe sera donc basse et large.
La vidéo suivante, en arabe, illustre parfaitement comment ces deux paramètres modifient l'apparence de la courbe.
12- Statistical Analysis | Normal Distribution | تحليل إحصائي | التوزيع الطبيعي أهم توزيع في الإحصاء
Cette vidéo du Dr. Ahmed Hagag, "Analyse statistique | Distribution Normale", contient une excellente section visuelle sur l'effet des paramètres.
Regardez la partie qui montre l'impact des changements de la moyenne et de l'écart-type. Vous verrez d'abord comment deux distributions avec le même écart-type mais des moyennes différentes sont simplement décalées l'une par rapport à l'autre. Ensuite, vous verrez comment deux distributions avec la même moyenne mais des écarts-types différents ont des largeurs différentes.
Pour approfondir votre compréhension de ces deux paramètres, le texte suivant offre une explication claire et concise.
Normal Distribution in Statistics
Cet article de "Statistics By Jim" détaille le rôle de la moyenne et de l'écart-type.
Lisez la section "Parameters of the Normal Distribution", en vous concentrant sur les sous-sections Mean μ et Standard deviation σ. L'auteur y explique précisément comment chaque paramètre contrôle la localisation et la dispersion de la distribution.
La règle empirique : une estimation rapide de la répartition des données
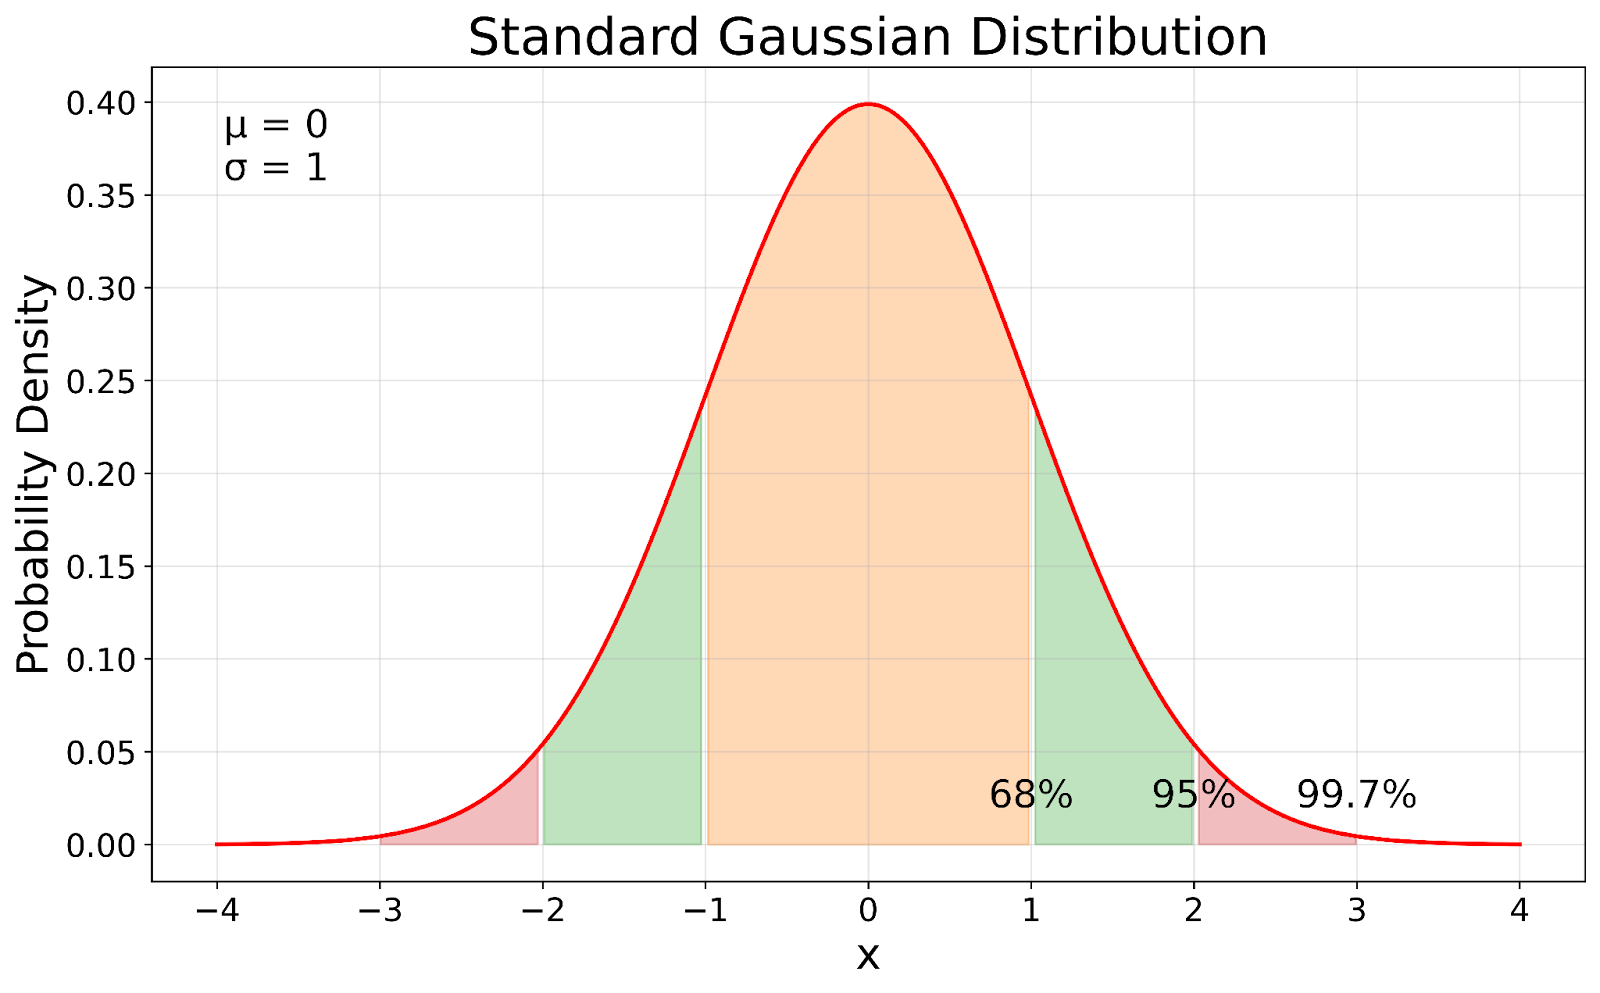
Une des propriétés les plus utiles de la distribution Normale est la Règle Empirique (ou règle 68-95-99.7). Elle nous donne un moyen rapide de savoir quelle proportion des données se situe à une certaine distance de la moyenne, mesurée en écarts-types.
Pour toute distribution Normale :
- Environ 68% des données se situent à ±1 écart-type de la moyenne ().
- Environ 95% des données se situent à ±2 écarts-types de la moyenne ().
- Environ 99.7% des données se situent à ±3 écarts-types de la moyenne ().
Cela signifie que la quasi-totalité des observations se trouve dans un intervalle de six écarts-types (trois de chaque côté de la moyenne).
Pour voir comment cette règle s'applique à un cas concret, nous allons reprendre l'article que vous avez commencé à lire.
Normal Distribution in Statistics
Cette section de l'article de "Statistics By Jim" illustre la Règle Empirique avec un exemple simple.
Lisez la section The Empirical Rule. L'exemple sur les temps de livraison de pizza est particulièrement parlant. Si le temps moyen de livraison est de 30 minutes avec un écart-type de 5 minutes, vous pouvez immédiatement en déduire que 95% des livraisons arriveront entre 20 et 40 minutes (30 ± 2*5).
Autres propriétés importantes
En plus de ce que nous avons vu, voici quelques autres propriétés clés de la distribution Normale :
- Unimodale : Elle n'a qu'un seul pic (mode).
- Symétrie parfaite : La moyenne, la médiane et le mode sont tous égaux et situés au centre de la distribution. 50% des valeurs sont inférieures à la moyenne et 50% sont supérieures.
- Théorème Central Limite : C'est une propriété plus avancée, mais cruciale en statistiques. En résumé, si vous prenez de nombreux échantillons aléatoires d'une population (même si cette population n'est pas distribuée normalement) et que vous calculez la moyenne de chaque échantillon, la distribution de ces moyennes tendra à suivre une distribution Normale. C'est l'une des raisons pour lesquelles la distribution Normale est si fondamentale.
Un aperçu : La Distribution Normale Standard
Imaginez que vous ayez les résultats d'un test de mathématiques (moyenne 70, ) et d'un test d'histoire (moyenne 80, ). Un score de 80 en maths est-il aussi bon qu'un score de 85 en histoire ? Il est difficile de comparer directement.
Pour résoudre ce problème, les statisticiens utilisent la distribution Normale standard (ou distribution Z). C'est un cas particulier de la distribution Normale avec une moyenne de 0 et un écart-type de 1.
On peut convertir n'importe quelle valeur d'une distribution normale en un "score Z" en utilisant la formule :
Le Z-score nous indique de combien d'écarts-types une valeur se situe au-dessus ou en dessous de la moyenne. Un Z-score de +1 signifie que la valeur est un écart-type au-dessus de la moyenne. Un Z-score de -2 signifie qu'elle est deux écarts-types en dessous.
Ce processus, appelé standardisation, est extrêmement important en machine learning, notamment pour une étape de prétraitement des données appelée feature scaling (mise à l'échelle des caractéristiques), que nous aborderons bien plus tard. Pour l'instant, il suffit de savoir que cette version "standard" existe et sert de référence commune.
Conclusion
Dans cette leçon, nous avons exploré les caractéristiques fondamentales de la distribution Normale, le modèle le plus important pour les données continues.
Voici les points clés à retenir :
- La distribution Normale a une forme de courbe en cloche, symétrique autour de son centre.
- Elle est entièrement définie par deux paramètres : la moyenne (), qui détermine sa position, et l'écart-type (), qui détermine sa largeur.
- La Règle Empirique (68-95-99.7) offre une méthode pratique pour estimer la proportion de données qui se trouvent à 1, 2 ou 3 écarts-types de la moyenne.
- La distribution Normale standard () sert de référence pour comparer des données provenant de différentes distributions normales.
Maintenant que nous avons une bonne compréhension de la manière dont les valeurs d'une seule variable peuvent être distribuées, la prochaine étape logique est d'examiner comment deux variables peuvent interagir. Dans la prochaine leçon, nous nous pencherons sur la manière de calculer et d'interpréter la corrélation entre deux variables.