Bonjour ! Dans la leçon précédente, nous avons exploré la probabilité conditionnelle, , qui nous indique la probabilité de l'événement A sachant que l'événement B s'est produit. Nous avons terminé en posant une question cruciale : que faire si nous connaissons la probabilité d'une observation sachant une hypothèse, mais que nous voulons connaître la probabilité de l'hypothèse sachant l'observation ? Par exemple, nous connaissons la fiabilité d'un test médical (), mais ce qui nous intéresse vraiment, c'est la probabilité d'avoir la maladie si notre test est positif ().
Cette leçon porte sur l'outil mathématique qui nous permet de faire précisément cette "inversion" : le théorème de Bayes. C'est l'un des concepts les plus importants et les plus puissants des statistiques, avec des applications allant du diagnostic médical au filtrage des e-mails en passant par l'intelligence artificielle. Notre objectif est de comprendre ce théorème, d'apprendre à identifier ses composantes et de l'appliquer pour résoudre des problèmes probabilistes simples.
L'intuition fondamentale : Mettre à jour nos croyances
Avant même de regarder la formule, il est essentiel de comprendre l'idée maîtresse derrière le théorème de Bayes : les preuves ne créent pas nos croyances à partir de zéro, elles les mettent à jour. L'erreur de raisonnement la plus courante que le théorème de Bayes corrige est le fait d'ignorer nos connaissances antérieures (les "taux de base" ou base rates).
La vidéo suivante de 3Blue1Brown, réputée pour sa clarté visuelle, illustre ce point de manière brillante avec un problème classique.
Bayes theorem, the geometry of changing beliefs
Cette vidéo, intitulée "Bayes theorem, the geometry of changing beliefs", utilise le célèbre problème de "Steve le bibliothécaire" pour vous faire ressentir intuitivement pourquoi les probabilités antérieures sont si importantes.
Regardez la première partie de la vidéo, de l'introduction jusqu'à la fin de l'exemple de Steve. Faites particulièrement attention à la manière dont l'auteur visualise la population de fermiers et de bibliothécaires. Vous verrez que même si une description semble correspondre à un stéréotype, la rareté de ce groupe dans la population générale a un impact énorme sur la probabilité finale.
Le message clé à retenir est que notre jugement final doit être un équilibre entre deux choses :
- Notre croyance initiale (la probabilité a priori ou prior probability).
- La force de la nouvelle preuve (la vraisemblance ou likelihood).
Le théorème de Bayes formalise simplement cette logique de mise à jour.
Le théorème de Bayes et ses composantes
La formule du théorème de Bayes peut sembler intimidante au premier abord, mais elle n'est que la traduction mathématique de l'intuition que nous venons de voir. Pour deux événements A et B, elle s'écrit :
Chaque terme a un nom et un rôle spécifiques. L'image suivante illustre parfaitement cette décomposition.

Décortiquons ces termes. Pour cela, nous allons utiliser un exemple concret : A = "le patient a la maladie", B = "le test est positif".
-
: Probabilité a posteriori (Posterior). C'est ce que nous voulons calculer. La probabilité que le patient ait la maladie, après avoir vu le résultat positif du test. C'est notre croyance mise à jour.
-
: Probabilité a priori (Prior). C'est notre croyance initiale, avant de connaître le résultat du test. C'est la prévalence de la maladie dans la population générale. Par exemple, si 1% de la population a la maladie, .
-
: Vraisemblance (Likelihood). C'est la probabilité d'observer la preuve (test positif) si notre hypothèse (le patient a la maladie) est vraie. C'est souvent une spécification du test, comme sa sensibilité. Par exemple, "le test détecte correctement la maladie dans 95% des cas", donc .
-
: Preuve (Evidence ou Marginal Likelihood). C'est la probabilité totale d'observer la preuve (un test positif), quelle que soit la condition du patient. C'est souvent la partie la plus délicate à calculer. Un test peut être positif pour deux raisons : un vrai positif (le patient est malade ET le test est positif) OU un faux positif (le patient n'est pas malade ET le test est quand même positif). On le calcule avec la loi des probabilités totales :
Pour formaliser votre compréhension de ces termes, le texte suivant est une excellente référence.
Cet article de GeeksforGeeks définit clairement chaque terme impliqué dans le théorème de Bayes.
Lisez la section Termes liés au théorème de Bayes. Concentrez-vous sur les définitions de "Priori Probability", "Posterior Probability", et "Conditional Probability" (qui correspond ici à la vraisemblance). L'exemple donné pour chacun (maladie et test) vous aidera à faire le lien.
Application : Le diagnostic médical
Passons maintenant à la pratique avec un exemple numérique complet. Les diagrammes en arbre sont un outil extrêmement puissant pour organiser les informations d'un problème de Bayes et éviter les erreurs.
La vidéo suivante vous guidera à travers un exemple classique de dépistage du cancer, en utilisant à la fois un diagramme en arbre et la formule.
Bayes' Theorem of Probability With Tree Diagrams & Venn Diagrams
Cette vidéo de The Organic Chemistry Tutor est très claire et décompose le problème étape par étape.
Regardez attentivement la section qui commence avec l'exemple du cancer de la prostate en utilisant un diagramme en arbre. Observez comment le diagramme permet de visualiser toutes les branches de probabilités et facilite le calcul du dénominateur (la probabilité totale d'un test positif). Ensuite, regardez la méthode alternative qui utilise une population hypothétique (par exemple, 10 000 personnes). Cette approche, appelée "fréquences naturelles", est souvent encore plus intuitive que de manipuler directement les probabilités.
L'image ci-dessous résume parfaitement le type de calcul que vous venez de voir dans la vidéo. Elle utilise un diagramme en arbre pour organiser les probabilités d'un test de dépistage du cancer, puis applique la formule pour trouver la probabilité d'avoir le cancer étant donné un test positif.
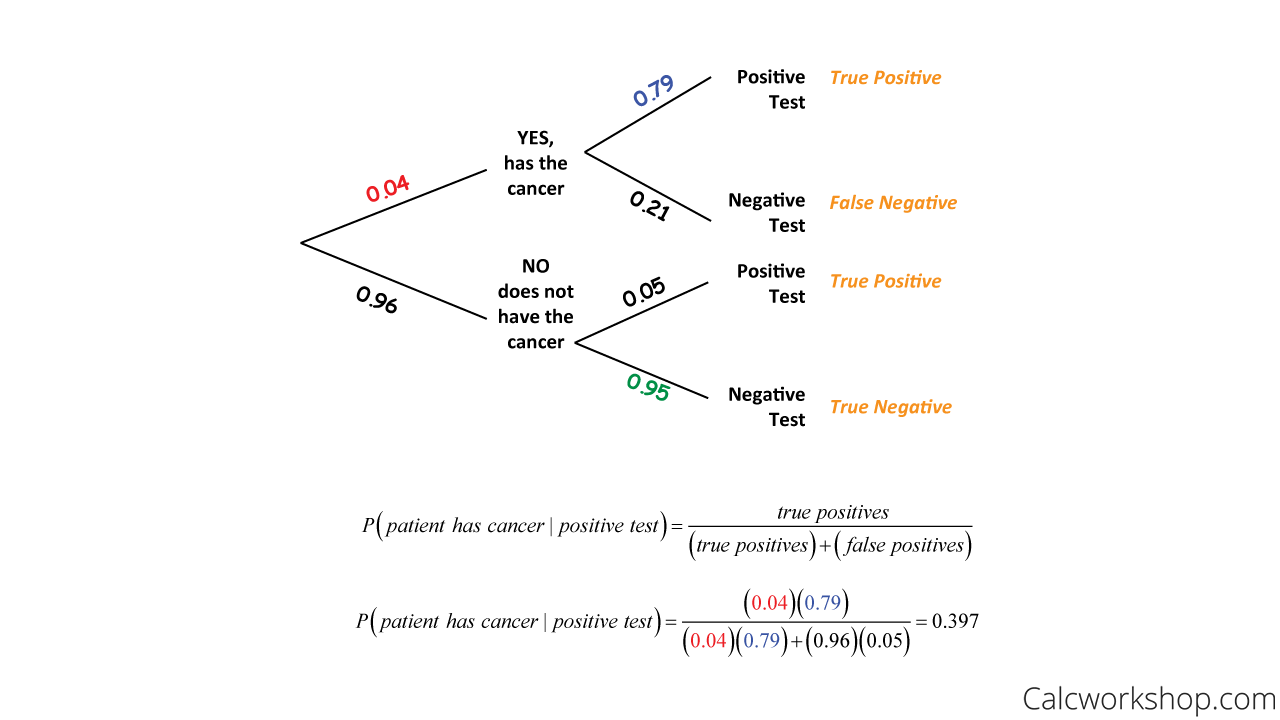
Ce qui est souvent surprenant dans ces problèmes, c'est que même avec un test qui semble très fiable, la probabilité d'avoir réellement la maladie après un test positif peut être étonnamment faible. Cela se produit lorsque la maladie elle-même est rare (le prior est très bas). Dans ce cas, le nombre de faux positifs (personnes saines qui testent positif) peut devenir comparable, voire supérieur, au nombre de vrais positifs. C'est l'une des leçons les plus importantes du théorème de Bayes.
Conclusion
Dans cette leçon, nous avons abordé le théorème de Bayes, un pilier de la pensée probabiliste. Vous êtes maintenant en mesure d'appliquer ce théorème pour mettre à jour vos croyances à la lumière de nouvelles preuves.
Voici les points essentiels à retenir :
- Le théorème de Bayes est une formule pour "inverser" les probabilités conditionnelles, nous permettant de calculer à partir de .
- Il formalise l'idée de mise à jour d'une croyance a priori () en une croyance a posteriori () grâce à la vraisemblance de la preuve ().
- Le taux de base (la probabilité a priori) est un élément crucial ; l'ignorer est une erreur de raisonnement courante.
- Des outils visuels comme les diagrammes en arbre ou le raisonnement avec des populations hypothétiques peuvent rendre l'application du théorème beaucoup plus intuitive.
Jusqu'à présent, nous avons travaillé avec des probabilités d'événements discrets. Cependant, de nombreuses données dans le monde réel sont continues, comme la taille des personnes, les erreurs de mesure, ou les prix des actions. Pour modéliser de telles données, nous avons besoin de distributions de probabilité. Dans la prochaine leçon, nous étudierons la plus importante et la plus célèbre d'entre elles : la distribution Normale (ou Gaussienne).