Bonjour ! Dans la leçon précédente, nous avons exploré la distribution Normale, le modèle le plus courant pour décrire la dispersion d'une seule variable continue. Nous avons vu comment la moyenne et l'écart-type définissent entièrement cette distribution. Il est maintenant temps d'élargir notre perspective et d'étudier les relations entre deux variables.
Cette leçon se concentre sur une question fondamentale en analyse de données : comment deux variables évoluent-elles l'une par rapport à l'autre ? Nous allons apprendre à quantifier cette relation à l'aide du coefficient de corrélation. Notre objectif est de savoir non seulement calculer cette mesure, mais aussi et surtout, de l'interpréter correctement. Vous découvrirez comment un simple nombre peut nous renseigner sur la direction et la force d'une association, une compétence essentielle pour l'exploration de données et la construction de modèles en machine learning.
Qu'est-ce que la corrélation ?
En termes simples, la corrélation mesure le degré d'association entre deux variables. Lorsque nous analysons des données, nous cherchons souvent des schémas. Par exemple :
- Les étudiants qui passent plus de temps à réviser ont-ils tendance à obtenir de meilleures notes ?
- Les voitures plus lourdes consomment-elles plus de carburant ?
- Le temps passé sur les réseaux sociaux affecte-t-il le nombre d'heures de sommeil ?
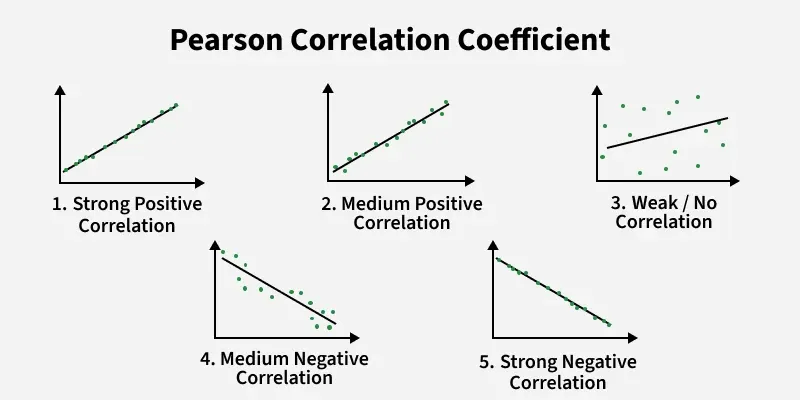
La corrélation nous aide à répondre à ces questions en décrivant la direction et la force de la relation. Une première étape indispensable pour comprendre une corrélation est de la visualiser. Pour ce faire, on utilise un nuage de points (scatter plot), où chaque point représente une observation (par exemple, un étudiant) avec ses valeurs pour les deux variables (par exemple, heures de révision et note à l'examen).
Il existe trois types principaux de relations linéaires :
- Corrélation positive : Lorsque la valeur d'une variable augmente, la valeur de l'autre a tendance à augmenter également. Les points du nuage de points forment une tendance ascendante de gauche à droite.
- Corrélation négative : Lorsque la valeur d'une variable augmente, la valeur de l'autre a tendance à diminuer. Les points du nuage forment une tendance descendante de gauche à droite.
- Pas de corrélation (ou corrélation faible) : Il n'y a pas de tendance linéaire évidente. Les points sont dispersés de manière aléatoire.
L'image suivante illustre parfaitement ces différents cas.
Interpréter le coefficient de corrélation de Pearson (r)
Visualiser les données est une excellente première étape, mais nous avons besoin d'une mesure précise. Le coefficient de corrélation de Pearson, noté r, est la mesure la plus courante. C'est un nombre sans unité qui est toujours compris entre -1 et +1.
Coefficient de corrélation - JMP
Cet article du portail de connaissances JMP explique clairement ce qu'est le coefficient de corrélation et ce que signifient ses valeurs.
Lisez la première partie de l'article pour bien comprendre la définition et le rôle de ce coefficient. Concentrez-vous sur les sections Qu'est-ce que le coefficient de corrélation ? et Que signifient les valeurs. (Ignorez la mention de la "valeur p" pour l'instant, nous y reviendrons dans des contextes plus avancés).
Pour résumer ce que vous venez de lire, voici comment interpréter la valeur de r :
- r = +1 : Corrélation positive parfaite. Tous les points de données se trouvent sur une ligne droite ascendante.
- r proche de +1 : Forte corrélation positive. Les points sont très proches d'une ligne ascendante.
- r proche de 0 : Corrélation linéaire faible ou nulle. Il n'y a pas de tendance linéaire claire.
- r proche de -1 : Forte corrélation négative. Les points sont très proches d'une ligne descendante.
- r = -1 : Corrélation négative parfaite. Tous les points se trouvent sur une ligne droite descendante.
En pratique, on examine souvent les corrélations entre plusieurs variables à la fois à l'aide d'une matrice de corrélation. Chaque cellule de la matrice donne le coefficient de corrélation entre deux variables.

Observez cette matrice. Le coefficient de corrélation entre "Hours spent studying" (heures d'étude) et "Exam score" (note à l'examen) est de 0.82. C'est une valeur proche de +1, ce qui indique une forte corrélation positive. Cela correspond à notre intuition : plus on étudie, meilleure est la note. À l'inverse, la corrélation entre "Hours spent studying" et "Hours spent sleeping" (heures de sommeil) est de -0.22, une corrélation négative faible.
Comment calculer le coefficient de corrélation
Maintenant que nous savons interpréter r, voyons comment il est calculé. La formule peut sembler intimidante au premier abord, mais elle repose sur des concepts que nous connaissons déjà : la moyenne et les écarts par rapport à la moyenne.
La formule du coefficient de corrélation de Pearson est :
Où :
- et sont les valeurs individuelles des deux variables pour la i-ème observation.
- et sont les moyennes des variables x et y.
- est le nombre total d'observations.
Le calcul se décompose en plusieurs étapes logiques. L'article de JMP que nous avons commencé à lire contient un excellent exemple pas à pas.
Coefficient de corrélation - JMP
Cette partie de l'article vous guide à travers un calcul complet en utilisant un exemple simple de ventes de glaces et de température.
Suivez attentivement les étapes du calcul : Commencez par la section introduction à l'exemple, qui présente les données. Lisez la première étape pour calculer la moyenne de chaque variable. La deuxième étape calcule l'écart de chaque point de donnée par rapport à sa moyenne. L'étape suivante calcule le numérateur de la formule (la somme des produits). Notez bien l'interprétation graphique : ce terme est positif si les points se trouvent principalement dans les quadrants "en bas à gauche" et "en haut à droite". Poursuivez avec le calcul du dénominateur. Enfin, lisez la dernière étape qui assemble le tout pour obtenir la valeur finale de r.
Pour une explication alternative et très visuelle du calcul, la vidéo suivante de StatQuest est excellente.
Pearson's Correlation, Clearly Explained!!!
Cette vidéo "Pearson's Correlation, Clearly Explained!!!" décompose le calcul de manière très intuitive.
Regardez la section qui explique le calcul. Josh Starmer explique comment le numérateur (la covariance) capture la façon dont les variables varient ensemble, et comment le dénominateur normalise cette valeur pour la maintenir entre -1 et 1.
Le piège le plus important : Corrélation n'est pas Causalité
C'est sans doute le point le plus crucial de cette leçon. Le fait que deux variables soient fortement corrélées ne signifie jamais que l'une est la cause de l'autre.
Un exemple classique est la corrélation positive entre les ventes de glaces et le nombre de noyades. Ce n'est pas parce que les gens mangent des glaces qu'ils se noient ! La cause sous-jacente, ou variable de confusion, est la chaleur estivale. Quand il fait chaud, les gens achètent plus de glaces ET ils se baignent davantage, ce qui augmente le risque de noyade.
Le coefficient de corrélation ne détecte que les associations linéaires. Il peut être trompé par :
- Des relations non-linéaires : Des variables peuvent avoir une relation forte mais non-linéaire (par exemple, en forme de U), et leur coefficient de corrélation de Pearson sera proche de zéro.
- Des valeurs aberrantes (outliers) : Un seul point de donnée très éloigné des autres peut fausser considérablement la valeur de r.
C'est pourquoi il est toujours essentiel de visualiser vos données avec un nuage de points avant de tirer des conclusions basées uniquement sur le coefficient de corrélation.
Coefficient de corrélation - JMP
La fin de l'article de JMP met en évidence ces limitations avec des exemples visuels très clairs.
Lisez la section finale Une image vaut 1000 coefficients. Les animations (GIFs) montrent comment une corrélation de zéro peut cacher une relation bien réelle, et comment une seule valeur aberrante peut créer une corrélation qui n'existe pas dans le reste des données.
Conclusion
Dans cette leçon, nous avons appris à quantifier et à interpréter la relation linéaire entre deux variables.
Voici les points clés à retenir :
- La corrélation mesure la force et la direction de l'association linéaire entre deux variables.
- Le coefficient de corrélation de Pearson (r) est une valeur comprise entre -1 (corrélation négative parfaite) et +1 (corrélation positive parfaite). Une valeur proche de 0 indique une absence de corrélation linéaire.
- Le calcul de r est basé sur les moyennes et les écarts de chaque variable.
- Il est fondamental de visualiser les données avec un nuage de points pour ne pas être trompé par des relations non-linéaires ou des valeurs aberrantes.
- Le point le plus important : la corrélation n'implique pas la causalité.
Nous avons maintenant terminé notre tour d'horizon des concepts statistiques fondamentaux. Dans la prochaine leçon, nous changerons de sujet pour aborder les bases du calcul différentiel. Nous allons découvrir la notion de dérivée, qui représente un taux de changement. Ce concept peut sembler très différent, mais il est au cœur du fonctionnement des algorithmes d'apprentissage automatique, car il leur permet de "trouver" les meilleurs paramètres en minimisant les erreurs.