Recommended resources
The freely available resources this lesson will direct you to.

Olá! Na lição anterior, vimos que taxa de amostragem, profundidade de bits, canais e compressão determinam que informação a gravação preserva, mas não garantem, isoladamente, uma transcrição correta. Agora vamos acompanhar essa informação até ela se tornar texto: o que acontece na captura, o que é preparado antes do reconhecimento, como o ASR escolhe palavras e o que ainda precisa ser feito com a saída.
Ao final, você deverá conseguir descrever um pipeline de áudio de ponta a ponta e, diante de uma falha na transcrição de uma sessão, localizar a etapa em que ela pode ter surgido. O objetivo aqui é compreender o fluxo, sem programação nem detalhes de arquitetura que serão estudados adiante.
O pipeline começa antes do modelo
Imagine uma sessão em que uma pessoa diz: “O parecer foi aprovado por doze votos.” Para que essa frase apareça em uma transcrição, é preciso primeiro captá-la. O microfone transforma as variações do som em um sinal; a gravação digital representa esse sinal por amostras e o armazena em um ou mais canais. Se “doze” ficou encoberto por outra voz no áudio captado, as etapas seguintes terão de lidar com essa incerteza. Salvar o arquivo em um formato melhor depois não recria a fala que não foi registrada com clareza.
A entrada do pipeline pode ser uma gravação pronta ou um fluxo de áudio recebido durante o evento. Nessa entrada, importa verificar se o arquivo está íntegro, se há canais com captações diferentes e se sua codificação é aceita pelo sistema escolhido. Por exemplo, quando dois microfones foram preservados em canais separados, juntá-los sem examinar o conteúdo pode misturar falas que antes podiam ser ouvidas individualmente. Em termos operacionais, convém conservar a gravação original: ela permite conferir dúvidas e comparar o resultado com o que foi efetivamente captado.
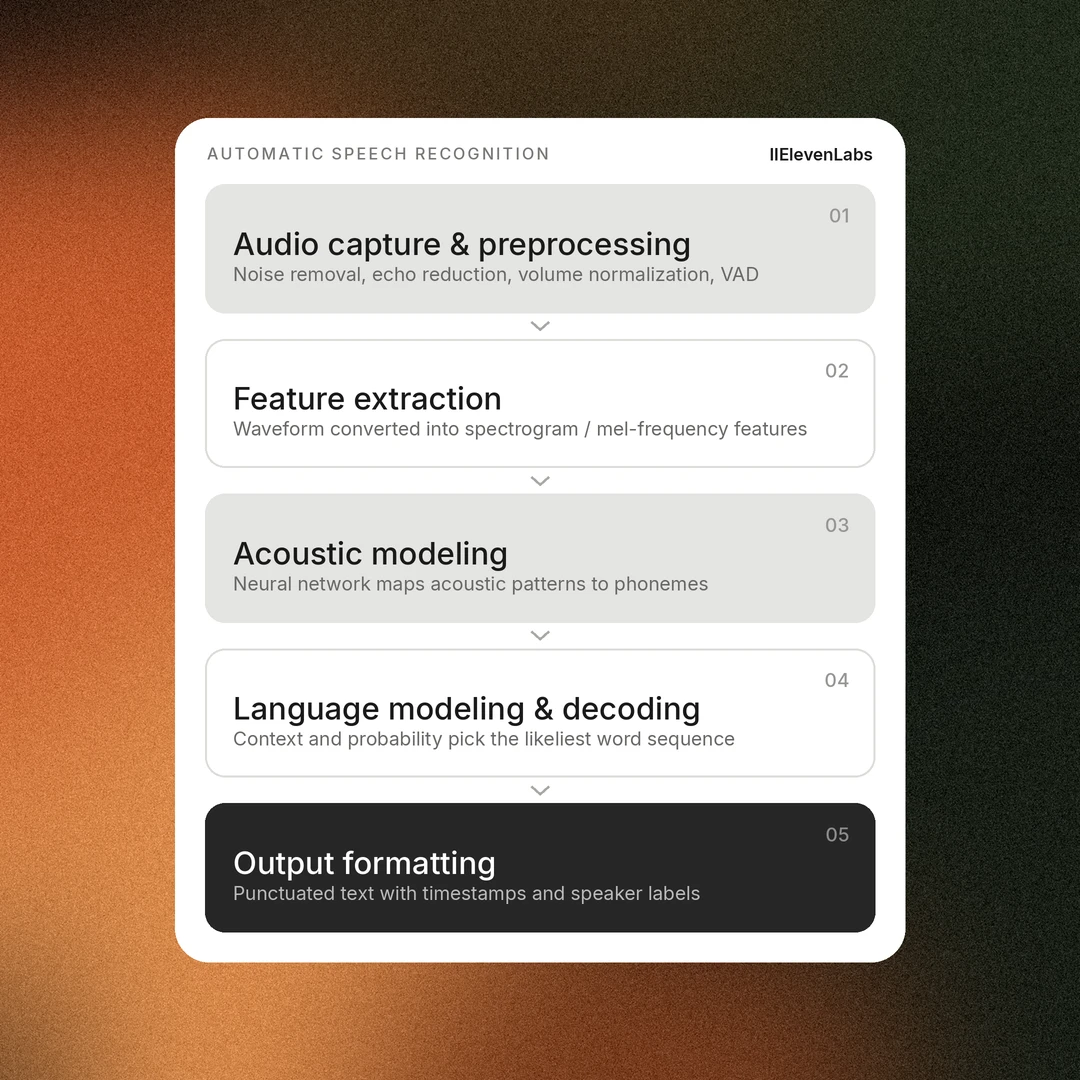
O diagrama abaixo oferece um mapa das etapas. Ele é útil para visualizar o percurso, mas representa uma organização didática, não uma arquitetura obrigatória para todos os sistemas.
Preparar o áudio sem apagar a fala
Após a captura, vem o pré-processamento: operações destinadas a tornar o áudio utilizável pelo ASR. Conforme a gravação e o serviço, isso pode incluir selecionar ou separar canais, converter a codificação para um formato aceito, ajustar níveis de volume, atenuar ruído ou eco e identificar intervalos em que há fala.
Essa última operação costuma ser chamada detecção de atividade de voz, ou VAD. Ela ajuda a distinguir trechos com fala de trechos sem fala, permitindo encaminhar ou delimitar segmentos para reconhecimento. Não se trata, porém, de saber quais palavras foram pronunciadas, nem quem falou. Uma intervenção curta ou em volume baixo pode ser confundida com silêncio; por isso, segmentar exige cuidado.
Pense no pré-processamento como uma tentativa de preservar e apresentar melhor a evidência acústica, não de fabricar evidência. Atenuar um ruído constante pode ajudar o reconhecimento; uma filtragem agressiva pode retirar junto partes da voz. Aumentar o volume de um trecho muito baixo pode torná-lo mais fácil de escutar, mas não separa automaticamente a fala do ruído que também foi amplificado. Da mesma forma, converter um arquivo para atender à entrada do serviço não recupera informação perdida na captação original — ponto que vimos na lição anterior.
Assista a dois trechos do vídeo em português a seguir. O primeiro situa a passagem da captação ao reconhecimento; o segundo ajuda a distinguir a saída da máquina do trabalho documental posterior. Deixe a comparação entre arquiteturas mencionada no vídeo apenas como contexto: ela será retomada em outra parte do curso.
Reconhecimento de Fala | Câmara dos Deputados: ASR e Transcrição | Ep. 1
No vídeo “Reconhecimento de Fala | Câmara dos Deputados: ASR e Transcrição | Ep. 1”, do canal Concursando com IA, observe como a gravação entra no processo e por que a saída automática ainda demanda tratamento.
Assista a captação e reconhecimento, prestando atenção à passagem do som captado para dados processáveis. Depois, vá a saída e revisão e observe a diferença entre texto bruto e registro documental conferido.
Do sinal às hipóteses de palavras
Uma gravação digital ainda não é uma sequência de palavras. O sistema precisa extrair do sinal informações úteis sobre a fala. Na extração de características acústicas, o áudio é analisado em intervalos curtos para representar padrões como a distribuição de energia nas frequências ao longo do tempo. Um espectrograma é uma maneira de visualizar essa distribuição; diferentes sistemas também podem usar outras representações. Você não precisa calcular nenhuma delas para descrever sua função: elas oferecem ao reconhecimento uma forma de analisar os padrões presentes no áudio.
Em seguida, o reconhecimento acústico avalia que unidades de fala ou texto são compatíveis com esses padrões. A explicação clássica costuma mencionar sons da língua, chamados fonemas, como representação intermediária. Isso ajuda a entender a dificuldade: sons próximos podem sustentar hipóteses diferentes. Não conclua, entretanto, que todo ASR moderno é obrigado a converter o áudio em fonemas antes de produzir texto. Alguns sistemas trabalham com outras unidades e integram funções antes tratadas separadamente.
O sistema também precisa decidir entre sequências candidatas. É aí que entram o contexto linguístico e a decodificação: o contexto ajuda a avaliar quais combinações de palavras são plausíveis, e a decodificação seleciona uma saída entre as possibilidades consideradas. No exemplo inicial, uma hipótese pode conter “doze votos” e outra, “dois votos”. O contexto da frase pode favorecer uma delas, mas plausibilidade não substitui a evidência do áudio. Uma palavra muito provável naquele assunto ainda pode não ter sido pronunciada.
A descrição do Amazon Transcribe na documentação da AWS apresenta um exemplo concreto desse núcleo do pipeline. Leia apenas o panorama inicial; os mecanismos internos de seus modelos serão objeto de lições futuras.
Amazon Transcribe - AWS AI Service Cards
Na seção “Design of Amazon Transcribe”, a AWS descreve como seu serviço recebe áudio, analisa características acústicas, avalia hipóteses de texto e entrega um resultado. Leia para associar essas funções às etapas do pipeline, sem tomar a implementação de um serviço como regra universal.
Em “Design of Amazon Transcribe”, localize o item “Machine learning”. Leia o panorama inicial: ele começa com a apresentação do reconhecimento automático e termina quando descreve a saída devolvida ao usuário. Acompanhe especialmente a diferença entre extrair características, avaliar candidatos e selecionar a transcrição. Pode parar antes do parágrafo que começa com “Language identification”.
Note também que decodificar não é revisar. A decodificação escolhe uma hipótese produzida pelo sistema; revisão é a conferência posterior dessa hipótese, especialmente quando a fidelidade do documento importa.
Da hipótese de texto à transcrição pós-processada
A saída inicial do reconhecimento pode conter palavras corretas sem estar pronta para leitura ou uso documental. Imagine que o sistema tenha produzido:
o parecer foi aprovado por doze votos
O pós-processamento textual pode apresentar a mesma fala como:
O parecer foi aprovado por 12 votos.
Nesse exemplo, houve capitalização, pontuação e representação escrita do número. Dependendo das funções disponíveis e ativadas, a saída pode trazer também marcas de tempo que localizam palavras ou segmentos no áudio e rótulos de falantes. Essas informações não são todas equivalentes: uma marca de tempo indica quando um trecho ocorreu; um rótulo de falante tenta indicar qual voz o produziu, sem necessariamente estabelecer o nome da pessoa.
Nem toda formatação acontece obrigatoriamente depois de um texto bruto completo. Certos sistemas já produzem pontuação e capitalização durante o reconhecimento; outros aplicam etapas posteriores. Por isso, a distinção mais importante para esta lição é funcional: reconhecer o conteúdo falado e apresentá-lo em uma forma textual utilizável são tarefas relacionadas, mas não idênticas.
O risco aparece quando a apresentação dá aparência de certeza a uma hipótese errada. Se o ASR ouviu “dois votos” em lugar de “doze votos”, formatar “2 votos” produz um texto legível, não corrige o erro. Tampouco se deve inserir um nome de orador apenas porque parece provável pelo contexto. Para um registro que exige fidelidade, a saída pós-processada continua sujeita à conferência com o áudio e às regras editoriais aplicáveis. Estudaremos essa revisão humana em profundidade mais adiante.
Como descrever o fluxo sem confundir suas etapas
Uma maneira de organizar uma resposta discursiva é partir da função de cada etapa:
- Captura e ingestão: a fala é gravada e o áudio é recebido com suas características e canais.
- Pré-processamento: o áudio é verificado e, quando necessário, preparado ou segmentado para o serviço, buscando preservar a fala.
- Análise acústica e reconhecimento: o sistema obtém representações do sinal e avalia hipóteses compatíveis com o que foi ouvido.
- Decodificação: hipóteses são comparadas para produzir uma sequência de texto.
- Pós-processamento e conferência: o resultado pode receber pontuação, capitalização e outras informações de apresentação; quando a finalidade exige fidelidade documental, pessoas conferem e corrigem a saída.
Essa enumeração descreve o percurso lógico, não exige que existam cinco programas ou cinco modelos independentes. Também não transforma a conferência humana em uma função automática do ASR. A revisão pode ocorrer no fluxo de produção do documento, depois que o sistema entrega seu resultado.
Para questões de certo ou errado, observe especialmente as afirmações absolutas:
- “O pré-processamento sempre melhora a transcrição.” Não: uma operação inadequada pode eliminar informação útil.
- “A extração de características já identifica as palavras.” Não: ela representa aspectos do áudio para que o reconhecimento possa analisá-los.
- “Todo ASR precisa de uma etapa explícita de conversão para fonemas.” Não: essa é uma descrição possível, não uma exigência universal.
- “Uma saída pontuada e capitalizada está pronta para publicação.” Não necessariamente: boa apresentação não garante correspondência fiel com a gravação.
Em síntese
Um pipeline de áudio leva a fala da captação a uma hipótese textual apresentada para uso. A preparação do sinal busca entregar ao sistema a melhor informação disponível; a análise acústica e a decodificação produzem a transcrição; o pós-processamento organiza sua apresentação. Em nenhuma dessas passagens se deve presumir que informação ausente foi recuperada ou que texto bem formatado foi automaticamente validado.
Na próxima lição, examinaremos com mais precisão o que pode dar errado antes e durante a captação: ruído, reverberação, distância do microfone e outras condições que afetam toda a cadeia posterior.