Recommended resources
The freely available resources this lesson will direct you to.
- Profundidade de Bits e Taxa de Amostragemwww.youtube.com
- WAV X AIFF X FLAC X MP3 Qual o melhor? MIXANDO #21www.youtube.com
- Optimize audio files for Cloud Speech-to-Text | Google Cloud Documentationdocs.cloud.google.com
- Audio concepts in Azure Speech in Foundry Tools - Foundry Tools | Microsoft Learnlearn.microsoft.com
Olá! Na lição anterior, distinguimos o reconhecimento automático de fala da transcrição que ele produz e da conferência necessária para um registro documental fiel. Agora vamos olhar para o áudio que chega ao ASR. Mesmo um bom sistema pode perder palavras se a gravação não preservou adequadamente a fala ou se seus canais e seu formato foram preparados de modo inadequado.
Ao final, você deverá conseguir explicar quatro características de um arquivo de áudio — taxa de amostragem, profundidade de bits, número de canais e compressão — sem cair na ideia de que «um número maior» ou «um arquivo maior» significa, necessariamente, uma transcrição melhor.
Amostragem: quantas vezes o som é medido
A fala captada por um microfone varia continuamente. Para armazená-la digitalmente, o equipamento mede o sinal em instantes sucessivos. A taxa de amostragem indica quantas dessas medições, chamadas amostras, são feitas por segundo. Uma gravação a 16 kHz contém 16 mil amostras por segundo em cada canal; uma a 48 kHz contém 48 mil.
Comece pela explicação de amostragem e profundidade de bits da Microsoft Learn. Ela estabelece a diferença que orientará a lição: a taxa de amostragem diz respeito aos instantes em que o sinal é medido; a profundidade de bits, à representação do valor medido.
Audio concepts in Azure Speech in Foundry Tools - Foundry Tools | Microsoft Learn
Leia a seção “Audio sampling” para situar taxa de amostragem e profundidade de bits no processo de digitalização da fala.
Na seção “Audio sampling”, comece no parágrafo iniciado por “Human speech is inherently analog information”. Leia a explicação até o fim da subseção “Bit depth”, incluindo a subseção intermediária “Sample rate”. Pare antes de “Channels”. Observe por que 16 kHz costuma ser adequado à fala e por que taxas mais altas também aumentam o volume de dados.
A amostragem determina que faixa de frequências pode ser representada. Como limite teórico, uma taxa de 16 kHz permite representar frequências abaixo de 8 kHz; a 8 kHz, abaixo de 4 kHz. Isso não significa que toda gravação a 8 kHz seja ininteligível: sistemas telefônicos utilizam essa faixa e ainda permitem reconhecer muita fala. Significa que parte da informação acústica presente em uma captação de faixa mais ampla não estará disponível. O limite teórico também não garante, por si, uma boa gravação: a captura precisa ser feita adequadamente para evitar distorções.
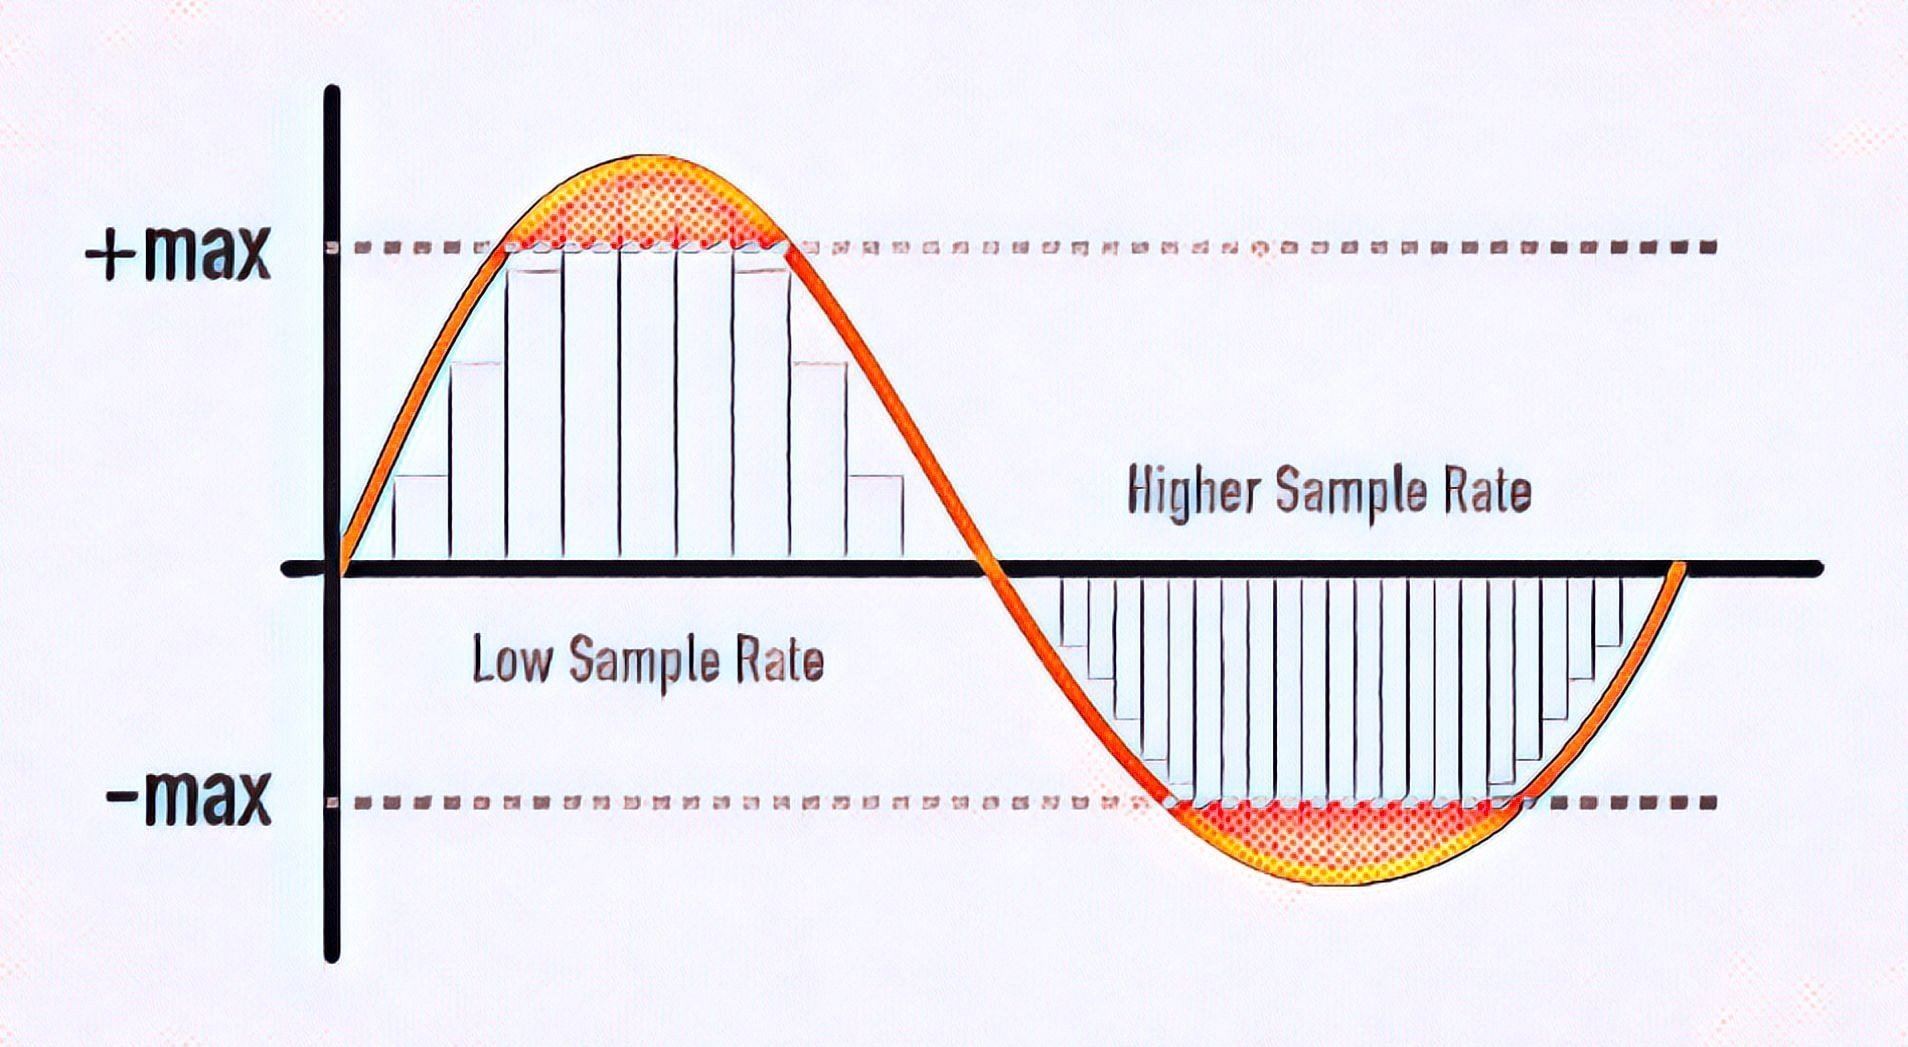
Há uma distinção decisiva entre captar áudio com uma taxa mais alta e converter depois um arquivo de taxa baixa para uma taxa mais alta. Se uma sessão foi gravada originalmente a 8 kHz, salvá-la posteriormente como 48 kHz não recupera as frequências que a captação original não registrou. O arquivo pode crescer sem que o ASR receba informação nova sobre a fala.
A documentação do Google Cloud aprofunda esse ponto e oferece recomendações para o serviço específico descrito ali — úteis como referência, mas não como regra universal para toda ferramenta.
Optimize audio files for Cloud Speech-to-Text | Google Cloud Documentation
Leia as partes da documentação do Google Cloud sobre frequência e amplitude do sinal para consolidar o efeito prático de amostragem e profundidade de bits no ASR.
Na subseção “Sample rate (frequency range)”, leia o trecho sobre amostragem, desde a definição até a advertência de que aumentar posteriormente a taxa não recupera a informação ausente. Em seguida, na subseção “Bit depth (dynamic range)”, leia o trecho sobre bits, desde a definição até a advertência equivalente sobre conversão de 8 para 16 bits. Foque na diferença entre prevenir a perda durante a gravação e tentar repará-la depois.
Para a prova, retenha a formulação precisa: uma taxa de amostragem adequada preserva a faixa de frequências necessária à tarefa; elevá-la indefinidamente não garante maior precisão do reconhecimento. O resultado também depende da captação original e de outras condições do áudio.
Profundidade de bits: como cada medição é representada
Se a taxa de amostragem responde «quantas vezes por segundo?», a profundidade de bits responde «com quantos níveis possíveis representamos cada medição?». Em áudio digital não comprimido, 16 bits permitem representar mais níveis de amplitude do que 8 bits. Com poucos níveis, valores próximos precisam ser arredondados para o mesmo valor digital. Esse arredondamento é a quantização; quando seus efeitos se tornam perceptíveis, podem introduzir ruído ou distorção.
A profundidade de bits está, portanto, ligada à precisão das amplitudes representadas e à faixa dinâmica que o formato pode acomodar. Isso é diferente da faixa de frequências ligada à taxa de amostragem. Uma forma breve de não confundi-las é pensar em duas perguntas: quando medimos o sinal? e com que resolução registramos cada medida?
Para áudio destinado ao ASR, 16 bits são uma escolha comum; gravações com resolução muito baixa, como 8 bits, podem prejudicar a fidelidade. Mas passar de 16 para 24 bits não implica, automaticamente, que o sistema reconhecerá mais palavras. E converter um original de 8 para 16 bits não desfaz os arredondamentos já ocorridos. A qualidade do microfone, o nível da gravação e a presença de ruído continuam importando. Se a voz foi captada com distorção intensa, um arquivo posterior com mais bits não «reconstitui» as palavras.
Não confunda profundidade de bits com taxa de bits (bitrate). Profundidade de bits descreve a resolução de cada amostra no áudio não comprimido; taxa de bits descreve quanto dado é armazenado ou transmitido por segundo. Voltaremos a essa segunda medida ao tratar de compressão.
Canais: quais sinais foram preservados separadamente
Um arquivo mono contém um canal. Um arquivo estéreo contém dois; gravações com vários microfones podem preservar ainda mais canais. O número, sozinho, não diz se a fala será transcrita melhor. O que importa é o conteúdo de cada canal e a forma como o serviço de ASR o recebe.
Imagine dois microfones numa sessão: um capta com clareza a pessoa que preside os trabalhos; outro, alguém que intervém à distância. Se cada microfone foi gravado em um canal distinto, preservar essa separação pode facilitar a escuta e o processamento. Se os canais forem combinados precipitadamente em mono, as duas vozes poderão ficar mais difíceis de distinguir. Em contrapartida, dois canais que contêm praticamente a mesma captação podem não oferecer informação útil adicional para reconhecer a fala.
Os serviços também diferem quanto ao que aceitam: alguns fluxos esperam áudio mono; outros permitem processar canais separadamente e indicar de qual canal veio cada resultado. Leia a subseção específica da Microsoft Learn, sem transformar o comportamento dos exemplos citados em regra para todos os serviços.
Audio concepts in Azure Speech in Foundry Tools - Foundry Tools | Microsoft Learn
Retome o mesmo guia da Microsoft Learn, agora apenas para verificar por que a configuração de canais depende da modalidade de processamento.
Na subseção “Channels”, imediatamente após “Bit depth”, leia a explicação sobre canais. Observe a diferença entre esperar um fluxo mono e conseguir separar ou rotular resultados por canal em determinadas modalidades.
Canal não é sinônimo de falante. Um único canal pode conter várias pessoas falando; um mesmo falante pode aparecer em mais de um canal. Também não se deve concluir que estéreo é sempre inválido para ASR, nem que converter tudo para mono é sempre a melhor decisão. A escolha depende da gravação e das capacidades do serviço utilizado.
Compressão: economizar espaço sem perdas ou descartar informação
Arquivos de áudio podem ser grandes. A compressão reduz o espaço necessário para guardá-los ou transmiti-los, mas há duas maneiras essencialmente diferentes de fazê-lo.
Na compressão sem perdas, o áudio digital original pode ser reconstruído após a descompressão. FLAC é um exemplo. Já o áudio PCM não comprimido, frequentemente armazenado em WAV, conserva as amostras sem empregar essa economia de espaço. Na compressão com perdas, parte da informação é descartada ou aproximada para obter arquivos menores; MP3 é um exemplo. Uma conversão posterior para outro formato não recupera o que foi descartado.
Assista à comparação em português a seguir. O vídeo examina os formatos pela perspectiva da produção de áudio; ao assisti-lo, traduza a distinção entre preservar e descartar informação para a necessidade de reconhecer palavras.
WAV X AIFF X FLAC X MP3 Qual o melhor? MIXANDO #21
Assista aos trechos de “WAV X AIFF X FLAC X MP3 Qual o melhor?”, do canal Reaper Brasil, para visualizar a diferença entre compactar sem descartar informação e reduzir o arquivo com perdas.
Veja FLAC sem perdas, concentrando-se no fato de que o áudio original pode ser recuperado. Depois, veja MP3 com perdas, observando a troca entre tamanho do arquivo e informação preservada. Para fins de ASR, não é necessário acompanhar cada detalhe dos testes de áudio: foque na distinção entre os dois tipos de compressão e na influência da taxa de bits sobre o MP3 apresentado.
Para o ASR, sem perdas não significa sem problemas: um FLAC pode preservar perfeitamente uma gravação que já continha ruído ou fala distante. Significa apenas que a etapa de compressão não descartou informação do áudio digital recebido. Da mesma forma, um arquivo com perdas não é necessariamente inutilizável; porém, compressão agressiva pode remover detalhes da fala ou produzir artefatos que dificultem o reconhecimento, especialmente em trechos já pouco claros.
Aqui a taxa de bits costuma aparecer em kbps, sobretudo ao comparar configurações de áudio comprimido. Ela não equivale à profundidade de bits. Para ver a diferença, um canal PCM não comprimido a 16 kHz e 16 bits gera, antes de eventuais informações adicionais do arquivo, bits de dados por segundo: cerca de 256 kbps. Se houver dois canais equivalentes, a quantidade dobra. Já a taxa de bits de um áudio comprimido depende também de como o codec representa e reduz os dados; não se pode deduzir sua profundidade de bits apenas do valor em kbps.
Por fim, extensão do arquivo e codificação não são a mesma coisa. «WAV» ou «MP4» identificam contêineres; é preciso saber como o áudio dentro deles foi codificado e quais formatos o serviço aceita. Na prática operacional, trocar apenas a extensão do nome do arquivo não converte seu conteúdo.
Como avaliar um áudio antes de enviá-lo ao ASR
Suponha que uma equipe receba a gravação de um debate em dois canais, originalmente captada a 16 kHz e 16 bits, e precise preparar uma cópia para reconhecimento. Uma decisão fundamentada não começa por «elevar tudo a 48 kHz» ou «transformar tudo em MP3». Começa por verificar o que existe: quais falas estão em cada canal, se a captação original está íntegra e que codificações e configurações o serviço aceita.
Se os canais preservam microfones distintos, convém avaliar seu processamento separado antes de combiná-los. Se for necessária uma conversão de formato, uma opção sem perdas evita acrescentar descartes à informação já registrada. Se a fonte original tiver baixa taxa de amostragem ou baixa profundidade de bits, aumentar esses números na cópia pode atender a uma exigência técnica de entrada, mas não restaura a qualidade ausente na fonte. Se a transmissão exigir compressão com perdas, será preciso ponderar economia de armazenamento ou banda e possível prejuízo à fala — sem presumir que o efeito será igual em toda gravação.
Em questões de certo ou errado, tome cuidado com quatro generalizações:
- «Quanto maior a taxa de amostragem, mais correta será a transcrição.» Não necessariamente; ela amplia a faixa de frequências que pode ser representada, mas não corrige uma captação ruim.
- «Converter de 8 para 16 bits melhora a informação originalmente gravada.» Não; a conversão não recupera a resolução perdida.
- «O ASR sempre exige áudio mono.» Não; a aceitação e o tratamento de múltiplos canais variam conforme o serviço e sua modalidade.
- «Todo arquivo comprimido perdeu qualidade.» Não; existe compressão sem perdas, como FLAC.
Para uma resposta discursiva, reúna os conceitos em uma explicação causal: a amostragem limita as frequências preservadas; a profundidade de bits condiciona a representação das amplitudes; os canais determinam quais captações permanecem separadas; e a compressão pode preservar integralmente o áudio digital ou descartar parte dele. A preparação correta busca entregar ao ASR a melhor informação efetivamente captada, em um formato compatível, sem criar a falsa impressão de que conversões posteriores recuperam o que já se perdeu.
Em síntese
Taxa de amostragem e profundidade de bits descrevem dimensões diferentes da digitalização; canais descrevem como as captações são organizadas; compressão descreve como os dados são armazenados ou transmitidos. Nenhuma dessas propriedades, isoladamente, garante uma transcrição fiel. A pergunta decisiva é se o arquivo preserva a fala disponível na gravação e pode ser processado corretamente pelo sistema.
Na próxima lição, seguiremos esse áudio ao longo de um pipeline: da captura e do pré-processamento à transcrição e ao pós-processamento do texto.