Recommended resources
The freely available resources this lesson will direct you to.
- Reconhecimento de Fala | Câmara dos Deputados: ASR e Transcrição | Ep. 1www.youtube.com
- Ensuring speech intelligibility with proper audio techniqueswww.youtube.com
- Best practices | Cloud Speech-to-Text | Google Cloud Documentationcloud.google.com
- Enhancing Speech Quality and Music Experience with Reverberation Control Technology | NTT Technical Reviewwww.ntt-review.jp
Olá! Na lição anterior, acompanhamos o percurso do áudio: captura, preparação, reconhecimento e apresentação do texto. Vimos também um limite desse percurso: nenhuma etapa recupera com segurança uma palavra que a gravação não preservou. Agora vamos examinar por que a evidência acústica pode chegar comprometida ao ASR.
Ao final, você deverá conseguir ouvir ou descrever uma gravação problemática e distinguir os efeitos de ruído, reverberação, distância do microfone e falhas de gravação. Esse diagnóstico ajuda a decidir o que pode ser melhorado na captação e o que exige conferência cuidadosa da transcrição de uma sessão.
Ruído: quando outro som disputa espaço com a fala
Para transcrever, o ASR precisa encontrar padrões da fala no sinal recebido. Ruído é, nesse contexto, um som indesejado para a tarefa: ventilação, manuseio de papéis, batidas na mesa ou uma conversa ao fundo. Uma segunda voz não é “ruído” em todos os usos possíveis da gravação, mas pode funcionar como interferência quando o objetivo é transcrever uma fala específica.
O efeito depende menos da simples presença de um som e mais de quanto ele encobre a fala relevante. Um ventilador discreto pode causar pouco problema; uma batida que coincida com uma palavra decisiva pode tornar aquele instante difícil de reconhecer. Sons que ocupam frequências semelhantes às de partes da fala podem mascará-las. As consoantes, frequentemente menos intensas que as vogais, são particularmente vulneráveis. Uma frase pode continuar parecendo audível como um todo, enquanto a distinção entre duas palavras se perde.
Assista aos dois trechos selecionados de Ensuring speech intelligibility with proper audio techniques, do canal DPA Microphones A/S. O vídeo está em inglês; acompanhe sobretudo as demonstrações e as relações entre os sons, sem precisar memorizar frequências ou valores em decibéis.
Ensuring speech intelligibility with proper audio techniques
O vídeo mostra por que uma voz aparentemente alta pode continuar pouco inteligível e como a posição do microfone altera o que é captado.
Em vogais e consoantes, observe a explicação de como ruído e reverberação podem encobrir consoantes. Depois, em distância do microfone, compare a captação próxima à boca com posições mais afastadas; o ponto importante é a diferença entre a intensidade da voz desejada e a dos sons do ambiente, não os números específicos apresentados.
Essa relação é chamada relação sinal-ruído: “sinal” é a fala que queremos captar; “ruído”, a interferência. A imagem resume a estratégia de captação mais comum.
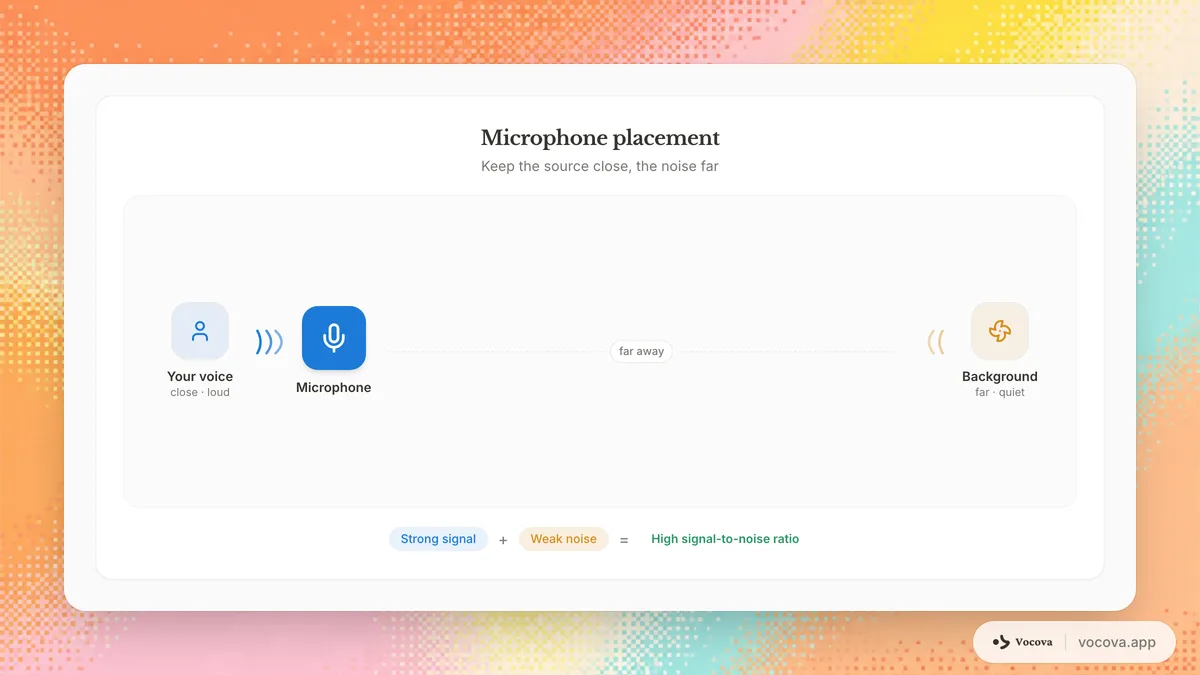
A proximidade ajuda se o microfone fica perto de quem fala sem se aproximar igualmente da fonte de ruído. Não é uma garantia: posicioná-lo junto a um ventilador, por exemplo, pode piorar a captação. E aumentar o volume depois da gravação amplifica tanto a voz quanto o ruído já registrado; não desfaz, por si só, o mascaramento.
Reverberação: quando o som anterior invade o seguinte
Ruído e reverberação podem produzir a mesma impressão geral de “áudio ruim”, mas têm causas distintas. A reverberação resulta das reflexões do som nas superfícies de um ambiente. Em vez de chegar ao microfone apenas pelo caminho direto, parte da voz chega novamente, com pequenos atrasos. Em uma sala muito reverberante, o final de um som pode se prolongar sobre o próximo.
Leia a comparação apresentada em Enhancing Speech Quality and Music Experience with Reverberation Control Technology, da NTT Technical Review. O artigo trata de técnicas especializadas, mas aqui interessa apenas sua explicação física da reverberação.
Leia para visualizar por que a reverberação dificulta a distinção entre sons sucessivos da fala, sem estudar a técnica de correção proposta pelo artigo.
Na seção 2, “Innovative audio signal processing technology: Reverberation control technology”, localize a subseção 2.2, “Key principle of our reverberation control technology”. Comece quando o texto anuncia o princípio ilustrado na Fig. 2 e leia a comparação até a descrição de como, no ambiente com reflexões, o som anterior se sobrepõe ao seguinte. Concentre-se no contraste entre os dois ambientes; não é necessário acompanhar a explicação posterior sobre separação de sinais.
Em uma sessão realizada numa sala ampla, um microfone distante pode registrar menos da voz direta e proporcionalmente mais som refletido. Nesse caso, falar mais alto ou elevar o volume do arquivo não elimina a sobreposição temporal. A gravação pode soar “espacial” ou apresentar uma espécie de cauda após as palavras, ao mesmo tempo que limites entre sílabas ficam menos nítidos para o ASR.
Um eco perceptível como repetição separada da fala é uma manifestação de reflexão com atraso mais evidente; reverberação é o acúmulo de reflexões que tende a se fundir ao som. Para o diagnóstico, a distinção útil é que ambos envolvem som refletido, enquanto uma batida de mesa ou uma voz concorrente é uma fonte adicional de som. Em uma gravação real, esses problemas podem coexistir.
Distância do microfone não é sinônimo de volume baixo
Suponha que, numa audiência, o microfone esteja ao centro de uma mesa e uma pessoa fale da outra extremidade. Sua voz pode chegar fraca. Se o volume de entrada for elevado para compensar, as cadeiras, o ar-condicionado e as demais vozes também poderão ficar mais presentes. A distância muda, portanto, a composição do sinal captado, não apenas o número que aparece no controle de volume.
Ela também pode aumentar a participação relativa da reverberação: a fala direta perde força enquanto reflexões da sala continuam chegando ao microfone. Por isso, duas gravações ajustadas para tocar no mesmo volume podem oferecer evidências muito diferentes ao ASR. A primeira, feita com microfone bem posicionado, pode preservar consoantes; a segunda, captada de longe e amplificada, pode apenas apresentar fala e interferências mais altas juntas.
A recomendação prática é buscar uma posição próxima e apropriada à pessoa que fala, com ajuste que evite sobrecarga. Próximo não significa encostado nem com ganho máximo. Sons de sopro, contato com o microfone ou intensidade excessiva também podem prejudicar o registro. Em ambientes com vários microfones, vale identificar qual deles efetivamente captou cada intervenção antes de concluir que o reconhecimento falhou por causa do modelo.
Qualidade da gravação: o que o arquivo preservou?
Além da acústica da sala, há problemas na cadeia de gravação. O sinal pode ter sido captado adequadamente e, ainda assim, chegar comprometido ao ASR por distorção, interrupções ou tratamento inadequado. Três situações merecem atenção:
- Saturação (clipping): o nível de entrada ultrapassa o que a gravação comporta, produzindo distorção. Reduzir o volume do arquivo depois não recompõe os trechos deformados.
- Falhas ou cortes: uma interrupção na gravação pode eliminar parte de uma palavra ou de uma intervenção. O ASR pode tentar produzir um texto plausível, mas plausibilidade não prova o que estava no trecho ausente.
- Codificação e processamento inadequados: compressão com perdas e algumas formas de redução de ruído podem retirar ou alterar pistas úteis da fala. Converter depois o arquivo para um formato sem perdas não restaura o conteúdo já perdido.
As propriedades digitais vistas anteriormente — amostragem, canais e compressão — devem ser interpretadas junto com essas condições. Um arquivo com especificações elevadas não compensa um microfone distante ou um sinal saturado. Da mesma forma, se canais diferentes preservam captações distintas, misturá-los sem exame pode dificultar a escuta de uma fala que estava mais clara em um deles.
A documentação Best practices, do Google Cloud Speech-to-Text, oferece orientações de captura para um serviço de ASR. Leia-as como recomendações contextualizadas, não como regras universais para todo equipamento ou modelo.
Best practices | Cloud Speech-to-Text | Google Cloud Documentation
Leia para relacionar posicionamento do microfone, saturação e processamento prévio à precisão do reconhecimento.
Na seção “Audio preprocessing”, depois das subseções “Sampling rate” e “Frame size”, comece no parágrafo que recomenda fornecer áudio tão limpo quanto possível. Leia as orientações até a instrução de escutar amostras e verificar se há distorção ou ruídos inesperados; pare antes de “Request configuration”. Observe especialmente por que a documentação recomenda evitar clipping e desaconselha, para esse serviço, certos processamentos automáticos antes do envio.
Há uma nuance importante para provas e para decisões operacionais: reduzir ruído não é automaticamente melhorar o áudio para ASR. Um processamento agressivo pode apagar junto uma consoante ou produzir artefatos. A documentação lida refere-se a um serviço concebido para lidar com certo grau de ruído; outros sistemas e outras gravações podem responder de modo diferente. Se houver possibilidade de tratamento, o procedimento prudente é preservar o original, comparar trechos e verificar o resultado, em vez de supor que todo filtro ajuda ou que nenhum filtro pode ajudar.
Um diagnóstico orientado pela evidência
Imagine que uma transcrição automática traga “o parecer foi aprovado”, mas deixe incerto o número de votos pronunciado logo depois. Antes de atribuir a falha ao ASR, localize o trecho correspondente no áudio original e pergunte que tipo de informação está faltando.
Se uma batida coincide exatamente com o número, há indício de mascaramento por ruído transitório. Se toda a fala parece distante, com sons da sala proeminentes, investigue posicionamento do microfone e relação sinal-ruído. Se as palavras se prolongam umas sobre as outras, sobretudo em trechos mais rápidos, considere reverberação. Se a voz soa áspera nos momentos fortes ou há um silêncio abrupto no meio da intervenção, verifique saturação ou falha de gravação. Nada impede que haja mais de uma causa.
Em termos operacionais, o diagnóstico segue uma ordem simples:
- Ouça o original no ponto da divergência, preservando-o como referência. Examine também outros canais, se existirem.
- Descreva o sintoma audível — interferência localizada, som refletido, voz distante, distorção ou corte — antes de escolher uma explicação.
- Relacione sintoma e causa provável, sem afirmar certeza quando o áudio não permite distingui-las.
- Separe prevenção de correção posterior: reposicionar o microfone e ajustar a captação ajudam numa próxima sessão; tratar um arquivo já gravado pode facilitar sua análise, mas não garante recuperar o que se perdeu.
Esse cuidado é particularmente importante quando uma palavra muda o sentido documental de uma fala. Se o número de votos não é distinguível no registro, a versão textual não deve apresentar como confirmado um número escolhido apenas pelo contexto.
Para questões de certo ou errado, desconfie de afirmações que eliminam essas distinções:
- “Basta aumentar o volume de uma gravação distante para obter a mesma qualidade de um microfone próximo.” Errado: ruído e reverberação registrados também permanecem.
- “Reverberação e ruído de fundo são o mesmo fenômeno.” Errado: uma envolve reflexões da própria fala; o outro pode vir de fontes concorrentes.
- “Converter um áudio já deteriorado para um formato sem perdas recupera a fala eliminada.” Errado: a conversão não recria informação ausente.
- “Uma falha de transcrição pode ter mais de uma causa acústica ou técnica.” Certo: causas podem atuar simultaneamente, e a comparação com o original é indispensável.
Em síntese
Ruído pode encobrir trechos da fala; reverberação prolonga sons e dificulta distinguir sua sequência; distância do microfone tende a enfraquecer a voz direta em relação ao ambiente; e falhas de gravação podem distorcer ou eliminar informação. O bom diagnóstico identifica o sintoma no áudio original, considera causas concorrentes e não confunde melhoria de apresentação sonora com recuperação garantida da fala.
Na próxima lição, passaremos do áudio à saída textual: veremos como identificar os tipos de erro que aparecem quando o ASR troca, acrescenta ou deixa de registrar palavras.