你好。上一课我们建立了数据并行的基本不变量:各 DP rank 复制参数与优化器状态,处理不同数据,并通过梯度 AllReduce 在更新前恢复一致性。它的瓶颈也很清楚:即使 MoE 每个 token 只激活 Top-16 专家,训练状态仍须保存全部专家参数;纯 DDP 会在每个 rank 上复制这些状态。
这一课讨论 ZeRO 与 FSDP 如何改变这一点。目标不是记住几个“stage”名称,而是能回答架构评审中最关键的三件事:
- 某一阶段究竟分片了参数、梯度、主权重和 Adam 状态中的哪些部分;
- 一个 FSDP 单元在前向、反向和更新时何时短暂拥有完整参数;
- 内存节省换来了哪些 AllGather、ReduceScatter,以及这些通信何时会暴露为 step 的尾部时间。
1. 从“复制训练状态”转向“分片状态、按需物化”
先统一一个简化但实用的状态模型。令某个逻辑模型副本含有 个参数,采用常见的 BF16 计算与 FP32 AdamW 更新配置:
| 状态 | 每参数字节数 | 说明 |
|---|---|---|
| BF16 计算权重 | 2 | 前向、反向使用 |
| BF16 梯度 | 2 | 反向产生 |
| FP32 主权重 | 4 | 优化器更新的高精度副本 |
| Adam 一阶、二阶矩 | 8 | 两个 FP32 状态 |
| 合计 | 16 | 仅模型状态,不含激活与临时缓冲 |
因此,纯 DDP 的每个 rank 都持有:
ZeRO 的核心不是把模型变成流水线模型,也不是改变数据并行的数学语义。每个 rank 仍处理不同数据;区别是:同一个 DP 组不再让每个 rank 永久保存每一份训练状态。
先通过视频建立 FSDP 的动态直觉。
Too Big to Train: Large model training in PyTorch with Fully Sharded Data Parallel
观看 Sharcnet HPC 的 “Too Big to Train: Large model training in PyTorch with Fully Sharded Data Parallel”。它用一次前向和反向的时间顺序解释了:完整参数何时出现、何时释放,以及为什么梯度自然适合做分片归约。
观看 FSDP 执行流程。重点辨认三个动作:计算前的参数 AllGather、计算后释放完整参数,以及反向中把梯度归约到各自 owner 的 ReduceScatter。
这里的“owner”非常重要。假设 FSDP/ZeRO 组大小为 ,将状态按参数范围均匀切成 片。对于某一参数区间:
- 一个 rank 是该区间的持久 owner,保存其参数分片及对应优化器状态;
- 所有 rank 在计算该层时都需要完整权重,因此短暂地拿到它;
- 反向后,只有 owner 保留该区间的已归约梯度并更新对应参数分片。
换句话说,FSDP 的全称 “Fully Sharded Data Parallel” 容易让人误解成“模型只在一张卡计算”。实际上,FSDP 仍是数据并行:每个 rank 都执行同一层的计算,只是完整参数不常驻。
2. ZeRO 三个阶段:究竟省掉了什么
ZeRO 的三个经典阶段可视为逐步移除 DDP 中冗余复制的训练状态。以下公式采用上面的 bytes/parameter 示例,目的是比较数量级;实际系统必须按真实 dtype、优化器和临时 buffer 重算。
ZeRO: Memory Optimizations Toward Training Trillion ...
阅读 ZeRO 原始论文中关于状态内存、三阶段分片和通信量的部分。它将“状态分片为什么有效”与“为何 Stage 3 会增加通信”放在同一个模型中分析。
先读 Section III “WHERE DID ALL THE MEMORY GO?”,确认参数以外还有梯度、优化器状态、激活和临时 buffer。随后在 Section V “DEEP DIVE INTO ZeRO-DP” 连续阅读 Pos、Pg、Pp 三个小节;作者在 三阶段定义 后分别展开其内存含义。特别关注 Pg 小节中 梯度分片 的说明。最后阅读 Section VII 的 A、B 两部分,并留意作者指出 反向再次聚合 参数这一事实。
ZeRO Stage 1:只分片优化器状态
Stage 1 将 FP32 主权重、Adam 的一阶矩和二阶矩分给不同 rank。参数与梯度仍以完整副本形式存在。
其中 是复制的 BF16 参数和梯度; 是分片的 FP32 主权重与两个 Adam 矩。
它的局限很直接:即使 很大,仍有近 bytes/parameter 的复制状态。因此 Stage 1 主要缓解“Adam 状态特别大”的问题,不能解决超大模型的主内存问题。
ZeRO Stage 2:再分片梯度
Stage 2 在 Stage 1 的基础上,将梯度也分片。反向中不再要求每个 rank 持有完整的最终同步梯度,而是将梯度直接 ReduceScatter 到参数 owner。
现在只有 BF16 参数仍是完整副本;梯度、主权重和 Adam 状态都按 分片。由于完整参数依旧常驻,前向不需要按层 AllGather 参数。
从通信角度看,经典 ZeRO-2 可以把 DDP 的梯度 AllReduce 分解为:
- 对梯度执行 ReduceScatter,让每个 owner 得到其参数片段的全局梯度;
- owner 完成局部优化器更新;
- 对更新后的参数执行 AllGather,使每个 rank 再次拥有完整参数副本。
在相同 dtype 假设下,ReduceScatter 加 AllGather 的总字节量与 AllReduce 的两个阶段相近。因此,ZeRO-2 的关键价值是:显著减少状态内存,却不必像 Stage 3 一样在每个层的前向和反向都重新取参数。
ZeRO Stage 3:再分片参数
Stage 3 将参数本身也分片:
这就是“fully sharded”的含义:在两次计算之间,每个 rank 只持有 的参数、梯度、主权重与优化器状态。
代价是:某层开始计算时,所有 rank 都必须临时重建该层的完整参数。FSDP 是 PyTorch 中对这种执行方式的主要实现。
以一个仅用于数量级判断的例子说明。若把 5T 参数视为单一 FSDP 逻辑模型,并假设 :
| 方案 | 每 rank 的理论模型状态 |
|---|---|
| DDP | |
| ZeRO-1 | 约 |
| ZeRO-2 | 约 |
| ZeRO-3 | 约 |
这个表不是 5T MoE 的部署方案,而是一个警示:
- Stage 3 让“持久模型状态”开始接近单设备可讨论的范围;
- 但它没有包含激活、通信 buffer、完整参数物化峰值、MoE token 重排 buffer 或 128k 上下文的状态;
- 真正系统中, 还会先被 TP、PP、EP 等模型并行维度切分,FSDP 通常作用于某个模型并行副本内部的 DP 组,而不是简单让全部设备组成一个 FSDP 组。
3. FSDP 的参数物化时间线
FSDP 将模型划成多个 FSDP 单元。实践中,一个单元常对应一个 Transformer block、若干较小子模块,或在 MoE 中对应经过仔细设计的专家/共享层组合;它不应粗暴地等同于“整个模型”。
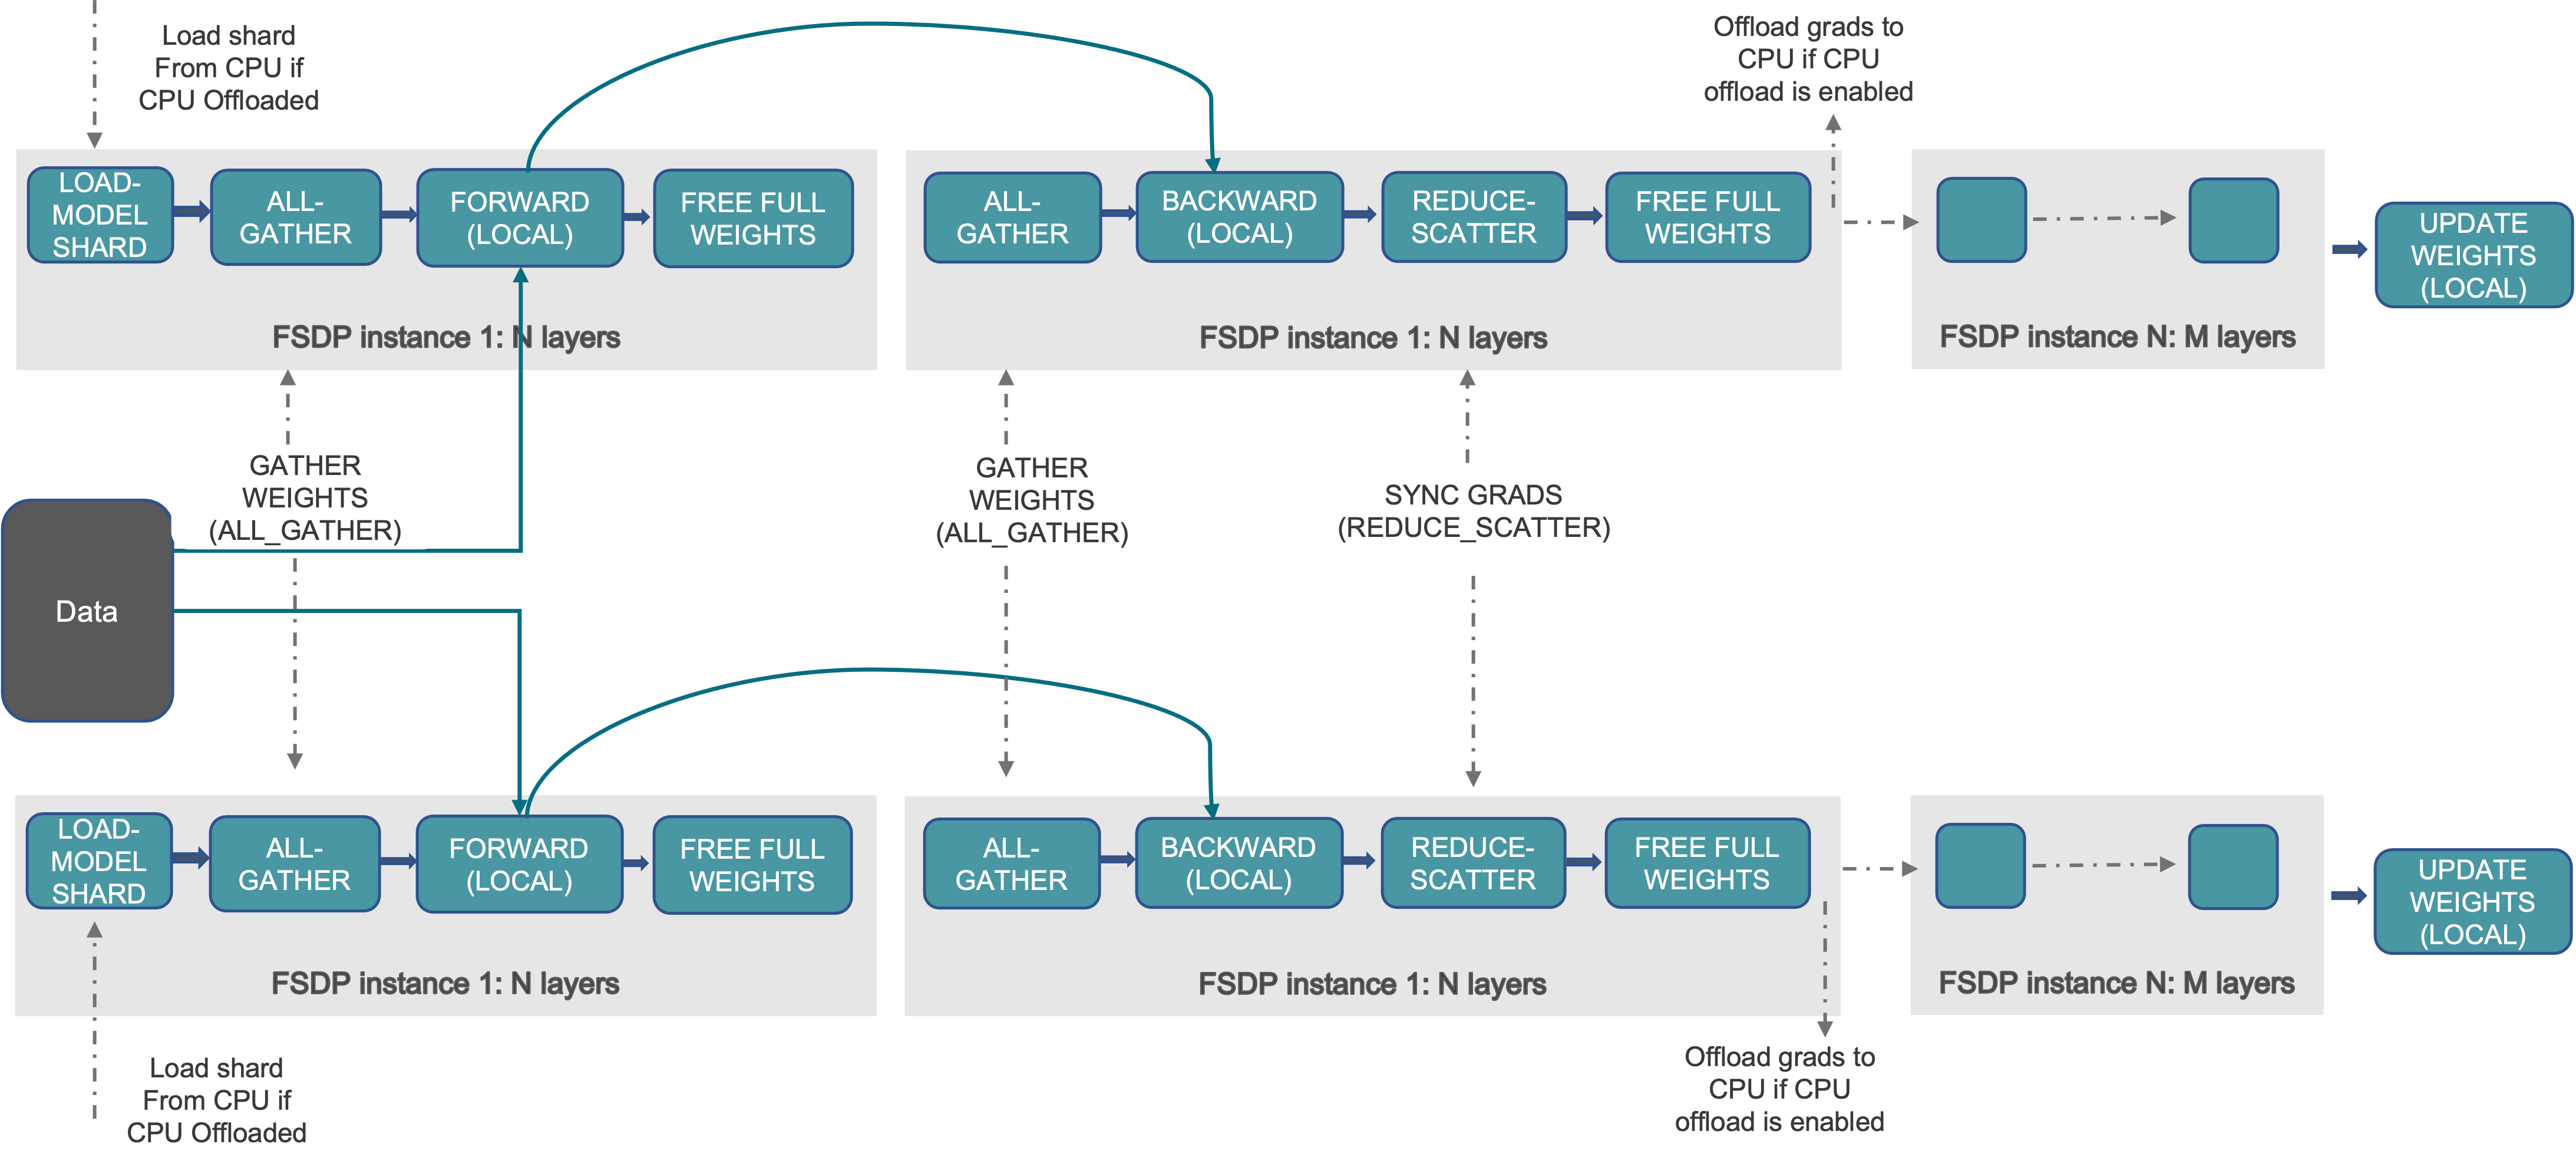
对一个参数量为 的 FSDP 单元,完整训练迭代可按下列顺序理解。
前向:取来完整权重,计算后尽快释放
- 每个 rank 初始仅保存该单元的参数分片;
- 所有 rank 进行 AllGather,物化完整参数;
- 每个 rank 使用相同完整参数、不同本地数据执行前向;
- 保存必要激活;
- 若采用 full shard,立即释放该单元的完整参数,只留下本 rank 的分片。
反向:再次物化,然后分片归约梯度
反向按层的逆序执行。对同一单元:
- 再次 AllGather 完整参数;
- 根据保存或重算的激活执行局部反向;
- 每个 rank 得到局部梯度;
- ReduceScatter 将全局归约后的梯度片段送到对应 owner;
- 释放完整参数与非本地梯度;
- owner 用本地梯度分片更新参数分片和优化器状态。
因此,FSDP Stage 3 的关键不是“没有完整参数”,而是:
完整参数只在一个小的计算窗口中存在;持久存在的是分片状态。
官方 FSDP2 教程用这一语言明确描述了这种差别。
Getting Started with Fully Sharded Data Parallel (FSDP2)
阅读 PyTorch 官方 FSDP2 教程。它将 DDP 的梯度同步与 FSDP 的参数按需物化并列展示,并说明 prefetch 如何尝试隐藏 AllGather。
在 “How FSDP2 works” 中,从比较 DDP 和 FSDP 的段落开始,阅读 基本工作流,对照本课中的前向、反向和更新时间线。然后进入 “Implicit Prefetching” 小节,阅读 预取逻辑。注意教程的核心条件:只有下一单元的 AllGather 能在当前单元计算期间发起并完成,通信才能被隐藏。
FSDP 的峰值内存不应只写成 。对一个 FSDP 单元,更接近实际的表达是:
其中:
- :接近全模型状态的 ;
- :当前正在物化的完整参数,大小由 wrap 粒度决定;
- :长序列训练中往往比参数物化更危险;
- :AllGather、ReduceScatter 的融合 bucket 和工作区;
- :GEMM、注意力、路由及 allocator 碎片等开销。
这解释了为什么 FSDP 单元不能无限大:单元太大,单次 AllGather 更高效,却可能使完整参数峰值直接 OOM;单元太小,峰值低,却增加 collective 次数与 启动开销。
4. 通信量:Stage 3 为什么是低带宽平台的重点风险
令一个训练 step 中需要经过 FSDP 的全部参数元素数为 ,FSDP 组大小为 。忽略算法常数和层次拓扑时,ring 类实现中一次 AllGather 或 ReduceScatter 的每-rank 数据移动量近似为:
若所有通信都采用相同精度,DDP 的一次梯度 AllReduce 可以看作:
其总传输量近似为:
而 full-shard FSDP 的每步包含:
- 前向前的参数 AllGather;
- 反向前的参数 AllGather;
- 反向后的梯度 ReduceScatter。
于是:
这就是经典结论:在同 dtype、忽略小消息开销的简化模型下,ZeRO-3/FSDP 的总通信量约为 DDP 的 倍。
但对目标 ASIC,不能只报“1.5 倍”就结束分析。每个 collective 的时间还近似为:
其中 是该次 collective 的字节数, 是启动与同步成本, 是每字节传输时间。FSDP 将少量大通信拆成了大量与模块边界绑定的通信,因此同时面对两类风险:
- 带宽风险:低带宽互联使 变大;尤其是两次参数 AllGather 都必须供计算使用。
- 启动延迟风险:wrap 过细会使 collective 数量增多, 反复出现。
- 依赖风险:某一层的前向依赖该层参数;若 AllGather 没有及时完成,计算无法继续。
- 尾部风险:最后一个或最早暴露的 AllGather 通常缺少可重叠计算,是优化优先级最高的通信之一。
dtype 会改变“通信量等价”的结论
不要把“每次都传 个元素”误读为“每次都传相同字节数”。设参数 AllGather 使用 bytes/element,梯度 ReduceScatter 使用 bytes/element,则:
例如参数以 BF16 聚合而梯度以 FP32 归约时,两个参数 AllGather 各按 bytes/element 计,ReduceScatter 按 bytes/element 计。此时通信策略、数值精度和互联需求不能分开评估。
这也是后续为 BF16/FP8 平台制定精度映射时,必须分别记录以下字段的原因:
- 参数持久存储 dtype;
- 参数 AllGather dtype;
- 局部梯度生成 dtype;
- ReduceScatter 的归约 dtype;
- optimizer state dtype;
- collective 通信 buffer 的实际字节数。
5. 重要策略:用内存换通信,还是用通信换内存
FSDP2 中最重要的一个开关是 reshard_after_forward,它对应两种不同的时间行为。
| 策略 | 前向后完整参数 | 反向前是否需要再 AllGather | 主要取舍 |
|---|---|---|---|
FULL_SHARD |
立即释放 | 需要 | 最低参数峰值,通信更多 |
SHARD_GRAD_OP 风格 |
保留到反向 | 通常不需要 | 较高参数峰值,减少一次参数聚合 |
| Hybrid sharding | 组内分片、组间复制 | 取决于 mesh 与实现 | 用节点内高速互联换取较少跨节点通信 |
SHARD_GRAD_OP 风格与 ZeRO-2 有相近的时间特征:参数在更长时间内以完整形式存在,因此节省了反向前再次取权重的需要。但它不应被简单理解为“永远等同于 ZeRO-2”;实际峰值取决于 wrap 粒度、层执行顺序和实现是否在其他时点重新分片。
对当前“大算力、低带宽”的硬件假设,策略选择应由 trace 和模型测量驱动:
- 若 full-shard 频繁暴露参数 AllGather,且设备还有足够内存余量,可测试保留参数到反向的策略;
- 若完整参数峰值与 128k 激活峰值冲突,则必须优先 full-shard、激活重计算和更细的单元边界;
- 若节点内互联显著快于跨机互联,hybrid sharding 可能将高频参数物化限制在节点内,但它会引入二维通信组和额外复制,需后续结合实际拓扑建模;
- prefetch 可以隐藏通信,但预取多个单元会同时增加完整参数驻留量,不能把“更多预取”当成免费性能。
FSDP 并不解决激活内存。对 128k 上下文,状态分片通常只是必要条件;上下文并行、序列并行、注意力实现与激活重计算仍将决定可训练的实际 batch。
6. 面向训练框架的最小验证记录
在 8 卡与 32/64 卡验证中,不要只记录“启用了 FSDP”。每个实验至少应写清:
| 类别 | 应记录的内容 |
|---|---|
| 分片语义 | FSDP 组成员、组大小、与 TP/PP/EP/CP 的关系 |
| wrap 边界 | 每个 FSDP 单元包含哪些模块、参数量与最大完整参数字节数 |
| 状态精度 | 参数、梯度、主权重、Adam 状态、通信 buffer 的 dtype |
| 内存峰值 | 持久分片、完整参数物化、激活、通信工作区与临时 buffer 的分项 |
| 通信 trace | AllGather/ReduceScatter 次数、消息大小、开始时间、结束时间与重叠比例 |
| 正确性 | 分片与非分片的小模型 loss、梯度范数、参数更新及 checkpoint 恢复一致性 |
| 稳态性能 | step 时间、暴露通信尾部、MFU/HFU、通信占比与 OOM 余量 |
尤其对新 ASIC,验收不应写成“支持 AllGather 和 ReduceScatter”。更可操作的表述是:在指定 group size、指定消息范围、指定并发通信和指定 dtype 下,collective 的有效带宽、启动延迟、异步进度能力,以及与计算流的重叠比例是否达到目标。
小结
ZeRO/FSDP 改变的是数据并行中训练状态的存放方式,而不是“不同 rank 处理不同数据、通过全局梯度保持同一更新”的基本语义。
- ZeRO-1 分片优化器状态,仍复制参数与梯度;
- ZeRO-2 再分片梯度,通常以 ReduceScatter 梯度、AllGather 更新参数替代 DDP 的 AllReduce;
- ZeRO-3/FSDP full shard 连参数也分片,持久状态近似按 缩小,但每个单元的前向和反向都要按需 AllGather 参数;
- full-shard 的通信量在简化同精度模型下约为 DDP 的 倍,且更容易受模块粒度、启动延迟和通信暴露影响;
- 对 5T MoE,FSDP 能消除大量状态复制,但不会消除全部专家的训练状态,也不会自动解决长上下文激活内存。
下一课将进入张量并行:我们会分析典型线性层如何按输出或输入维度切分,以及这些切分为何会在每层引入不同形态的 activation collective。