你好。上一课我们用 - 模型把 collective 通信拆成启动延迟、有效带宽、算法和拓扑四个因素。这一课把其中最常见的 collective——梯度 AllReduce——放回训练循环,建立数据并行(Data Parallelism, DP)的语义模型。
对后续的 5T MoE 系统,数据并行并不意味着“每张 ASIC 都放一份 5T 模型”。在纯 DDP 中确实如此,但那在内存上不可行。实际系统会先用张量、流水线、专家和上下文并行构成一个模型并行副本,再用 DP 复制这个副本以处理不同数据。无论是哪种情况,DP 的核心不变:复制的参数必须看到同一个全局梯度,并执行同一个优化器更新。
本课结束时,你应能准确说明:
- DP 中什么被复制、什么被分片;
- 为什么梯度平均等价于在全局 batch 上求平均梯度;
- 全局 batch 应按哪个并行维度计算;
- 为什么 DDP 不需要在每一步广播参数;
- 梯度累积、loss reduction、梯度裁剪和优化器状态如何影响“数学等价性”。
1. 数据并行维护的基本不变量
先把术语固定下来。设一个数据并行组有 个 rank。每个 rank 都持有同一组可训练参数 ,但每个 rank 处理不同的本地数据 batch 。
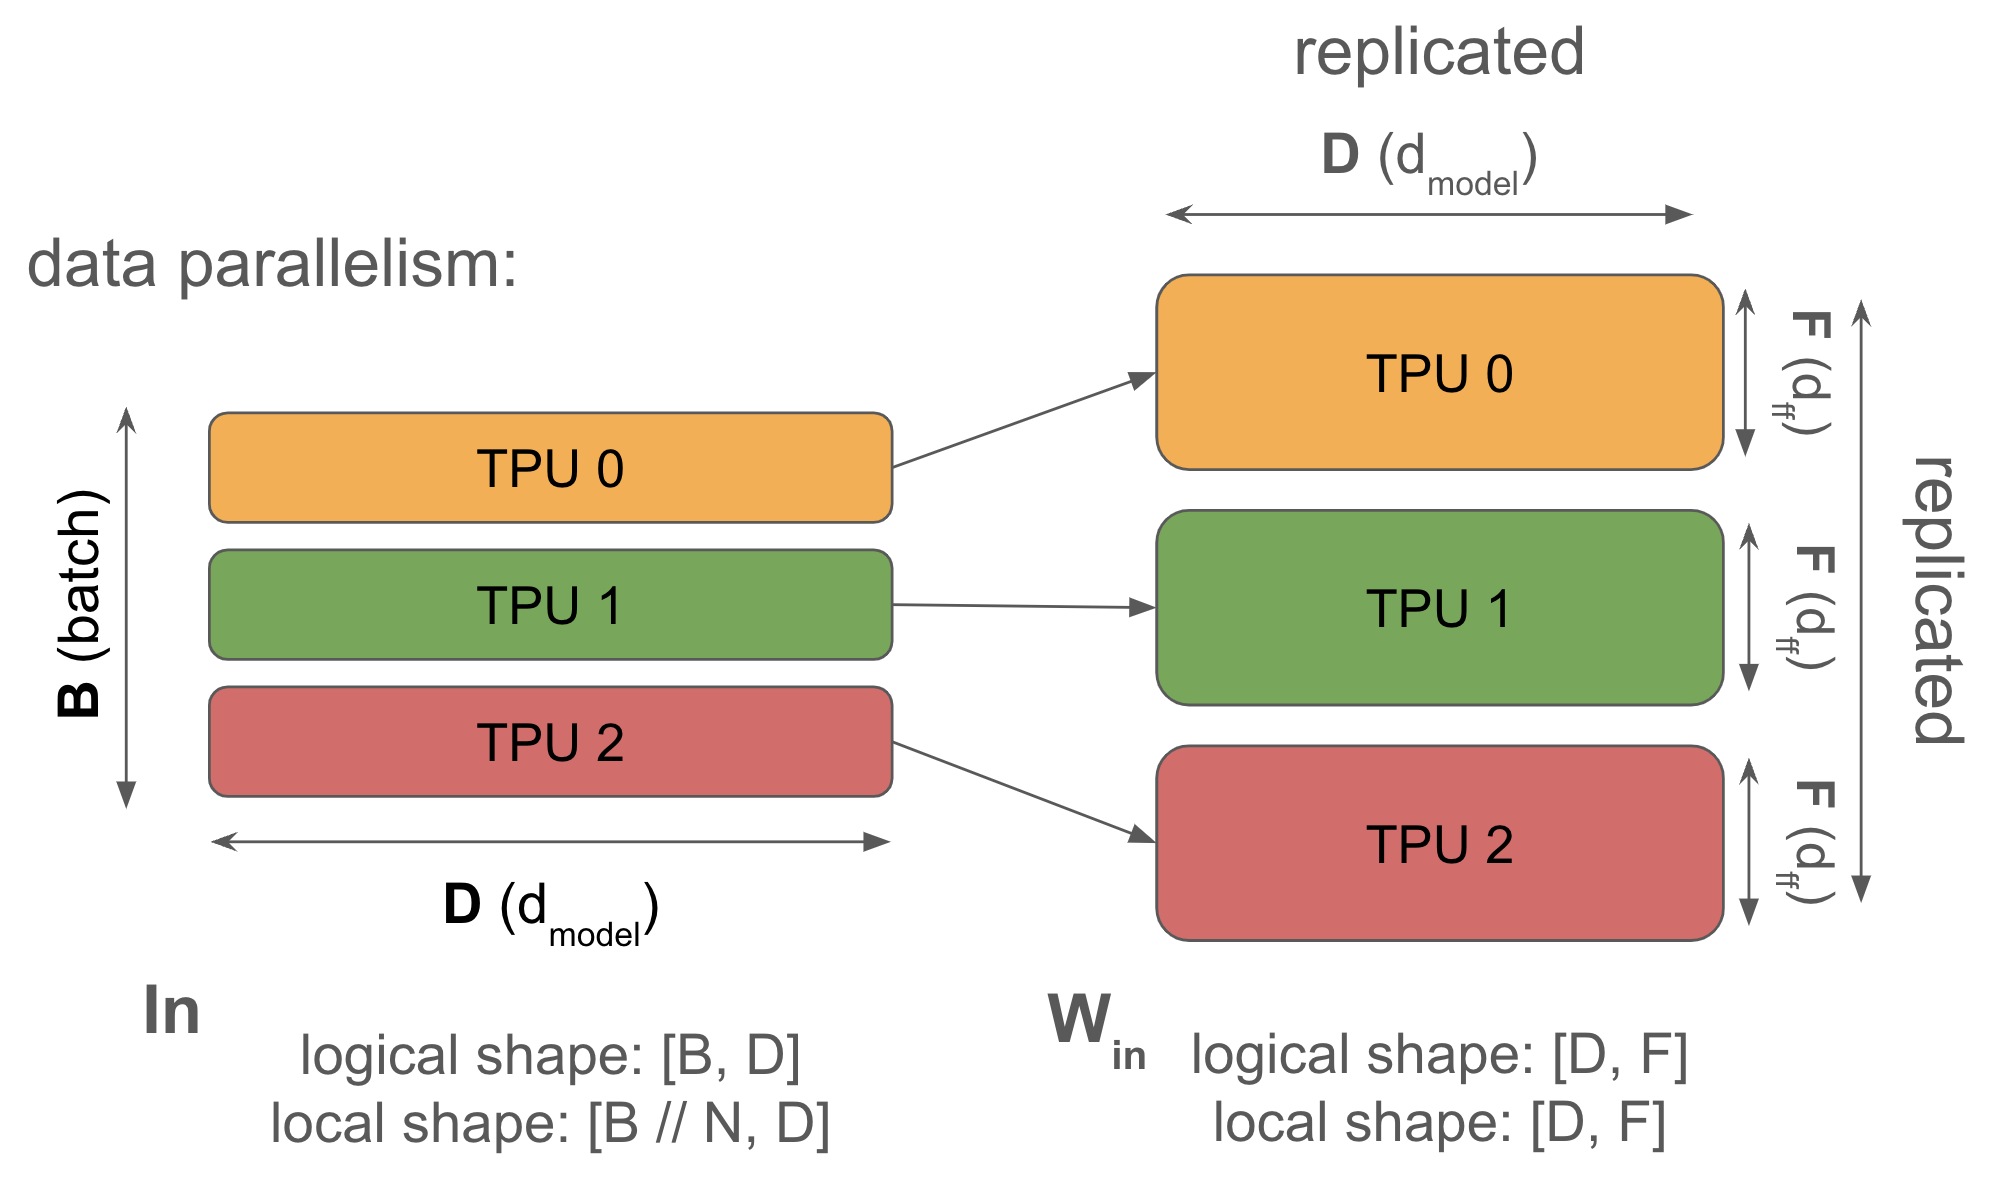
这张图中,左侧输入张量的逻辑形状为 ,其中:
- :batch 维度,按设备数切分;
- :模型隐藏维度,不因数据并行而切分;
- 每张设备本地得到约 的输入。
右侧权重矩阵 在每个 rank 上复制。于是,纯 DP 的状态关系可以概括为:
| 对象 | 在 DP rank 间的关系 | 原因 |
|---|---|---|
| 输入样本、prompt、训练序列 | 分片 | 否则会做重复计算 |
| 模型参数 | 复制 | 每个 rank 都要独立执行完整前向和反向 |
| 梯度 | 先局部产生,后同步 | 本地样本不同,因此局部梯度不同 |
| 优化器状态 | 复制 | 每个 rank 都执行同一优化器更新 |
| 激活 | 本地 | 只服务本 rank 的前反向 |
| 随机数状态 | 可以不同 | dropout 等随机操作服务于本地样本;关键是最终更新一致 |
所谓“数据并行正确”,不是指每张卡算出的局部 loss 相同;它们通常不同。它要求的是下面这个不变量:
每个 optimizer step 开始时,各 rank 的参数和优化器状态一致;每个 step 结束时,它们仍然一致。
为维持这个不变量,关键不是在更新后反复同步参数,而是在更新前同步梯度。
Part 2: What is Distributed Data Parallel (DDP)
观看 PyTorch 官方的 Part 2: What is Distributed Data Parallel (DDP),它用很短的动画串起“模型复制—数据分片—梯度同步—一致更新”的完整因果链。
先看 副本与数据:注意每个设备各有一个模型和优化器副本,但 DistributedSampler 让它们得到不同输入。再看 梯度同步,重点理解:若不同步就会形成多个发散模型;bucketed AllReduce 则让通信与反向传播重叠。
这里有一个容易混淆的边界:**DDP 不会自动替你切分输入。**它负责梯度同步;数据加载器、sampler 或上层 RL 数据服务必须确保各 DP rank 获得正确的数据分片。
阅读 Michael Brenndoerfer 的这篇交互式文章,建立 DDP 的端到端训练循环,并重点检查“数据分片、梯度平均和优化器更新”之间的数学关系。
先读 The Data Parallelism Problem,从 数学基础 看到将数据拆为等大小分片后,为何分片梯度的平均就是联合数据的梯度。 接着读 Distributed Data Parallel: The Algorithm 的 Step 1 至 Step 4。尤其在 Step 2,从 bucket 重叠 这一段理解通信为何不必全部落在 backward 结束后;在 Step 4,关注从 优化器更新 到小节结束的逻辑。 最后读 The DistributedSampler,通过 采样器不变量 检查“不同 rank 不应重复处理同一批样本”的要求;并读 Gradient Averaging vs. Gradient Summing,注意局部 loss 已经取平均时,DDP 的 rank 间平均为何正好得到全局 batch 的平均梯度。
2. 为什么梯度平均等价于全局 batch 训练
假设每个 rank 的本地 batch 都有相同大小 ,本地目标函数使用最常见的 mean reduction:
本地反向传播得到:
DDP 对各 rank 的梯度执行 AllReduce,再除以 DP 组大小:
代入局部梯度定义:
而全局 batch 为:
所以:
这正是“把所有数据放在一张超大设备上、对全局 batch 求 mean loss”时得到的梯度。
因此,DP 的优化语义应表述得很精确:
在各 rank 的局部 batch 等大、局部 loss 采用正确归一化、所有 rank 使用相同参数和优化器规则的前提下,梯度平均等价于对一个更大的全局 batch 执行一次单机训练更新。
这不等于“扩到更多设备后训练轨迹与原单卡、小 batch 训练完全一样”。全局 batch 变大后,梯度噪声、每个 token 对应的更新次数、学习率和调度器行为都会变化。它只保证:当前这一次更新所用梯度,是该全局 batch 的正确平均梯度。
不等大小 batch:平均 rank 不一定等于平均样本
上面的推导依赖每个 rank 有相同数量的有效样本。若 rank 有 个样本,直接平均每个 rank 的局部 mean gradient:
这给每个 rank 相同权重,而不是给每个 样本 相同权重。它一般不等于真正的全局样本平均:
在语言模型和 RL 后训练中,更应关注的是有效 token 数,而不只是序列条数。例如:
- 有的样本生成 64 个有效 response token;
- 有的样本生成 2,000 个有效 response token;
- prompt、padding、EOS 之后的位置,是否进入损失由 mask 决定;
- PPO/GRPO 中可能只有 response token 参与策略损失。
此时应明确你的目标是“每序列等权”还是“每有效 token 等权”。如果目标是后者,必须按全局有效 token 数做正确归一化,而不是默认认为“每卡放同样多条序列”就已经等权。
3. 一个 DDP step 中究竟发生了什么
一个标准 DDP 训练 step 可以按以下顺序理解。
1. 初始化:建立相同起点
启动或从 checkpoint 恢复时,所有 DP rank 必须获得相同的:
- 模型参数;
- 优化器状态,例如 Adam 的一阶矩和二阶矩;
- 学习率调度器状态;
- 当前训练步数;
- 损失缩放器和数值策略的必要状态。
初始参数不一致,即使随后 AllReduce 梯度,也不能保证训练等价于一个统一模型。实践中 DDP 初始化会做必要同步;恢复检查点时,上层系统必须确保各 rank 加载的是同一个版本。
2. 数据分片和本地前向
每个 rank 从自己的 sampler 或数据队列中拿到不同 batch:
前向传播通常不需要 DP 通信。每个 rank 使用相同参数,却在不同数据上独立计算 logits、loss 和激活。
对 Transformer 而言,如果使用 LayerNorm 或 RMSNorm,通常没有 BatchNorm 那种依赖运行统计量的 buffer 同步问题;但若模型确实含有需要同步的可变 buffer,必须把其同步语义纳入设计,而不能只盯住参数和梯度。
3. 本地反向与 bucket 化梯度 AllReduce
反向传播按网络的逆序产生梯度。最后几层的梯度通常最先准备好,最前层的梯度最后准备好。
DDP 不必等待所有梯度都计算完,而是将参数梯度打包为多个 bucket:
- 某 bucket 中的梯度全部就绪;
- 通信库立即为该 bucket 启动异步 AllReduce;
- 计算继续为更早层生成梯度;
- 通信和 backward 尽可能重叠;
- 在 optimizer step 前,确保所有 bucket 都已归约完成。
这正是上一课通信模型的落点。若某个 bucket 大小为 字节,DP 组大小为 ,其 ring AllReduce 的大消息近似时间为:
但端到端 step 中真正暴露出来的不是所有 bucket 时间之和,而是无法被 backward 覆盖的尾部通信:
bucket 太小会增大 collective 次数,使 开销升高;bucket 太大则会让通信更晚启动,减少重叠机会。对新 ASIC,bucket_cap_mb 不是“越大越好”的固定常数,而是需要按模型计算时间、通信带宽、通信库异步能力和内存缓冲进行实测的参数。
DistributedDataParallel — PyTorch 2.9 documentation
阅读 PyTorch 的 DDP 官方文档,确认框架层面的职责边界:DDP 管什么、不管什么,以及 bucket 的正式配置语义。
在页面开头的说明中,读 DDP 的职责,特别注意 input 的切分仍由使用者负责,而不是 DDP 自动完成。 随后定位到两个 Note。从 参数与 buffer 行为 读到小节结束:把“每一步同步梯度”与“每一步广播参数”清楚地区分开。最后在参数列表找到 bucket_cap_mb,确认它控制的是可与 backward 重叠的梯度归约 bucket 容量。
4. 统一的梯度后处理与优化器更新
当 backward 返回且所有梯度同步完成后,每个 rank 上都应有相同的 。接下来每个 rank 独立运行相同的更新:
其中 是优化器状态。例如 AdamW 的一阶矩、二阶矩、bias correction 的步数和 weight decay 都属于更新语义的一部分。
如果各 rank 在本 step 开始时满足:
并且同步后梯度相同、更新函数相同,则更新后仍有:
因此,DDP 每一步通常不需要参数 AllGather 或参数广播。参数通信发生在初始化、恢复、显式发布或其他并行策略的特定协议中;纯 DP 的稳态训练主通信是梯度 AllReduce。
4. 全局 batch:只乘 DP 维度,不乘所有设备数
在纯 DDP 中,若每个 rank 每个 microbatch 处理 条样本,并在 个 microbatch 后做一次 optimizer step,则:
其中:
- :数据并行组大小;
- :每个 DP rank 的本地 microbatch;
- :每次更新积累的本地 microbatch 数。
在纯 DP 中, 恰好等于 world size。但对目标 5T MoE 系统,不能再把 world size 直接代入。
假设总设备被组织为:
那么每一次优化更新的全局 batch 应由 决定:
而不是:
原因是:
- TP ranks 协同计算同一批输入的不同张量分片;
- PP stages 处理的是同一批输入的不同网络阶段;
- EP ranks 接收的是同一批 token 路由后的不同专家工作;
- CP ranks 协同表示同一个长序列的不同上下文片段;
- 只有不同 DP replica 处理彼此独立的数据样本。
因此,未来在 Megatron 或其他 4D/5D 并行训练引擎中,最危险的统计错误之一就是拿全部设备数估算 global batch,从而把学习率、token 预算、调度器步数和吞吐指标全部算错。
梯度累积的语义
若目标 global batch 太大,无法让每个 DP rank 在一次前向中放下足够样本,就使用梯度累积。设每次更新累积 个本地 microbatch,正确的 mean-loss 语义通常要求:
然后对每个 microbatch 反向传播,最终再更新一次。
在 DDP 中有两种主要做法:
- 每个 microbatch 都同步梯度:语义直接,但通信发生 次;
- 前 个 microbatch 禁用同步,最后一次再同步:先在本地累加梯度,最后对累积梯度执行一次 AllReduce,能显著减少通信次数。
后一种做法必须保证 loss 除以 。否则累积梯度将是目标平均梯度的 倍,你等价于无意中把有效学习率放大 倍。
对不同有效 token 数的语言模型 batch,更稳健的表达是维护:
而不是仅按“microbatch 个数”机械平均。尤其在 rollout 长度波动很大时,必须将 token mask、token count 和 loss reduction 的定义写进训练数据契约。
5. 优化器语义:哪些操作必须在所有 rank 上一致
“所有 rank 都调用 AdamW”还不够。下面这些步骤也必须拥有一致语义:
| 操作 | 正确的 DP 位置或规则 | 错误会造成什么 |
|---|---|---|
| 梯度 AllReduce | optimizer step 前完成 | 各 rank 参数立即发散 |
| 梯度裁剪 | 对同步后的梯度执行,或实现真正的全局范数 | 各 rank 按不同局部范数裁剪,更新不一致 |
| AdamW 状态更新 | 每个 rank 使用相同梯度、step 和超参数 | moment 状态逐步漂移 |
| 学习率调度 | 按同一个全局 step 或 token 进度推进 | 相同梯度被不同学习率更新 |
| loss scaling 与溢出处理 | overflow/skip 决策必须全局一致 | 有的 rank 更新、有的 rank 跳过 |
| checkpoint 恢复 | 参数、优化器、调度器、step 一起恢复 | 即使参数相同,下一步也可能不同 |
| 随机性 | 数据和随机操作可局部不同,但控制流与更新语义必须一致 | collective 次序不匹配或模型状态分叉 |
这里的梯度裁剪很值得强调。假设某 rank 在本地梯度尚未同步时先做 clip:
然后再平均。这一般不等于先平均、后做一次全局裁剪:
前者相当于每个 rank 在优化不同的局部截断目标;后者才对应标准 global-batch 训练的裁剪语义。
mean reduction 与 sum reduction 不能混淆
最常见训练代码中,交叉熵默认按本地有效元素取 mean。此时 DDP 的梯度平均自然得到全局 mean。
但若你的损失函数返回本地 sum,局部梯度是:
DDP 再平均后得到:
它比“对全局 batch 做 sum”的梯度小 倍。此时必须明确你的优化目标:
- 若目标是全局 mean,应按全局样本数或 token 数归一化;
- 若理论上确实要用全局 sum,则需要补偿 DDP 的平均因子;
- 不要通过“调大学习率直到能跑”来掩盖 reduction 语义错误。
6. 数据并行的扩展边界:为什么 5T 系统只能把它作为一个维度
纯 DP 最直接的代价是完整训练状态复制。以此前建立的 BF16 + FP32 master weight + AdamW 状态的简化模型为例,每个参数约需:
若对 5T 总参数模型做纯数据并行,每个 rank 的模型状态理论下界约为:
这还没有包括激活、通信 bucket、临时工作区、MoE 路由缓冲区和长上下文训练所需内存。Top-16 稀疏激活会减少每 token 的专家计算量,却不会让未激活专家的参数、梯度和优化器状态自动消失。
所以,在 5T MoE 训练中,DP 的正确定位是:
- 先把一个逻辑模型副本映射到 TP、PP、EP、CP 等模型并行网格;
- 再复制这套模型并行布局形成多个 DP replica;
- 对“在不同 DP replica 上复制的同一参数分片”做梯度同步;
- 用 DP 扩展样本吞吐和 global batch,而不是试图用 DP 解决模型状态内存。
这也改变了通信建模的单位。纯 DDP 中可粗略说“整个模型梯度 AllReduce 一次”;混合并行中更准确的说法是:
每个参数分片在其对应 DP group 内执行梯度同步。
如果某个 rank 持有的复制参数分片梯度大小为 字节,其 DP ring AllReduce 的每 rank 通信量在大组规模下接近:
增加 DP 组大小不会让这个通信量按比例下降;它主要增加了每一步处理的全局数据量。于是 DP 扩展通常受两个约束同时控制:
- 统计约束:global batch 是否已经超过训练配方可接受的范围;
- 系统约束:梯度 AllReduce 是否能被 backward 充分覆盖,跨机网络是否成为尾部瓶颈。
对当前“低带宽 ASIC”假设,后者尤其需要通过 bucket 级 trace 验证,而不能只根据理论 ring 带宽下界判断。
7. 面向训练框架设计的最小 DP 契约
在设计训练引擎与 RL 编排接口时,可以为每一个训练 job 固化以下记录。它们会让“DP 正确性”从口头约定变成可验证配置。
| 类别 | 每次运行应明确记录的内容 |
|---|---|
| 并行拓扑 | DP group 大小、rank 成员、DP 与 TP/PP/EP/CP 的映射 |
| 数据语义 | 本地样本数、有效 token 数、padding 与 mask 规则、是否存在补齐或重复样本 |
| batch 语义 | local microbatch、累积次数、每 update 的 global samples 与 global valid tokens |
| loss 语义 | mean 或 sum reduction、归一化分母、RL response token 的选择规则 |
| 通信语义 | 梯度 bucket 大小、AllReduce 算法、通信组、同步与计算重叠情况 |
| 更新语义 | 梯度裁剪位置、optimizer 超参数、loss scaler、overflow 的全局处理规则 |
| 一致性验证 | 初始参数 hash、同步后梯度抽样校验、更新后参数 hash、optimizer state 校验 |
| 可恢复性 | checkpoint 的模型版本、优化器状态、调度器步数、数据进度和随机数状态 |
其中,参数 hash 不应在每一步对 5T 全模型全量计算;可以对固定抽样参数、各参数分片的校验和、优化器 step 和关键统计量做低开销监测。一旦发现某 DP rank 的状态不一致,应首先检查:
- 是否有 rank 跳过了某个 optimizer step;
- 是否存在不同的有效 token 归一化;
- 是否发生了不对称的 overflow;
- 是否有条件分支导致 collective 调用顺序或参数使用集合不同;
- 是否从不一致的 checkpoint 或权重版本恢复。
小结
数据并行的本质不是“把模型拆开”,而是:
- 复制模型和优化器状态;
- 分片输入数据;
- 对局部梯度做 AllReduce 平均;
- 在每个 rank 上执行相同更新。
在局部 batch 等大且 loss 正确归一化时:
等价于对全局 batch 的平均梯度。若有梯度累积,则全局 batch 为:
在混合并行系统中,只有 DP 维度进入这个公式;不能把 TP、PP、EP、CP 的设备数也乘进去。
纯 DP 会复制完整模型状态,因此无法直接容纳 5T 参数模型。对目标 MoE 系统,DP 将作为模型并行副本之外的吞吐扩展维度;其主要稳态通信是各参数分片在 DP group 内的梯度同步。
下一课将讨论 FSDP/ZeRO:通过分片优化器状态、梯度和参数,如何打破纯 DP 的状态复制瓶颈,以及这些内存节省为何会以 AllGather 与 ReduceScatter 通信为代价。