你好。上一课讨论了 FSDP/ZeRO:它沿数据并行组分片训练状态,以减少参数、梯度和优化器状态的常驻内存;代价是按需 AllGather 参数、ReduceScatter 梯度。
本课转向另一条正交的维度:张量并行(Tensor Parallelism,TP)。TP 不把“完整模型状态”在多个数据副本之间切开,而是把同一层中的权重矩阵和 GEMM切给多个 rank 同时执行。你将能够为一个典型 Transformer block 写出:
- 线性层按输出维或输入维分片后,每个 rank 持有的权重和激活形状;
- 前向、反向中为什么有些位置必须通信、有些位置完全不必通信;
- MLP 与注意力模块在 Megatron 风格 TP 下各有几次 AllReduce;
- 给定微批 token 数、隐藏维度、TP 度和 dtype,如何估算每层的通信字节数。
这里默认讨论经典的 Megatron 风格、隐藏维在 TP 组内复制 的布局。这是后续分析序列并行、上下文并行之前必须掌握的基线。
1. 先把“列分片”和“行分片”说清楚
设一个线性层采用数学上的右乘记法:
其中:
这里:
- :一次微批中的 token 数, 为 microbatch size, 为序列长度;
- :hidden size;
- :线性层输出维;
- :TP 组大小。
注意:不同框架中 Linear.weight 的物理存储常写成 。所以“按列分片”这个名称很容易因存储转置而混乱。本课只使用语义定义:
| 分片类型 | 数学上切分的 | 每 rank 的权重形状 | 输出布局 |
|---|---|---|---|
| 列分片 / output-parallel | 沿输出维 切分 | 每 rank 得到不同输出通道 | |
| 行分片 / input-parallel | 沿输入维 切分 | 每 rank 得到完整输出的部分和 |
因此,判断一个分片方案是否正确,不能只看代码中的 weight 是“dim 0”还是“dim 1”分片;应问两个问题:
- 每个 rank 接收的是完整输入,还是输入的一部分?
- 每个 rank 产出的是输出的一部分,还是完整输出的部分和?
为避免后面把张量形状和数值语义混为一谈,区分三种常见 activation 布局:
| 记号 | 每个 rank 所持张量 | 含义 |
|---|---|---|
| 完整 | replicated:每个 rank 都有相同的完整值 | |
| hidden 维的一段 | sharded:各 rank 持有不同维度切片 | |
| 完整形状,但只是部分贡献 | partial:形状完整,数值尚未求和 |
其中 是最容易被忽略的情况。它的 shape 已经是完整 hidden size,但数值仅代表:
真正的输出仍是:
所以它需要一次归约。
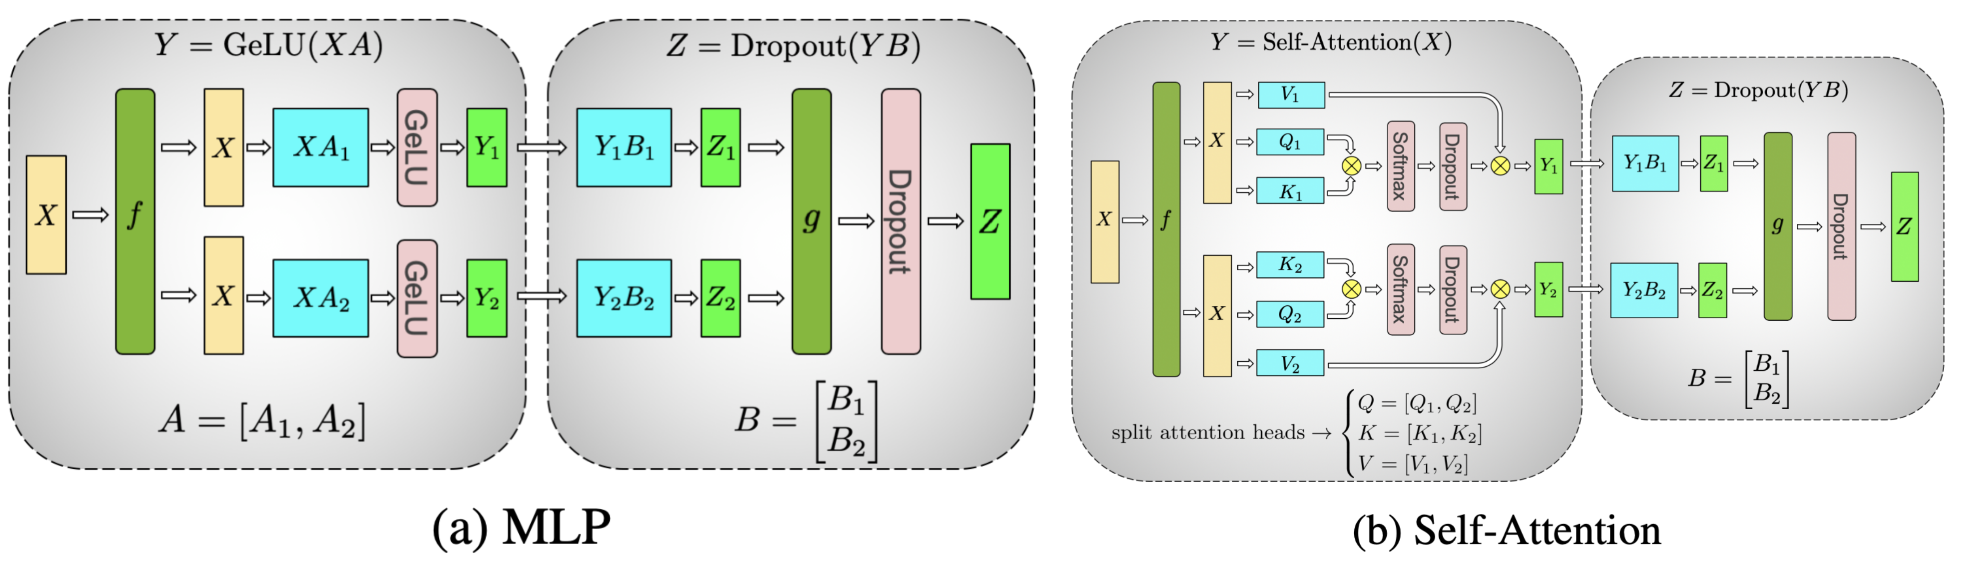
下面这张 Megatron-LM 分片图展示了这一核心配对:MLP 的第一层按输出维切、第二层按输入维切;注意力的 Q、K、V 投影按头切,输出投影按输入维切。
2. 单个线性层:前向与反向分别在哪里通信
列分片线性层:把输出特征切给不同 rank
把权重沿输出维切分:
其中:
输入 在 TP 组内复制。每个 rank 独立计算:
其形状为:
这里的关键是: 不是“不完整的数值”。它是全局输出 中某一组输出通道的完整值。因此,对于逐元素非线性函数 ,有:
也就是说,GeLU、SiLU、SwiGLU 中的逐元素部分,都可以在本地完成,不需要先通信。
列分片层的反向更值得仔细看。若下游已产生分片梯度:
那么本 rank 的权重梯度为:
它完全是本地计算,因为 只属于 rank 。
但输入梯度是各输出分片贡献之和:
每个 rank 先得到局部部分和:
然后进行:
因此,列分片层的典型通信点在反向:为了恢复 replicated 的输入梯度,需要对一个 张量做 AllReduce。
行分片线性层:把输入特征切给不同 rank
现在将权重沿输入维切分:
其中:
输入也必须与之匹配地切成:
其中:
每个 rank 本地计算:
注意它的 shape 是:
但 只是输出的部分贡献。完整输出为:
所以前向需要:
此时每个 rank 都得到同一个完整 。
反向时,因前向 AllReduce 已让输出 replicated,反向传回的 也在各 rank 相同。每个 rank 可本地计算:
以及:
其中:
它恰好就是上游列分片层所需的分片输出梯度。因此,行分片层的典型通信点在前向;反向的 可以直接交给前面的列分片层。
这一正反配对,是 Megatron 风格 TP 的核心:
| 线性层类型 | 前向通信 | 反向通信 | 最自然的相邻模块 |
|---|---|---|---|
| 列分片 | 无 | 对 AllReduce | 后接行分片层 |
| 行分片 | 对 AllReduce | 无 | 前接列分片层 |
一个重要边界条件:上述表讨论的是 TP 组内部。每个 TP rank 持有不同参数分片,因此 TP 内不需要为 做同步。若模型还叠加 FSDP 或数据并行, 是否要跨 DP/FSDP 组 ReduceScatter 或 AllReduce,是上一课的另一条通信维度,不能混入 TP 通信量中。
3. 为什么 Transformer MLP 可以只在末尾通信一次
标准两层 MLP 可写为:
其中:
是 MLP intermediate size,通常大于 。
Megatron 的关键安排是:
于是每个 rank 在前向执行:
最后才归约:
这条链路里:
- 是 replicated 的 ;
- 是按 intermediate 维分片的 ;
- GeLU、SiLU 和逐元素乘法均在 上本地执行;
- 的 shape 回到 ,但它只是部分和;
- 仅在 MLP 输出处做一次 AllReduce,恢复 replicated 的 。
如果反过来先将 按输入维行分片,则必须先把每个 rank 的部分结果加起来,再通过非线性函数:
因此通信会被迫出现在非线性函数之前。这正是“第一层列分片、第二层行分片”优于随意切矩阵的原因:它把必须存在的一次通信,推迟到了两个 GEMM 和非线性之后。
对于 Llama 常用的 SwiGLU MLP:
分片方式完全相同:
- 、:按输出维列分片;
- :按输入维行分片;
- 两个投影和逐元素乘法都使用本地 张量;
- 在 down projection 后,对 部分和做一次 AllReduce。
The Evolution of Multi-GPU Inference in vLLM | Ray Summit 2024
观看 Anyscale 的 “The Evolution of Multi-GPU Inference in vLLM”。这段用 Llama 的 gate、up、down 三个投影,直观展示了为什么前两个矩阵可本地计算、而 down projection 后必须归约。
观看 MLP 前向分片。重点辨认每张卡持有的是输出通道切片还是完整输出的部分和;尤其留意最后一次 AllReduce 恢复完整 hidden-state 的位置。
接着用 PyTorch 官方教程把图示对应到具体模块布局。阅读时不必关注 API 细节;关注的是 输入、权重和输出的 DTensor layout 必须彼此兼容。
Large Scale Transformer model training with Tensor ...
阅读 PyTorch 官方教程中对 Megatron 风格 TP 的概述,以及 Llama SwiGLU MLP 和 Attention 的分片计划。它把“列分片输出可直接交给行分片输入”的布局关系说得很明确。
先在 “How Tensor Parallel works?” 小节阅读 运行时布局概览,确认 TP 的运行时本质是对输入和输出 layout 做变换,而不只是把 weight 切开。 随后在介绍 Llama FeedForward 的段落中,阅读 SwiGLU 映射,将它和本节的 W_{\text{gate}}、W_{\text{up}}、W_{\text{down}} 对应起来。 最后继续到 Attention 的说明,定位到 “If there are any more tensor operations” 这句话,阅读 shape 操作要求。这里对 ASIC 图编译与动态图 shape 支持尤其重要:QKV 输出后即使只是 view 或 reshape,也必须识别每 rank 的本地 head 数,而不是误用全局 head 数。
反向传播则恰好镜像前向的配对:
- row-parallel 的 down projection 产生本地 ,无须通信;
- gate/up 两个列分片投影分别产生 的局部贡献;
- 将这些贡献相加后,对 执行一次 AllReduce;
- 得到完整的 MLP 输入梯度,交给前面的 RMSNorm、残差路径或 Attention。
所以,一个 MLP 子层每个 microbatch 的通信基线是:前向一次 AllReduce,反向一次 AllReduce。
一个实现细节:如果 row-parallel 输出层带有完整的 bias,它必须在 AllReduce 之后加一次;若每个 rank 都在归约前加同一 bias,该 bias 会被错误地累加 次。
4. 注意力层:按 attention heads 切分
自注意力的投影可简化为:
假定 个 attention heads 可以均匀分到 个 TP rank,每个 rank 负责:
个 heads。
将 、、 都按输出维列分片。以普通多头注意力、QKV 总输出维均为 的简化形式为例:
每个 rank 得到本地 Q、K、V:
重排为本地 head 维后,rank 完成自身 heads 的注意力:
注意 Softmax 的归一化是对每个 head 的 sequence 维进行的,不需要把不同 heads 的结果相加。因此,只要一个 head 完整地放在一个 rank 上,注意力分数计算、Softmax 与 都可以本地完成。
接下来将输出投影 按输入维行分片:
每个 rank 计算:
其中:
最终:
因此注意力子层与 MLP 子层有相同的通信骨架:
| 子层 | 前向本地计算 | 前向通信 | 反向通信 |
|---|---|---|---|
| Attention | 本地 QKV、本地 heads 的 attention、局部输出投影 | 输出投影后 1 次 AllReduce | QKV 输入梯度处 1 次 AllReduce |
| MLP | 本地 up/gate、激活、本地 down projection | down projection 后 1 次 AllReduce | 第一组投影输入梯度处 1 次 AllReduce |
在 Grouped-Query Attention 中, head 数与 head 数并不相同,但分片原则不变:分给某个 rank 的 query heads 及其对应 KV heads 必须可在本地完成 attention。工程上需要额外检查 、 与 的整除关系;若不能整除,就要处理不均匀分片或 padding。
5. 将 AllReduce 次数变成通信量
现在把通信量算出来。定义:
并设 activation 的通信 dtype 每元素为 bytes。对 BF16:
一次逻辑上的 activation AllReduce,其 payload 为:
若采用 ring AllReduce,按每 rank 实际传输字节量计,近似为:
这里系数 来自 ring AllReduce 可拆为 ReduceScatter 与 AllGather 两个阶段。不要把 这个逻辑张量大小误报为真实网络传输量。
对于一个完整 Transformer block:
- Attention 前向:1 次 AllReduce;
- MLP 前向:1 次 AllReduce;
- MLP 反向:1 次 AllReduce;
- Attention 反向:1 次 AllReduce。
因此每个 rank、每个 microbatch 的总 TP 通信量近似为:
即:
这正是 Megatron-LM 对经典 Transformer layer 给出的通信量基线。它不含:
- DP/FSDP 组上的参数、梯度通信;
- pipeline stage 之间的 P2P activation;
- MoE 的 token dispatch / combine All-to-All;
- 序列并行或上下文并行改变 layout 后的额外通信。
Efficient Large-Scale Language Model Training on GPU ...
阅读 Megatron-LM 的原始论文相关部分。第 2.3 节给出 MLP 和 Attention 的分片逻辑;性能分析部分给出每层、每个 microbatch 的 TP 通信量公式。
在第 2.3 节 “Tensor Model Parallelism” 中,从 “With tensor model parallelism” 开始,阅读 MLP 与注意力布局。重点核对:第一 GEMM 的列分片、第二 GEMM 的行分片,为什么使中间 GeLU 不需要同步。 然后在第 3 节的 pipeline 与 tensor parallelism 通信比较段中,阅读 通信量公式。将其中的 b、s、h、t 分别替换为你的 microbatch、序列长度、hidden size 和 TP 组大小,并注意该表达式按每个设备统计。
一个可复用的计算示例
假设某缩比验证模型采用:
并使用 BF16 activation 通信:
则微批 token 数:
一次 AllReduce 的逻辑 payload 为:
对 的 ring AllReduce,每 rank 传输约:
一个 Transformer block 有四次这样的 AllReduce,因此:
这是每个 rank、每个 microbatch、每个 Transformer block的网络传输量估算。若一个 pipeline stage 有 个 block,则:
对 128k 上下文,这个量会随 线性放大。即使先不讨论注意力本身的复杂度,也已经可以看出:在“低带宽”ASIC 上,不能只因显存允许就无限增大 TP 度或让 TP 跨越低速链路。
6. 对 5T MoE 训练框架的直接含义
TP 的价值是每个 rank 只保存线性层约 的权重、权重梯度和对应计算,但它并没有消除所有 activation 的复制。在本节的基线布局中,Transformer block 边界的 hidden-state 仍是:
也就是每个 TP rank 都有一份。
这带来几个架构判断:
-
TP 应优先放在最快的局部互联域。
TP 的 AllReduce 发生在每个 Transformer block、每个 microbatch 的前向和反向中,频率很高。若 box 内与 box 间带宽差异明显,TP 组不应轻易跨越较慢链路。 -
TP 度不是越大越好。
增大 的确让线性权重和 GEMM 近似缩小到 ,但每次 AllReduce 的 activation payload 主要由 、 决定,并不会按 缩小;其 ring 系数还会趋近于 。 -
TP 不能替代 FSDP。
TP 切的是层内矩阵,FSDP/ZeRO 切的是某个 DP 组内的训练状态。实际 5T MoE 映射通常会组合 TP、PP、EP、CP 与 FSDP/DP;每一维必须有独立通信组和独立通信账本。 -
MoE 专家内部同样可能使用这套 MLP TP 规则。
但专家并行会先通过 All-to-All 将 token 路由到专家,再执行专家 MLP。后续设计中必须把 TP AllReduce 与 MoE All-to-All 分开测量、分开放置;二者对拓扑的偏好不一定一致。 -
ASIC 的集合通信验收应以 activation-sized AllReduce 为中心。
除了测大参数 AllGather,还应测指定 、指定 、指定 BF16/FP8 buffer 的 AllReduce 有效带宽、启动延迟、异步进度和与 GEMM 的重叠比例。TP 的关键通信往往位于残差连接之前,不能假设它总能被后续计算完全隐藏。
建议从现在开始,在每次 TP 实验的记录中固定写入:
| 项目 | 应记录的值 |
|---|---|
| TP 度 | 与 TP group 的 rank 映射 |
| 模型形状 | 、MLP intermediate size、Q/KV head 数 |
| 微批形状 | 、、 |
| 分片布局 | 每个线性层是列分片还是行分片 |
| collective | 每层前向/反向 AllReduce 次数、payload 和 dtype |
| 通信时间 | 平均、P95、暴露在关键路径上的尾部时间 |
| 正确性 | 与单卡或低 TP 度基线的 loss、梯度范数、参数更新误差 |
小结
Megatron 风格 TP 的基本设计不是“把每个矩阵随便切开”,而是让相邻线性层的布局相互配合:
- 列分片线性层:输入 replicated,输出按特征维分片;前向没有通信,反向需要 AllReduce 输入梯度。
- 行分片线性层:输入按特征维分片,输出是完整 shape 的部分和;前向需要 AllReduce,反向可产生分片输入梯度而无需通信。
- MLP:up/gate 投影列分片,down 投影行分片;每个 microbatch 的前向和反向各一次 AllReduce。
- Attention:QKV 按 attention heads 列分片,输出投影行分片;同样是前向和反向各一次 AllReduce。
- 因而一个标准 Transformer block 的 TP 基线是 两次前向 AllReduce、两次反向 AllReduce,每 rank 通信量近似为:
下一课将讨论流水线并行:它把不同层放到不同设备或设备组中,并用较轻的 P2P activation 传输替代一部分高频 TP collective;代价则是流水线气泡、microbatch 数量和阶段负载均衡问题。