你好。上一课分析了张量并行:TP 在每个 Transformer block 内频繁执行 activation-sized AllReduce,因此通常应放在最快的局部互联域。现在转向流水线并行(Pipeline Parallelism,PP):它把不同的层或层组放到不同的设备组上,设备组之间只传递边界 activation 与梯度。
PP 的主要代价不是像 TP 那样的高频 collective,而是依赖关系带来的填充、稳态与排空(flush)阶段。本课将建立一套可计算的模型,用来回答三件事:
- 给定流水线阶段数 与每次更新的微批次数 ,气泡比例是多少;
- 为什么阶段负载不均衡会让理论气泡公式过于乐观;
- 如何从目标利用率、全局 batch、显存和算子效率反推可行的 。
这里的“阶段”是一个顺序执行的模型分区,而不必等于一张卡。例如,若每个 stage 内部使用 ,一个 的训练副本实际占用 个设备 rank;气泡计算中的 仍然是 8,而不是 64。
1. 从一条空流水线开始
设一个 Transformer 被切为 个顺序 stage。一个 microbatch 必须依次经过:
才能完成前向;反向梯度则按相反方向返回。
如果整个 batch 只作为一个整体运行,即:
那么 stage 1 完成前向后,stage 2 才能开始;stage 3 还在等待。即使每个 stage 都有设备资源,大部分设备在大部分时间内仍为空闲。这就是流水线气泡的来源:不是设备没有任务,而是它的下游或上游依赖尚未满足。
把一次 optimizer update 的 batch 切为多个 microbatch 后,stage 1 在处理 microbatch 2 时,stage 2 可以处理 microbatch 1;流水线开始被填满。等到稳态阶段,每个 stage 都会持续处理不同 microbatch 的前向或反向任务。
Training LLMs at Scale - Deepak Narayanan | Stanford MLSys #83
观看 Stanford MLSys Seminars 的 Deepak Narayanan 演讲《Training LLMs at Scale》。这段用时间线解释了模型如何切成流水线阶段、为什么朴素切分会产生空闲,以及 microbatch 如何填充流水线。
先看 流水线直觉,注意一个 microbatch 在相邻 stage 间的依赖如何造成前段填充和后段等待;再看 气泡公式,将讲者的符号与本课的 P 和 M 对应起来。
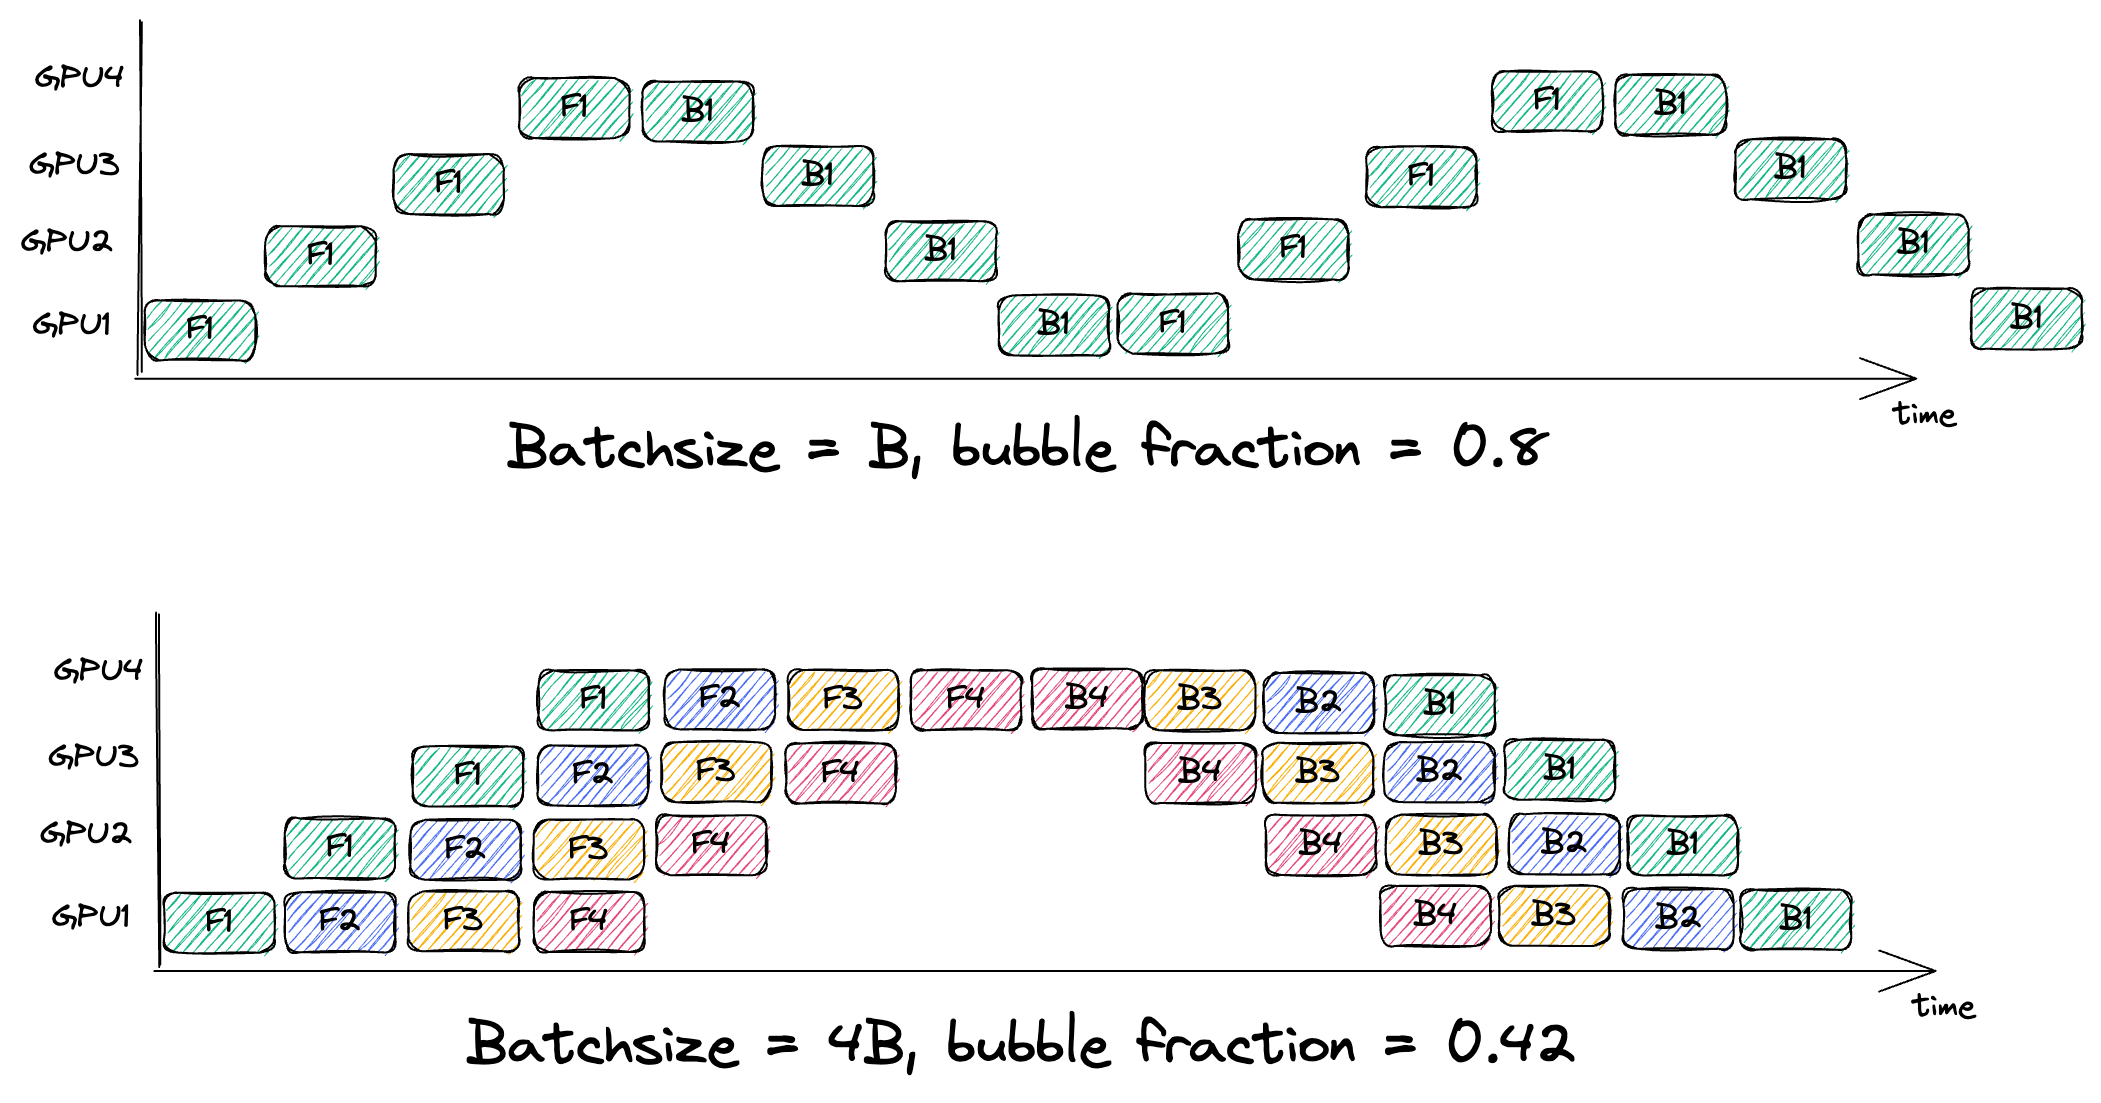
下图用 4 个 stage 展示了这种变化:上半部分几乎只有一个 microbatch 在流水线中流动;下半部分同时流动 4 个 microbatch,因此每个设备的等待区间显著缩短。
这里需要区分两个常被混用的量:
- microbatch size :每个 microbatch 中的样本数;
- microbatch count :一次参数更新中,每个数据并行副本累积的 microbatch 数。
流水线气泡主要由 决定,而单个 microbatch 的计算效率、activation 内存和 kernel 利用率主要受 与序列长度 影响。
2. 平衡流水线中的气泡比例
先采用一个足够有用的理想模型:
- 有 个 stage;
- 每个 stage 对一个 microbatch 的一次前向或反向工作耗时均为 ;
- stage 间通信已包含在 中,或能够被完全重叠;
- 使用非交错的 flush schedule,例如 GPipe 或 PipeDream-Flush 1F1B;
- 一次更新处理 个 microbatch。
在这个模型中,前向传播需要 个时间槽:前面的 个槽用于填满流水线。反向也有同样的填充和排空结构。因此总 wall-clock 时间为:
所有 stage 真正执行前向与反向计算的总工作量为:
而整个集群在这段时间内提供的总 stage-capacity 为:
于是,理想条件下的流水线利用率为:
相应的气泡比例,即可用 stage-capacity 中因流水线依赖而空闲的比例,是:
这是一条需要熟练掌握的公式:
两种常见写法,为什么看上去不同
你也会看到另一种写法:
它将气泡时间与“有用工作时间”相比,而不是与总 wall-clock capacity 相比。两者并不矛盾:
在架构评审、性能仪表盘和容量模型中,必须写清楚分母:
| 指标 | 公式 | 含义 |
|---|---|---|
| wall-clock 气泡比例 | 总可用 stage 时间中空闲的占比 | |
| 相对有用工作的气泡开销 | 每单位有效工作额外承担多少气泡时间 | |
| 理想流水线利用率 | 未考虑阶段失衡时的利用率上限 |
例如 、 时:
图中的“约 0.8”应视为带有实际调度和边界开销的直观示意;在均匀时间槽的理论模型中,结果是 。
Pipeline-Parallelism: Distributed Training via Model Partitioning
阅读 Siboehm 的这篇流水线并行说明,用一组具体时序表把 microbatch、梯度累积、GPipe 气泡和 1F1B 的内存差异连接起来。
先在 “The GPipe Algorithm: Splitting Minibatches into Microbatches” 中阅读 microbatch 的梯度累积逻辑,确认切分 batch 不改变梯度求和的数学语义。接着在 “GPipe: Pipeline Bubbles” 中阅读 气泡推导,尤其核对“有用工作量”和总时间槽各自如何计数。最后在 “The PipeDream Algorithm: Interleaving Forwards- and Backwards-Passes for Different microbatches” 中阅读 1F1B 的内存对比;本课暂不深入实现细节,只关注它并未自动消除基本气泡。
3. 由目标气泡反推需要多少 microbatch
假设希望气泡比例不超过阈值 :
整理可得:
因此:
这给出的是一个必要的起点,不是最终配置:它只控制理想气泡,不保证单卡 kernel 利用率、激活内存、通信重叠或 MoE 路由尾延迟都可接受。
下面是一些直接可用的数值:
| 阶段数 | 目标气泡 | 最小 microbatch 数 |
|---|---|---|
| 8 | 28 | |
| 8 | 63 | |
| 8 | 133 | |
| 16 | 60 | |
| 16 | 135 | |
| 16 | 285 |
例如,将一个训练副本切为 个 pipeline stage,并选择:
则:
若希望达到 以下, 明显不够;需要至少:
这也解释了一个重要趋势:PP 度翻倍时,若要维持同样的气泡比例,microbatch 数必须近似线性增加。
对 5T MoE 系统而言,不能因为权重或优化器状态要求更多 PP stage,就假设 PP 可以无限增大。更多 stage 减少了每个 stage 的模型状态,却把更高的 要求转移给全局 batch、activation 内存与训练算法稳定性。
4. 气泡不是唯一的空闲来源:阶段负载决定稳态吞吐
上面的气泡公式有一个很强的前提:每个 stage 处理一个 microbatch 的时间相同。真实的 Transformer/MoE 训练往往不满足它。
对 stage ,定义一个 microbatch 的暴露负载:
其中最后一项只包括没有被计算隐藏的通信,例如:
- pipeline 边界的 activation 与 gradient P2P;
- stage 内 TP AllReduce 的暴露部分;
- MoE token dispatch/combine 的 All-to-All 尾部;
- 由于依赖关系无法与 GEMM 重叠的同步等待。
不要简单地把所有通信时间相加。若通信已被后续计算完全覆盖,它不应计入暴露负载;性能 trace 才是最终依据。
定义平均 stage 负载与最慢 stage 负载:
再定义阶段失衡系数:
其中:
- :所有 stage 完全均衡;
- :存在慢 stage;
- 越大,其他 stage 等待越多。
若前向和反向的负载分布大致相似,一个很实用的一阶模型是:
相应的 aggregate stage 利用率近似为:
即:
这个式子把两类损失乘在一起:
- :流水线填充不足造成的损失;
- :阶段负载失衡造成的损失。
一个带有慢 MoE stage 的例子
假设 、。测得各 stage 在一个 microbatch 上的暴露前反向负载如下,单位为毫秒:
则:
理想气泡利用率为:
但加入负载失衡后:
也就是说,即使 已让理论气泡降到约 ,一个比平均值慢约 的 stage,仍会让 aggregate 利用率降到约 。
增加 可以摊薄气泡,但不能修复 stage 失衡。
对于目标中的 MoE 模型,stage 失衡尤其容易来自:
- 不同 stage 的 dense block、attention block、MoE block 数量不同;
- 某些 stage 承担的专家更多,或其专家热点更严重;
- token 分发后的 All-to-All 尾延迟在少数 stage 集中暴露;
- 某些 stage 的 PP 边界穿过慢链路;
- 128k 上下文下,个别 attention 实现、重计算或临时 buffer 的代价明显更高。
因此,按“每个 stage 放相同层数”分配模型通常不够。应按测得的每 microbatch 暴露时间分配,而不是按层数、参数量甚至 FLOPs 单独分配。
5. GPipe 与 1F1B:相同的基本气泡,不同的 activation 压力
GPipe 的典型做法是:先让所有 个 microbatch 完成前向,再集中执行反向。它的优点是语义直观;代价是早期 stage 需要为大量尚未反向的 microbatch 保存 activation。
1F1B(one-forward-one-backward)在 warmup 后交替执行前向和反向:一个 stage 每完成一个新的前向,就尽快为更早的 microbatch 执行一次反向。其关键价值是降低同时“在飞”的 microbatch 数,从而降低 activation memory 峰值。
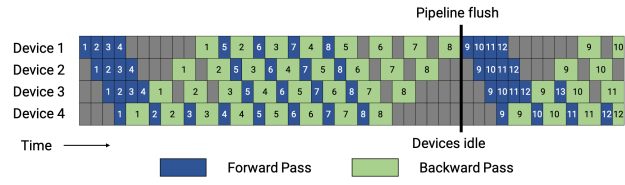
在非交错、flush 语义下,1F1B 并不改变前面作为基线的气泡比例:
它改变的是activation 生命周期:
| 调度 | 一次更新中的前向/反向关系 | activation 内存趋势 |
|---|---|---|
| GPipe | 先完成全部前向,再集中反向 | 早期 stage 可能保留接近 个 microbatch 的 activation |
| 1F1B Flush | warmup 后前向、反向交替 | 稳态下通常只保留与流水线深度同量级的在飞 microbatch activation |
这对长上下文尤为关键。若 ,即使 ,每个 microbatch 的 activation 已经很大。此时仅靠“增大 降低气泡”往往会触发显存约束;1F1B、激活重计算、序列并行和上下文并行需要一起考虑。
6. 从 global batch 推导 ,再检查是否可行
设:
- :数据并行副本数;
- :每个 DP 副本上的 microbatch size;
- :每次更新中每个 DP 副本处理的 microbatch 数;
- :每个样本的有效序列长度。
忽略 padding 和变长样本时,全局样本 batch 为:
全局 token batch 为:
因此,若训练算法或优化策略已经给定目标全局 batch,则:
或者按 token 计:
这揭示了 PP 配置中的真实约束链:
例如,若 ,希望气泡不高于 ,则至少需要:
若某训练配置中 、、所有样本都为 ,则每次更新对应的 token 数为:
这不是说系统一定不能这样训练,而是说明:对于满长度 128k 样本,单纯为了降低 PP 气泡而要求很高的 ,会把一次更新的 token batch 推到极大的量级。
因此,设计时不能只盯住“气泡低于 5%”这一局部目标。你需要同时检查:
- 模型与算法允许的 global token batch;
- 采样/数据管线是否可持续提供该 token 量;
- 每个 microbatch 的 kernel 效率是否仍足够高;
- 1F1B 与重计算下的 activation 峰值;
- 各 stage 的 MoE 路由尾延迟;
- microbatch 数是否能被现有训练引擎正确累积、检查点恢复和复现。
7. 面向新 ASIC 的流水线并行设计流程
在 8 卡 demo、64 卡缩比闭环以及后续千卡映射中,可以固定采用以下流程。
第一步:明确 PP 的拓扑含义
先定义每个 stage 是什么设备组,而不是只写一个 数字。例如:
表示每个 stage 由一个 的组执行,PP 边界发生在 stage group 之间。此时应明确:
- TP group 是否完全位于高速 box 内;
- PP P2P 是否会跨越 box 间链路;
- MoE EP group 是否与 PP stage 对齐;
- PP 边界 activation 的 layout、dtype 和通信路径是什么。
第二步:选择候选 microbatch shape
对每个候选:
测量:
- 前向、反向 GEMM 与 attention 时间;
- TP collective 暴露时间;
- MoE All-to-All 的平均与 P95/P99 时间;
- PP P2P latency、有效带宽和重叠比例;
- kernel launch 与图执行开销;
- 训练 activation 峰值。
在低带宽 ASIC 上, 过小会使通信启动延迟和小 GEMM 低效更明显;因此不能把“增加 ”误解为把 无限切小。
第三步:计算并平衡 stage load
为每个候选 stage 记录:
并计算:
优先通过重分配 Transformer block、MoE layer、专家副本或边界位置,使 接近 1。实际工程中,一个合理的初始门槛可以是:
具体阈值还要结合重分片难度、拓扑和 MoE 路由波动决定。
第四步:按气泡目标求
选择明确的 SLO,例如:
然后按:
得到候选 。同时计算它对应的 global sample batch 和 global token batch。
第五步:用 trace 验证,而不是只相信公式
最终应从训练 trace 中区分至少五类时间:
| 时间类别 | 解释 |
|---|---|
| 有效计算 | GEMM、attention、专家 MLP、重计算等 |
| 理想 PP 气泡 | 填充与排空造成的结构性空闲 |
| 负载失衡等待 | 等待慢 stage、慢专家或慢 collective |
| 暴露通信 | 未被计算隐藏的 TP、PP、EP 通信 |
| 调度与运行时开销 | kernel launch、图编译、同步、队列等待等 |
只有第一类是直接有效工作;第二类可以主要通过 处理;第三类需要重分区、改善路由或调整拓扑;第四、第五类则会形成对 ASIC 通信库、运行时和编译器的明确需求。
小结
流水线并行通过按层切分模型来降低单个设备组的模型状态与计算负担,但引入了依赖造成的空闲时间。
- 对有 个 stage、每次更新处理 个 microbatch 的均衡流水线:
- 若目标气泡比例为 ,则:
- 气泡只是一部分利用率损失。定义 stage 失衡系数:
则实际 aggregate 利用率可近似理解为:
- 增加 能摊薄填充与排空,但不能修复慢 stage、MoE 路由尾延迟或暴露通信。
- GPipe 与 1F1B 在基本气泡上没有本质差异;1F1B 的关键收益是控制 activation 的在飞数量,因而更适合长上下文训练。
- 对 128k 上下文和 5T MoE,、global token batch、activation 内存、阶段负载和低带宽通信必须联立决策。
下一课将讨论序列并行与上下文并行:它们如何减少长序列带来的 activation 与 attention 内存压力,以及相应增加哪些通信代价。