Bonjour,
Dans notre leçon précédente, nous avons analysé le tri fusion, un excellent exemple du paradigme "diviser pour régner" qui garantit une complexité temporelle en . Nous avons vu que son efficacité reposait sur l'étape de combinaison (la fusion), tandis que l'étape de division était triviale.
Aujourd'hui, nous abordons un autre pilier des algorithmes de tri : le tri rapide (quicksort). Inventé par Tony Hoare, cet algorithme suit également le paradigme "diviser pour régner", mais en inversant la charge de travail. Ici, l'étape de division est l'opération complexe et cruciale, tandis que la combinaison est inexistante.
Votre objectif pour cette leçon est d'implémenter l'algorithme du tri rapide, en portant une attention particulière à sa fonction centrale : la fonction de partition. La maîtrise des mécanismes de partitionnement est fondamentale, non seulement pour le tri rapide, mais aussi pour d'autres algorithmes comme la recherche du k-ième plus petit élément (sélection rapide).
1. Le Principe du Tri Rapide
La stratégie du tri rapide se décompose comme suit :
- Diviser : C'est l'étape de partitionnement. On choisit un élément du tableau, le pivot. On réorganise ensuite le tableau (ou le sous-tableau) de sorte que tous les éléments inférieurs ou égaux au pivot se retrouvent à sa gauche, et tous les éléments supérieurs se retrouvent à sa droite. À la fin de cette étape, le pivot est à sa position définitive dans le tableau trié.
- Régner : On applique récursivement le tri rapide sur les deux sous-tableaux : celui à gauche du pivot et celui à sa droite.
- Combiner : Aucune action n'est nécessaire. Comme les sous-tableaux sont triés "en place" et que le pivot est déjà bien positionné, le tableau entier se retrouve trié une fois que les appels récursifs se terminent.
L'intelligence de l'algorithme réside entièrement dans la procédure de partitionnement. La fonction de tri rapide n'est en fait qu'un "pilote" (driver) qui orchestre les appels à cette fonction de partitionnement.
Pour bien saisir cette abstraction, je vous invite à regarder l'introduction de la vidéo suivante.
All Quicksort does is call this function - Partition!
Cette vidéo explique très clairement comment le tri rapide peut être vu comme un simple pilote pour une fonction de partitionnement. Elle met en évidence la séparation des responsabilités entre le tri (la stratégie récursive) et le partitionnement (la réorganisation locale).
Regardez la section de 00:26 à 02:41. Concentrez-vous sur l'idée que le tri rapide est une abstraction qui s'appuie sur une fonction partition supposée fonctionnelle.
2. L'algorithme de partition de Lomuto
Il existe plusieurs manières de réaliser le partitionnement. La plus simple à comprendre et à implémenter est celle proposée par Nico Lomuto. Elle est souvent enseignée en premier.
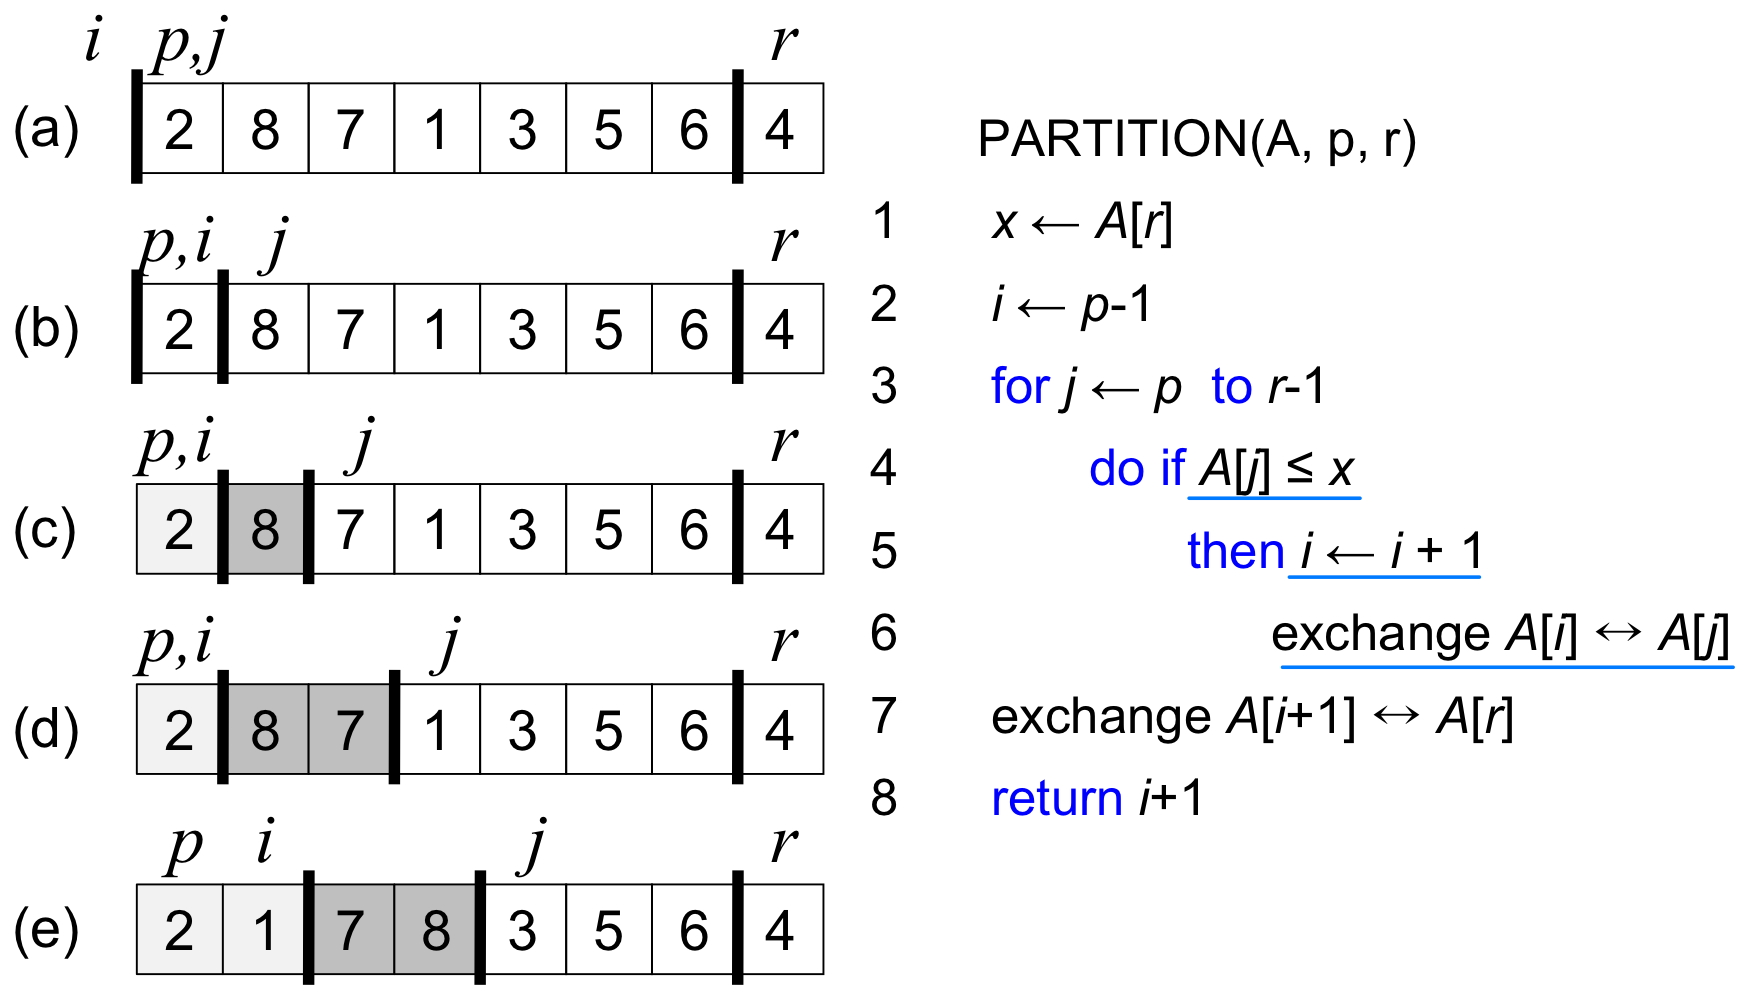
Principe de la partition de Lomuto :
- Choix du pivot : On choisit un pivot. Pour la simplicité de l'algorithme, on choisit souvent le dernier élément du sous-tableau.
- Parcours et échange : On maintient un indice
iqui marque la frontière de la zone des éléments plus petits que le pivot. On parcourt le tableau avec un autre indicej.- Au début,
iest juste avant le début du sous-tableau. - Pour chaque élément
A[j], siA[j]est inférieur ou égal au pivot, on incrémenteiet on échangeA[i]avecA[j].
- Au début,
- Placement final du pivot : Une fois le parcours terminé, tous les éléments jusqu'à l'indice
isont plus petits que le pivot. On échange alors l'élément enA[i+1]avec le pivot (qui était au début à la fin du tableau). Le pivot est maintenant à sa place définitive, à l'indicei+1.
L'image suivante, inspirée du livre de référence de Cormen et al., illustre parfaitement ce processus.
Pour voir cet algorithme en action, la vidéo suivante propose une excellente démonstration visuelle.
All Quicksort does is call this function - Partition!
Cette section de la vidéo précédente détaille le fonctionnement de la partition de Lomuto avec une animation pas à pas.
Regardez de 06:40 à 08:52. Observez comment la partition "gauche" (éléments plus petits que le pivot) grandit au fur et à mesure que l'algorithme progresse.
3. Implémentation en Python (avec partition de Lomuto)
Maintenant, mettons cela en pratique. Le code ci-dessous structure l'algorithme en trois fonctions, comme il est courant de le faire pour plus de clarté :
partition(arr, low, high): Implémente le schéma de Lomuto.quick_sort_recursive(arr, low, high): Le pilote récursif.quick_sort(arr): La fonction principale que l'utilisateur appelle.
def partition(arr, low, high):
    """
    Partitionne le sous-tableau arr[low..high] en utilisant le dernier élément comme pivot.
    Retourne l'index final du pivot.
    """


    # On choisit le dernier élément comme pivot
    pivot = arr[high]


    # i est l'index du dernier élément plus petit que le pivot trouvé
    i = low - 1

    for j in range(low, high):


        # Si l'élément courant est plus petit ou égal au pivot
        if arr[j] <= pivot:


            # On incrémente i et on échange arr[i] et arr[j]
            i += 1
            arr[i], arr[j] = arr[j], arr[i]


    # Le pivot doit être placé après le dernier élément plus petit que lui.
    # On échange donc arr[i+1] avec le pivot (arr[high])
    arr[i + 1], arr[high] = arr[high], arr[i + 1]


    # On retourne l'index où se trouve maintenant le pivot
    return i + 1

def quick_sort_recursive(arr, low, high):
    """
    La fonction récursive qui pilote le tri rapide.
    """
    if low < high:


        # pi est l'index de partitionnement, arr[pi] est maintenant à sa place.
        pi = partition(arr, low, high)


        # Trie récursivement les éléments avant et après la partition
        quick_sort_recursive(arr, low, pi - 1)
        quick_sort_recursive(arr, pi + 1, high)

def quick_sort(arr):
    """
    Fonction principale pour appeler le tri rapide.
    """
    quick_sort_recursive(arr, 0, len(arr) - 1)


# Exemple d'utilisation
my_array = [10, 7, 8, 9, 1, 5]
quick_sort(my_array)
print("Tableau trié:", my_array)  # Devrait afficher [1, 5, 7, 8, 9, 10]
Le choix du pivot
Choisir systématiquement le dernier élément comme pivot peut être problématique. Si le tableau est déjà trié ou trié en ordre inverse, le partitionnement sera déséquilibré (un sous-tableau de taille 0 et un de taille n-1), menant à une complexité en .
Une stratégie simple et très efficace en pratique pour éviter ce cas est de choisir un pivot aléatoire. On choisit un indice au hasard dans le sous-tableau, on échange cet élément avec le dernier, puis on exécute l'algorithme de Lomuto normalement.
import random

def random_partition(arr, low, high):


    # Choisir un index de pivot aléatoire
    rand_pivot_index = random.randrange(low, high + 1)


    # Échanger avec le dernier élément pour utiliser l'implémentation de Lomuto
    arr[rand_pivot_index], arr[high] = arr[high], arr[rand_pivot_index]


    # Appeler la partition de Lomuto standard
    return partition(arr, low, high)


# La fonction quick_sort_recursive devrait alors appeler random_partition
# au lieu de partition.
4. L'algorithme de partition de Hoare
La partition de Hoare est le schéma original, historiquement le premier. Il est légèrement plus complexe, mais souvent plus performant en pratique car il effectue moins d'échanges.
Principe de la partition de Hoare :
- Choix du pivot : On choisit un pivot (par exemple, le premier élément).
- Pointeurs convergents : On utilise deux pointeurs,
ipartant du début etjpartant de la fin du sous-tableau.- On avance
itant quearr[i] < pivot. - On recule
jtant quearr[j] > pivot.
- On avance
- Échange : Si
i < j, cela signifie qu'on a trouvé un élément trop grand à gauche (arr[i]) et un élément trop petit à droite (arr[j]). On les échange. - Répétition : On répète le processus jusqu'à ce que les pointeurs
ietjse croisent (i >= j).

Attention, une subtilité cruciale :
Contrairement à Lomuto, la partition de Hoare ne garantit pas que le pivot se trouve à l'indice retourné. Elle garantit seulement que tous les éléments à gauche de cet indice sont au pivot, et tous ceux à droite sont au pivot. L'index retourné est le point de "cassure". Par conséquent, les appels récursifs doivent inclure cet indice : quick_sort(arr, low, j) et quick_sort(arr, i, high).
Le document suivant, destiné à des étudiants préparant les concours, décrit les deux méthodes.
[PDF] Colle 4 : Listes Caml et tris
Ce document de préparation à une 'colle' d'informatique présente les deux schémas de partitionnement pour un tri rapide sur un tableau.
Lisez les sections 3.1 (Lomuto) et 3.2 (Hoare). Comparez la description des deux algorithmes. Notez la structure du code principal tri_rapide qui montre comment la fonction de séparation est intégrée dans les appels récursifs.
Exercice Pratique
- Implémentation : Reprenez le code Python fourni pour le tri rapide avec la partition de Lomuto. Assurez-vous de bien le comprendre et de pouvoir le réécrire de mémoire.
- Amélioration : Modifiez votre implémentation pour utiliser un pivot aléatoire. Testez-la sur différents tableaux (triés, inversés, aléatoires).
- Défi (pour aller plus loin) : Implémentez la fonction de partitionnement de Hoare. Intégrez-la dans le pilote récursif en faisant bien attention aux indices des appels récursifs, qui diffèrent de ceux utilisés avec Lomuto. C'est un excellent exercice pour vérifier votre compréhension fine des algorithmes.
Conclusion
Le tri rapide est un algorithme puissant et largement utilisé. Son efficacité dépend entièrement de la qualité de sa fonction de partitionnement.
À retenir :
- Le tri rapide est un algorithme diviser pour régner où le travail se concentre sur l'étape de partition.
- Le schéma de Lomuto est simple : il construit une partition d'éléments plus petits que le pivot et place ce dernier à sa position finale.
- Le schéma de Hoare est l'original : il utilise deux pointeurs convergents et est souvent plus rapide, mais sa gestion des indices est plus subtile.
- Le choix du pivot est critique pour éviter le pire cas en . Un pivot aléatoire est une stratégie robuste.
Dans la prochaine leçon, nous analyserons formellement la complexité du tri rapide. Nous verrons pourquoi, malgré un pire cas en , sa complexité moyenne en et ses bonnes performances en pratique en font un choix si populaire.