Bonjour,
Dans la leçon précédente, nous avons étudié le tri par insertion. Nous avons vu qu'il s'agissait d'un algorithme simple et efficace pour des tableaux de petite taille ou presque triés, mais dont la complexité quadratique, , dans le pire des cas le rend impraticable pour de grands volumes de données.
Aujourd'hui, nous abordons un algorithme de tri d'une efficacité bien supérieure, le tri fusion (ou merge sort). Il est l'exemple canonique de la stratégie algorithmique "diviser pour régner" (divide and conquer). Notre objectif est double : d'une part, implémenter cet algorithme en Python et, d'autre part, mener une analyse rigoureuse pour prouver sa complexité en , une borne de performance que nous retrouverons très souvent.
1. Le paradigme "Diviser pour Régner"
Le tri fusion repose sur une stratégie générale que vous devez absolument maîtriser : diviser pour régner. La démarche se décompose en trois temps :
- Diviser : Le problème est décomposé en plusieurs sous-problèmes de même nature, mais de plus petite taille.
- Régner : Les sous-problèmes sont résolus récursivement. Si leur taille est suffisamment petite, ils sont résolus de manière directe (cas de base).
- Combiner : Les solutions des sous-problèmes sont combinées pour construire la solution du problème initial.
Dans le cas du tri fusion, cela se traduit par :
- Diviser : On coupe le tableau de éléments en deux sous-tableaux de taille .
- Régner : On trie récursivement les deux sous-tableaux. Le cas de base est un tableau de taille 0 ou 1, qui est par définition déjà trié.
- Combiner : On fusionne les deux sous-tableaux triés pour obtenir le tableau final trié. C'est l'étape cruciale.
2. Le mécanisme du tri fusion
L'essentiel de l'intelligence de l'algorithme réside dans l'étape de fusion. Comment combiner deux listes déjà triées en une seule, tout en conservant l'ordre ? La méthode est élégante et efficace.
Pour comprendre cette étape de fusion, qui est le cœur de l'algorithme, je vous invite à regarder la vidéo suivante.
Lecture 3: Insertion Sort, Merge Sort
Cette vidéo du MIT, extraite d'un cours d'introduction aux algorithmes, explique de manière remarquable l'étape de fusion. Le professeur y présente ce qu'il nomme l'algorithme "à deux doigts" (two-finger algorithm).
Regardez la section de 25:01 à 31:38. Concentrez-vous sur la manière dont les deux pointeurs parcourent les sous-tableaux triés pour construire le tableau final. Notez bien l'analyse finale qui conclut que la complexité de cette opération de fusion est linéaire, en Θ(n).
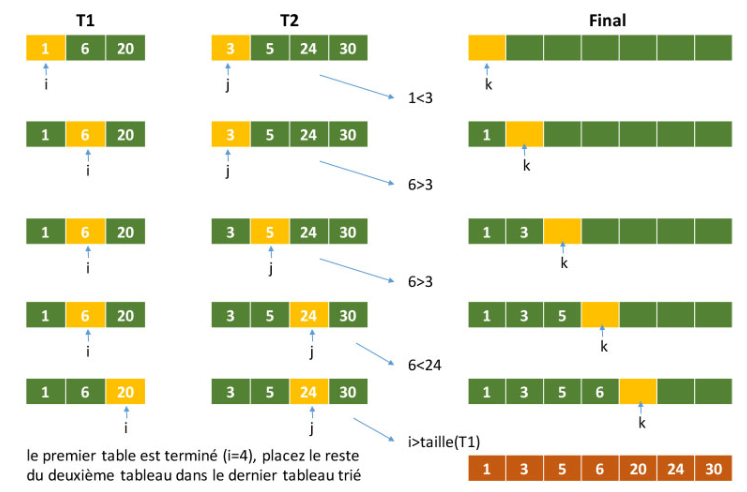
Pour résumer le principe de la fusion de deux tableaux triés, disons L (gauche) et R (droite) :
- On utilise trois pointeurs :
ipourL,jpourR, etkpour le tableau finalA. - Tant qu'il reste des éléments dans
LetR, on compareL[i]etR[j]. - On copie le plus petit des deux dans
A[k], et on avance le pointeur correspondant (iouj) ainsi que le pointeurk. - Lorsqu'un des deux sous-tableaux est épuisé, on copie simplement le reste de l'autre sous-tableau à la fin de
A.
L'image suivante illustre ce processus :
La partie "division" est simplement l'organisation des appels récursifs qui descendent jusqu'aux cas de base (tableaux de taille 1). La véritable "action" se produit lors de la remontée des appels, pendant la phase de fusion.
3. Implémentation en Python
Forts de cette compréhension, nous pouvons passer à l'implémentation. Le document suivant, préparé pour l'agrégation, propose un pseudo-code clair que nous pouvons suivre.
[PDF] Leçon 903 : Exemples d'algorithmes de tri. Correction et complexité
Ce document de synthèse sur les algorithmes de tri présente le tri fusion avec un pseudo-code précis (Algorithme 8 et 9) que nous allons traduire en Python.
Consultez la section sur le 'Tri fusion' à la page 9. Repérez l'Algorithme 8 (Fusion) et l'Algorithme 9 (Tri-Fusion). Notez que leur implémentation travaille sur des indices (g, m, d) d'un tableau unique, ce qui est une approche classique et efficace pour éviter des créations excessives de sous-tableaux.
Voici une implémentation Python qui suit cette logique. Elle est récursive et n'est pas "en place" : elle utilise des tableaux auxiliaires pour faciliter la fusion, ce qui a un impact sur sa complexité spatiale.
def merge_sort(arr):
    """
    Trie un tableau en utilisant l'algorithme du tri fusion.
    """
    if len(arr) > 1:


        # 1. Diviser
        mid = len(arr) // 2
        left_half = arr[:mid]
        right_half = arr[mid:]


        # 2. Régner (appels récursifs)
        merge_sort(left_half)
        merge_sort(right_half)


        # 3. Combiner (fusion)
        i = j = k = 0


        # Fusionne les deux moitiés triées dans le tableau original 'arr'
        while i < len(left_half) and j < len(right_half):
            if left_half[i] < right_half[j]:
                arr[k] = left_half[i]
                i += 1
            else:
                arr[k] = right_half[j]
                j += 1
            k += 1


        # Copie les éléments restants de left_half, s'il y en a
        while i < len(left_half):
            arr[k] = left_half[i]
            i += 1
            k += 1


        # Copie les éléments restants de right_half, s'il y en a
        while j < len(right_half):
            arr[k] = right_half[j]
            j += 1
            k += 1


# Exemple d'utilisation
my_array = [38, 27, 43, 3, 9, 82, 10]
merge_sort(my_array)
print("Tableau trié:", my_array)
Complexité Spatiale
Contrairement au tri par insertion, le tri fusion n'est pas un tri "en place" dans cette implémentation courante. Les découpes left_half = arr[:mid] créent des copies, et l'espace total requis est de l'ordre de . C'est le prix à payer pour l'efficacité temporelle.
4. Analyse de Complexité et Preuve
Nous arrivons au cœur de cette leçon : la preuve de la complexité en .
a. Équation de récurrence
Soit le temps d'exécution du tri fusion pour un tableau de taille .
- Diviser : Trouver le milieu prend un temps constant, .
- Régner : On résout deux sous-problèmes de taille , ce qui coûte .
- Combiner : Comme nous l'avons vu, la fusion de deux sous-tableaux dont la taille totale est prend un temps linéaire, .
L'équation de récurrence pour le temps d'exécution est donc :
Le cas de base est .
La vidéo suivante explique comment on établit cette récurrence.
Lecture 3: Insertion Sort, Merge Sort
Reprenons la vidéo du MIT. Cette courte section formalise la mise en place de l'équation de récurrence que nous venons de décrire.
Regardez la section de 32:56 à 34:38. Elle fait le lien direct entre les étapes de l'algorithme et chaque terme de l'équation de récurrence.
b. Preuve par l'arbre de récurrence
Pour résoudre cette récurrence, la méthode la plus intuitive est celle de l'arbre de récurrence. On visualise les appels récursifs sous forme d'un arbre et on somme le travail effectué à chaque niveau.
L'image suivante représente cet arbre :
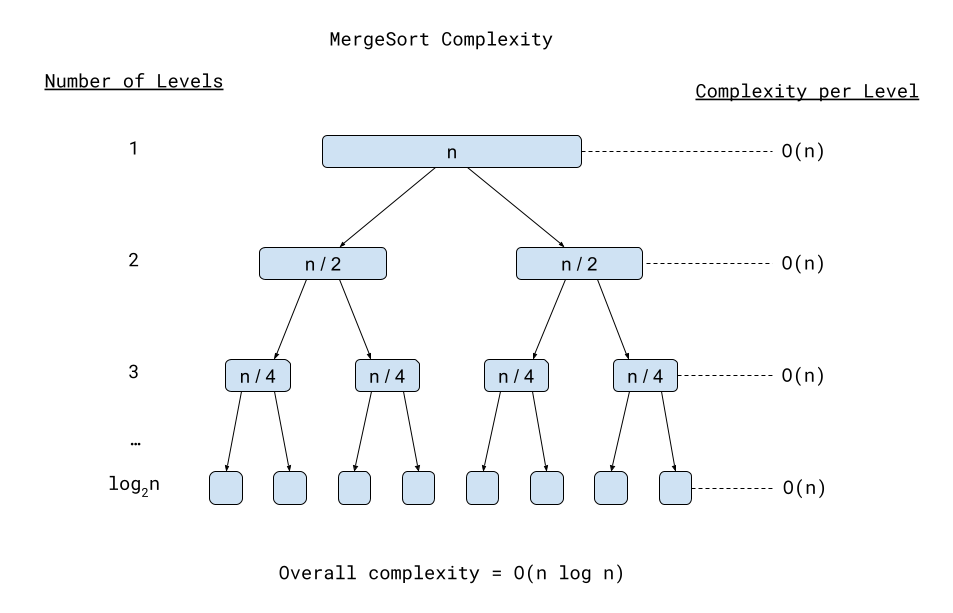
L'analyse est la suivante :
- Niveau 0 (racine) : On a un problème de taille . Le coût de la fusion à ce niveau est .
- Niveau 1 : On a deux sous-problèmes de taille . Le coût de chaque fusion est . Le coût total du niveau est .
- Niveau 2 : On a quatre sous-problèmes de taille . Le coût total du niveau est .
- ...
- Profondeur de l'arbre : On divise par 2 à chaque niveau jusqu'à atteindre la taille 1. Le nombre de niveaux (la hauteur de l'arbre) est donc .
Le coût total est la somme des coûts de chaque niveau. Puisque chaque niveau coûte et qu'il y a niveaux, la complexité totale est :
La complexité du tri fusion est donc . Cette performance est la même dans le meilleur, le pire et le cas moyen, car la division et la fusion se font toujours de la même manière, quelle que soit la disposition des données.
La vidéo suivante détaille cette preuve de manière très pédagogique.
Lecture 3: Insertion Sort, Merge Sort
Cette dernière section de la vidéo du MIT explique pas à pas la preuve par l'arbre de récurrence, en calculant la hauteur de l'arbre, le coût par niveau, et le coût total.
Regardez de 34:38 à 39:14. C'est la partie la plus importante pour la preuve. Assurez-vous de bien comprendre comment le coût total est obtenu en multipliant le coût par niveau par le nombre de niveaux.
Pour une approche plus formelle, sachez que cette récurrence est un cas d'application direct du Théorème Maître (Master Theorem), un outil puissant pour résoudre les récurrences de type "diviser pour régner". Le document [PDF] Leçon 903 que nous avons consulté plus tôt en fait la démonstration à la page 10. C'est une excellente lecture complémentaire pour consolider votre bagage théorique.
Conclusion
Le tri fusion est un algorithme fondamental qui illustre parfaitement la puissance de la stratégie "diviser pour régner".
À retenir :
- Principe : Décomposition récursive du tableau, suivie de la fusion des moitiés triées.
- Complexité temporelle : dans tous les cas (meilleur, pire, moyen). C'est un algorithme optimal pour les tris par comparaison.
- Complexité spatiale : en raison des tableaux auxiliaires nécessaires à la fusion. Ce n'est pas un tri en place.
- Stabilité : Le tri fusion est un algorithme stable.
En comparaison du tri par insertion, le tri fusion est asymptotiquement bien plus rapide, mais il consomme plus de mémoire. Pour de très petits tableaux, le coût de la récursivité et de l'allocation mémoire peut rendre le tri par insertion plus performant en pratique.
Dans la prochaine leçon, nous explorerons le tri rapide (quicksort). Il s'agit d'un autre algorithme "diviser pour régner" qui, bien que sa complexité dans le pire cas soit en , est souvent plus rapide en pratique que le tri fusion et peut être implémenté en place.