Bonjour,
Dans la leçon précédente, nous avons disséqué l'implémentation du tri rapide et l'importance capitale de sa fonction de partitionnement. Nous avons vu que le choix du pivot est déterminant, mais nous n'avons qu'effleuré les conséquences de ce choix sur la performance.
Aujourd'hui, nous allons analyser formellement la complexité temporelle du tri rapide. C'est une étape cruciale pour un futur agrégé, car elle révèle la dualité de cet algorithme : pourquoi est-il si rapide en pratique malgré un pire cas quadratique ? Notre objectif est d'analyser la complexité du tri rapide dans le meilleur cas, le cas moyen (intuitivement), et le pire cas. Cette analyse justifiera son nom et sa popularité.
1. La Relation de Récurrence Générale du Tri Rapide
Pour analyser un algorithme récursif comme le tri rapide, nous devons d'abord établir sa relation de récurrence. Rappelez-vous les trois étapes de "diviser pour régner" :
- Diviser : La fonction
partitionprend un temps proportionnel à la taille du sous-tableau, soit . Elle divise le tableau en deux sous-problèmes. - Régner : Deux appels récursifs sont effectués sur les sous-tableaux. Si la partition place le pivot à l'indice
k(créant un sous-tableau de tailleket un autre de taillen-k-1), le temps de cette étape est . - Combiner : Cette étape est triviale et prend un temps constant, .
En additionnant ces coûts, la complexité du tri rapide, , pour un tableau de taille peut s'écrire :
La performance de l'algorithme dépend entièrement de la valeur de à chaque appel, c'est-à-dire de l'équilibre des partitions générées par le pivot.
2. Analyse du Pire Cas : La Partition Déséquilibrée
Le pire scénario se produit lorsque le partitionnement est systématiquement le plus déséquilibré possible.
-
Scénario : Cela arrive si le pivot choisi est toujours le plus petit ou le plus grand élément du sous-tableau. Par exemple, si vous appliquez un tri rapide avec le dernier élément comme pivot sur un tableau déjà trié. La partition produira un sous-tableau de taille et un autre de taille 0.
-
Récurrence : En posant (ou ), la récurrence devient :
Pour comprendre comment cette situation mène à une complexité quadratique, la vidéo suivante l'explique de manière très visuelle.
Cette vidéo de Abdul Bari illustre le pire cas du tri rapide en montrant comment un tableau déjà trié conduit à des partitions totalement déséquilibrées.
Regardez la section de 05:55 à 08:05. Concentrez-vous sur la façon dont chaque appel de partition ne réduit la taille du problème que de 1.
Formalisons cette analyse par la méthode de substitution, une technique fondamentale que vous devez maîtriser. En supposant pour une constante :
L'arbre de récursion dans ce cas est complètement dégénéré, comme une simple liste.
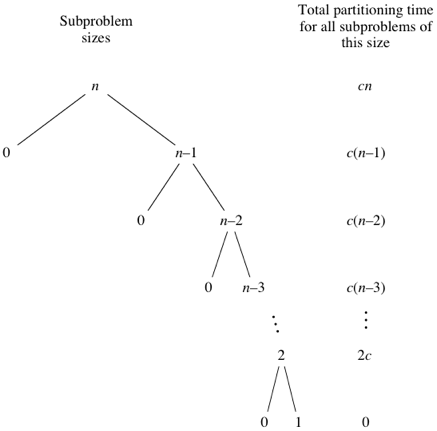
Le pire cas est donc aussi mauvais que celui du tri par insertion. Cela souligne pourquoi le choix naïf du pivot (toujours le premier ou le dernier) est dangereux en pratique.
3. Analyse du Meilleur Cas : La Partition Parfaite
Le meilleur cas se produit lorsque chaque partition est la plus équilibrée possible.
-
Scénario : Cela se produit si le pivot est toujours la médiane du sous-tableau. La partition divise alors le tableau en deux moitiés de taille à peu près égale, .
-
Récurrence : La récurrence devient :
Cette récurrence vous est familière : c'est la même que celle du tri fusion.
La même vidéo de Abdul Bari explique également le meilleur cas. Observez comment la structure de l'arbre de récursion change radicalement.
Regardez maintenant la première partie de la vidéo, de 00:00 à 04:16. Remarquez la similitude de l'analyse avec celle du tri fusion : un arbre équilibré de hauteur logarithmique.
Comme pour le tri fusion, la solution de cette récurrence est .
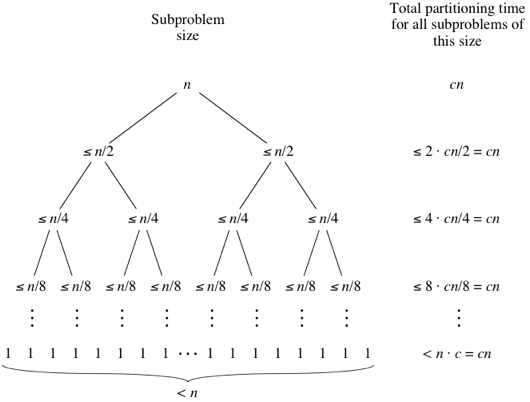
Bien que ce cas soit optimal, choisir la médiane comme pivot à chaque étape nécessite un algorithme de sélection en temps linéaire, ce qui compliquerait et ralentirait l'implémentation. La question est donc : que se passe-t-il entre ces deux extrêmes ?
4. Analyse du Cas Moyen : Le Cœur de la "Rapidité"
Le véritable intérêt du tri rapide réside dans sa performance moyenne exceptionnelle. L'analyse formelle est complexe, mais l'intuition est à la fois accessible et puissante.
Pourquoi le cas moyen est-il plus proche du meilleur cas que du pire ? L'idée clé est que nous n'avons pas besoin de partitions parfaitement équilibrées. Des partitions "raisonnablement" équilibrées suffisent.
Pour construire cette intuition, je vous propose de regarder la vidéo suivante qui l'aborde sous plusieurs angles.
Sorting 2, Video 5 Quicksort Average Case
Josh Hug, de l'UC Berkeley, offre une des meilleures explications intuitives de la complexité moyenne du tri rapide. Nous allons utiliser ses arguments.
Regardez les sections de 00:00 à 05:08. Concentrez-vous sur deux arguments principaux : L'argument de la partition 90-10 : que se passe-t-il même si le pivot est systématiquement 'mauvais' mais pas catastrophique ? L'analogie avec le tri par arbre binaire de recherche (BST) : une connexion profonde et élégante.
Synthétisons et formalisons légèrement ces arguments :
Argument 1 : Toute partition à proportion constante est bonne
Imaginons un cas d'apparence défavorable où le pivot génère systématiquement une partition 9-contre-1. La récurrence est :
L'arbre de récursion sera asymétrique. La branche la plus longue (la plus profonde) déterminera la hauteur de l'arbre. Cette profondeur est atteinte lorsque , soit . Comme , la hauteur est toujours .
Le coût total reste borné par (coût par niveau) (hauteur), soit .
Conclusion intuitive : Tant que le pivot n'est pas systématiquement dans les extrêmes, mais dans une zone "centrale" (même si elle est large, par ex. entre 1% et 99%), la profondeur de la récursion reste logarithmique, et la complexité globale reste . Pour un pivot choisi au hasard, la probabilité de tomber systématiquement dans les extrêmes est infime.
Argument 2 : L'analogie avec les arbres binaires de recherche (BST)
C'est un argument plus subtil. Considérez l'algorithme "BST-Sort" : insérer éléments dans un BST, puis faire un parcours infixe.
- Si les éléments sont insérés dans un ordre aléatoire, la hauteur moyenne de l'arbre est , et le coût total de construction est en moyenne .
- Il s'avère que l'ensemble des comparaisons effectuées par le tri rapide avec pivot aléatoire sur un tableau est exactement le même que l'ensemble des comparaisons effectuées lors de l'insertion des mêmes éléments dans un ordre aléatoire dans un BST.
Cette équivalence profonde implique que la complexité moyenne du tri rapide est également .
Pour aller plus loin : la preuve formelle
Les arguments ci-dessus sont des intuitions. La preuve rigoureuse, exigible au niveau de l'Agrégation, utilise des outils de probabilités plus avancés (variables indicatrices et linéarité de l'espérance). Elle consiste à calculer, pour toute paire d'éléments , la probabilité qu'ils soient comparés durant l'algorithme.
Je vous propose en lecture optionnelle (mais fortement recommandée) un document qui détaille cette preuve.
[PDF] Notes on Expected Runtime of Randomized Quicksort
Ce document présente la preuve formelle de la complexité attendue du tri rapide randomisé. C'est un excellent exemple du type de raisonnement mathématique que vous devez acquérir.
Lisez attentivement ce court document. L'idée clé est de décomposer le nombre total de comparaisons X en une somme de variables indicatrices X_jk pour chaque paire d'éléments, puis d'utiliser la linéarité de l'espérance. Essayez de bien comprendre pourquoi la probabilité que z_j et z_k soient comparés est exactement 2 / (k - j + 1).
Conclusion
Nous avons maintenant une vision complète de la performance du tri rapide.
Points clés à retenir :
- Pire cas : . Se produit avec des partitions totalement déséquilibrées (ex: tableau déjà trié avec un pivot naïf).
- Meilleur cas : . Se produit avec des partitions parfaitement équilibrées (pivot médian).
- Cas moyen (attendu) : . C'est le cas le plus important. Il s'explique par le fait que des partitions "moyennement" équilibrées suffisent à maintenir une profondeur de récursion logarithmique. Une randomisation du pivot rend le pire cas extrêmement improbable sur n'importe quelle entrée.
Le tri rapide est qualifié de "rapide" car sa complexité moyenne est excellente, et les constantes cachées dans la notation sont généralement plus petites que celles de ses concurrents comme le tri fusion ou le tri par tas. De plus, son fonctionnement "en place" (si l'on ignore la pile de récursion) le rend très efficace en termes de localité de la mémoire.
Prochaine étape :
Dans la prochaine leçon, nous allons introduire une nouvelle structure de données fondamentale : le tas binaire (heap). Cette structure nous permettra de construire un autre algorithme de tri majeur, le tri par tas (heapsort), qui, contrairement au tri rapide, garantit une complexité en dans tous les cas.