Bonjour et bienvenue dans ce nouveau module dédié à Pandas, la bibliothèque incontournable pour l'analyse et la manipulation de données en Python. Dans le module précédent sur NumPy, vous avez appris à manipuler des tableaux numériques, notamment en les concaténant. Vous avez vu que NumPy est extrêmement puissant pour les calculs, mais il atteint ses limites lorsque les données deviennent plus complexes et nécessitent des étiquettes, comme des noms de colonnes ou des index spécifiques.
Cette leçon est votre première étape dans le monde de Pandas. L'objectif est de vous apprendre à créer les deux structures de données fondamentales de Pandas : la Series et le DataFrame, en utilisant des objets Python de base que vous connaissez déjà, comme les listes et les dictionnaires. C'est le point de départ pour toute analyse de données en Python.
1. Pourquoi passer de NumPy à Pandas ?
Imaginez un tableau NumPy contenant des informations sur des maisons : [[2, 2], [1, 1]]. Que représentent ces chiffres ? Des chambres ? Des salles de bain ? Sans contexte, c'est impossible à dire. Pandas résout ce problème en introduisant des étiquettes (labels) pour les lignes et les colonnes, transformant les données brutes en informations structurées et lisibles.
La vidéo suivante explique très bien cette nécessité. Le présentateur compare un tableau de données dans Excel (avec des en-têtes de colonnes clairs) à ce que serait sa représentation dans un tableau NumPy, illustrant parfaitement pourquoi Pandas est indispensable.
Pandas Full Course (2025) | Python Pandas Tutorial For Beginners | Python Pandas Course |Intellipaat
Cette vidéo du cours complet sur Pandas par Intellipaat pose les bases en expliquant la raison d'être de la bibliothèque.
Regardez l'introduction de cette vidéo. Elle met en évidence le problème principal de NumPy pour l'analyse de données (le manque d'étiquettes) et présente Pandas comme la solution pour travailler avec des données tabulaires, à la manière d'un tableur.
Pandas introduit deux objets principaux pour gérer ces données étiquetées : la Series (pour une dimension) et le DataFrame (pour deux dimensions).
2. La Series : une colonne de données étiquetée
La structure la plus simple dans Pandas est la Series. Considérez-la comme un tableau NumPy à une dimension, mais avec un plus : un index explicite qui étiquette chaque élément. C'est l'équivalent d'une seule colonne dans un tableur.
Création d'une Series à partir d'une liste
La manière la plus simple de créer une Series est à partir d'une liste Python. Pandas assignera automatiquement un index numérique commençant à 0.
import pandas as pd


# Créer une Series de nombres
poids = pd.Series([65, 82, 58])
print(poids)
Résultat :
0    65
1    82
2    58
dtype: int64
Vous voyez ici les données (65, 82, 58) à droite et l'index (0, 1, 2) à gauche. dtype: int64 vous informe que Pandas a détecté que les données sont des entiers.
Le document suivant, en français, vous guidera à travers vos premiers pas avec la Series.
Introduction à Pandas - Python pour la data science
Cet article de "Python pour la data science" est une excellente ressource francophone pour commencer avec Pandas.
Concentrez-vous sur la section Avant le DataFrame. Elle vous montrera comment créer une Series à partir d'une liste, que ce soit avec des données numériques (poids) ou textuelles (animal).
Création d'une Series à partir d'un dictionnaire
Une méthode très pratique consiste à utiliser un dictionnaire. Dans ce cas, les clés du dictionnaire deviennent automatiquement l'index de la Series.
calories_par_jour = {
    'lundi': 2200,
    'mardi': 2500,
    'mercredi': 2100
}

calories_series = pd.Series(calories_par_jour)
print(calories_series)
Résultat :
lundi       2200
mardi       2500
mercredi    2100
dtype: int64
Comme vous le voyez, l'index est maintenant beaucoup plus parlant ('lundi', 'mardi', 'mercredi') que de simples chiffres. Cette vidéo concise vous montre visuellement la création à partir d'une liste et d'un dictionnaire.
Series in Pandas are easy! 1️⃣
Cette vidéo de Bro Code est une introduction rapide et claire à la Series Pandas.
Regardez ces trois courts extraits : Une explication de ce qu'est une Series et comment la créer à partir d'une liste. Une démonstration de la création à partir d'un dictionnaire, où les clés deviennent les labels.
3. Le DataFrame : la structure de données centrale
Si une Series est une colonne, un DataFrame est un tableau entier, avec des lignes et des colonnes étiquetées. C'est la structure de données la plus utilisée en Pandas et dans toute la data science avec Python. Vous pouvez le voir comme une collection de Series qui partagent le même index.
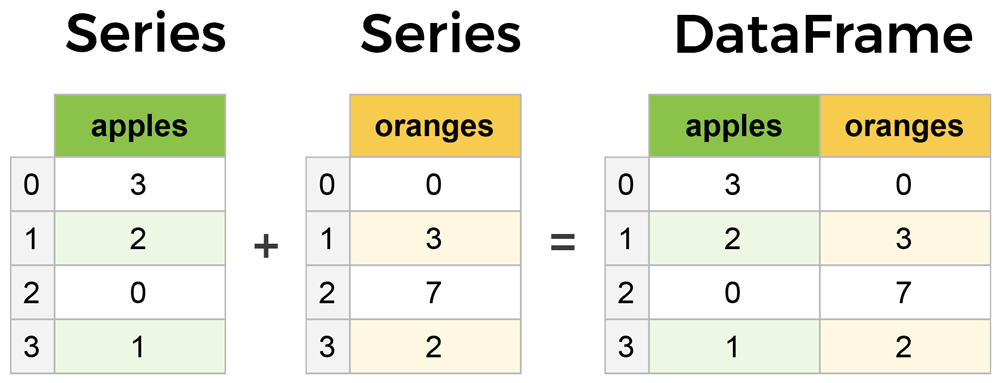
Il existe plusieurs façons de construire un DataFrame. Nous allons explorer les plus courantes.
Méthode 1 : À partir d'un dictionnaire de listes (la plus courante)
C'est la manière la plus intuitive de créer un DataFrame. Vous créez un dictionnaire où chaque clé est un nom de colonne et chaque valeur est une liste contenant les données de cette colonne.

L'article suivant de Real Python est une référence sur le sujet. Bien qu'il soit en anglais, les exemples de code sont universels et très clairs.
The pandas DataFrame: Make Working With Data Delightful
Cet article est un guide complet sur les DataFrames. Nous nous concentrerons sur sa création à partir d'objets Python.
Lisez la section Création avec des dictionnaires. Elle vous montrera comment passer d'un dictionnaire de listes à un DataFrame en une seule ligne de code avec pd.DataFrame().
Voici un exemple concret :
data = {
    'Nom': ['Jim', 'Dwight', 'Angela', 'Tobi'],
    'Age': [26, 28, 27, 32],
    'Département': ['Ventes', 'Ventes', 'Comptabilité', 'Ressources Humaines']
}

df_employes = pd.DataFrame(data)
print(df_employes)
Résultat :
      Nom  Age           Département
0     Jim   26                Ventes
1  Dwight   28                Ventes
2  Angela   27          Comptabilité
3    Tobi   32  Ressources Humaines
Méthode 2 : À partir d'un tableau NumPy
Puisque vous venez du module NumPy, il est utile de savoir que vous pouvez directement convertir un tableau NumPy 2D en DataFrame. C'est particulièrement pratique lorsque vous avez déjà effectué des calculs numériques.
The pandas DataFrame: Make Working With Data Delightful
Retournons à l'article de Real Python pour voir une autre méthode de création.
Lisez la section Création avec des tableaux NumPy. Vous remarquerez que vous devez fournir les noms de colonnes séparément via le paramètre columns.
import numpy as np


# Données sous forme de tableau NumPy
donnees_np = np.array([
    [25.1, 101.3, 60.2],
    [24.8, 101.1, 61.5]
])


# Noms des colonnes
colonnes = ['Température', 'Pression', 'Humidité']

df_meteo = pd.DataFrame(donnees_np, columns=colonnes)
print(df_meteo)
Résultat :
   Température  Pression  Humidité
0         25.1     101.3      60.2
1         24.8     101.1      61.5
Exercice Pratique
Maintenant, à vous de jouer ! Créez un DataFrame qui stocke des informations sur quelques villes. Le DataFrame doit avoir trois colonnes : "Ville", "Pays" et "Population" (en millions).
Utilisez la méthode du dictionnaire de listes pour créer ce DataFrame.
- Villes : Paris, Tokyo, Le Caire
- Pays : France, Japon, Égypte
- Populations : 2.1, 14.0, 9.5
Solution
import pandas as pd


# Dictionnaire contenant les données
donnees_villes = {
    'Ville': ['Paris', 'Tokyo', 'Le Caire'],
    'Pays': ['France', 'Japon', 'Égypte'],
    'Population': [2.1, 14.0, 9.5]
}


# Création du DataFrame
df_villes = pd.DataFrame(donnees_villes)


# Affichage du DataFrame
print(df_villes)
Résultat attendu :
      Ville    Pays  Population
0     Paris  France         2.1
1     Tokyo   Japon        14.0
2  Le Caire  Égypte         9.5
Conclusion
Félicitations ! Vous venez de franchir une étape clé en apprenant à créer les structures de données fondamentales de Pandas.
Points clés à retenir :
- Pandas est conçu pour travailler avec des données structurées et étiquetées, là où NumPy atteint ses limites.
- La
Seriesest un objet à une dimension (une colonne) avec un index. - Le
DataFrameest un objet à deux dimensions (un tableau) avec des index pour les lignes et les colonnes. C'est l'outil principal de l'analyste de données. - La méthode la plus courante pour créer un
DataFrameest d'utiliser un dictionnaire de listes, où les clés deviennent les noms des colonnes.
Savoir créer des DataFrames à partir de zéro est utile, mais dans la plupart des cas, vos données proviendront de fichiers externes. Dans la prochaine leçon, nous aborderons une tâche essentielle : charger des données à partir de fichiers CSV dans un DataFrame et apprendre les premières commandes pour inspecter rapidement leur contenu.