Bonjour ! Dans la leçon précédente, vous avez appris à remodeler des tableaux NumPy, une compétence essentielle pour préparer les données. Vous savez maintenant comment changer la forme d'un tableau pour qu'il soit compatible avec les exigences des modèles de machine learning.
Aujourd'hui, nous allons nous attaquer à l'opération inverse du découpage : l'assemblage. L'objectif de cette leçon est de vous apprendre à concaténer plusieurs tableaux NumPy le long d'un axe spécifique. Cette compétence est cruciale lorsque vous devez combiner des données provenant de différentes sources, par exemple en regroupant des lots de données d'entraînement ou en ajoutant de nouvelles caractéristiques (features) à un ensemble de données existant. C'est la dernière étape de notre exploration de NumPy avant de passer à des outils d'analyse de données plus spécialisés.
1. La Concaténation de Base avec np.concatenate
La fonction principale pour assembler des tableaux dans NumPy est np.concatenate(). Elle prend une séquence (généralement une liste ou un tuple) de tableaux et les joint les uns aux autres.
Commençons par le cas le plus simple : la concaténation de tableaux à une dimension (1D).
import numpy as np

array1 = np.array([1, 2, 3])
array2 = np.array([4, 5, 6])


# Concaténer les deux tableaux
combined_array = np.concatenate((array1, array2))

print(combined_array)


# Output: [1 2 3 4 5 6]
Comme vous pouvez le voir, la fonction a simplement ajouté les éléments de array2 à la fin de array1. Notez bien que les tableaux à concaténer sont passés dans un tuple (array1, array2).
La vidéo suivante vous montre très simplement comment utiliser cette fonction.
Learn NumPy in 1 Hour (Beginner Tutorial)
Cette vidéo de la chaîne Indently offre une introduction très claire à la concaténation.
Regardez la partie qui explique comment concaténer deux ou plusieurs tableaux. Remarquez que les tableaux sont passés en tant qu'itérables (un tuple dans leur exemple).
2. Le Concept Clé : l'Axe de Concaténation
Les choses deviennent plus intéressantes avec les tableaux à deux dimensions (2D). Faut-il empiler les tableaux verticalement (l'un en dessous de l'autre) ou les placer horizontalement (côte à côte) ? C'est là qu'intervient le paramètre axis.
axis=0: Concaténation le long du premier axe (les lignes). Les tableaux sont empilés verticalement.axis=1: Concaténation le long du deuxième axe (les colonnes). Les tableaux sont assemblés horizontalement.
L'image ci-dessous illustre parfaitement cette distinction.

La règle d'or de la concaténation est la suivante : les dimensions des tableaux doivent être identiques sur tous les axes, sauf sur l'axe de concaténation.
- Si vous concaténez avec
axis=0(verticalement), les tableaux doivent avoir le même nombre de colonnes. - Si vous concaténez avec
axis=1(horizontalement), les tableaux doivent avoir le même nombre de lignes.
a = np.array([[1, 2], [3, 4]])
b = np.array([[5, 6], [7, 8]])


# Concaténation verticale (le long des lignes)
vertical_concat = np.concatenate((a, b), axis=0)
print("Concaténation verticale (axis=0):\n", vertical_concat)


# Concaténation horizontale (le long des colonnes)
horizontal_concat = np.concatenate((a, b), axis=1)
print("\nConcaténation horizontale (axis=1):\n", horizontal_concat)
L'image suivante montre également le code correspondant à chaque type de concaténation.
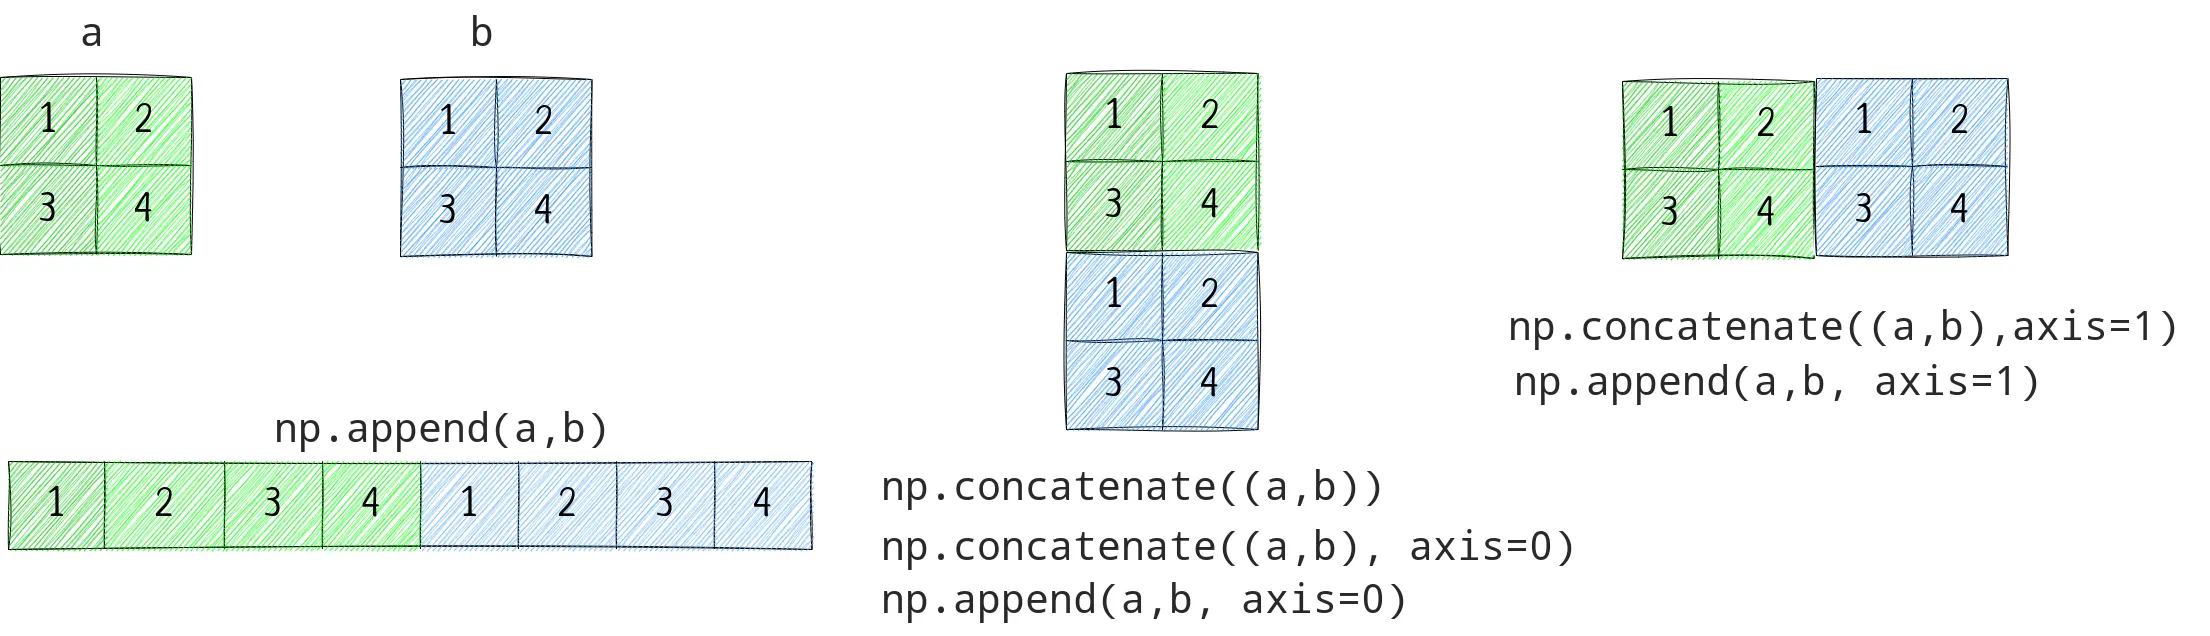
Pour approfondir ce concept fondamental, la lecture suivante détaille le fonctionnement de np.concatenate avec des exemples clairs.
NumPy: Concatenate arrays with np.concatenate, np.stack, etc.
Cet article de nkmk.me est une excellente référence sur les différentes fonctions de concaténation de NumPy.
Lisez la section np.concatenate(). Portez une attention particulière aux exemples avec axis=0 et axis=1, ainsi qu'aux ValueError qui se produisent lorsque les dimensions des tableaux ne sont pas compatibles.
3. Comprendre les Axes en Profondeur
La notion d'axe est l'une des plus importantes et parfois des plus déroutantes de NumPy. Elle ne s'applique pas seulement à la concaténation, mais à de nombreuses autres opérations (sommes, moyennes, etc.). Prendre le temps de bien la comprendre est un investissement très rentable.
La vidéo ci-dessous offre une explication détaillée de ce que sont les axes et comment ils fonctionnent lors d'opérations sur les tableaux. Même si l'exemple utilise la fonction sum(), le principe est exactement le même pour concatenate().
Learn NumPy in 40 Minutes - Python NumPy Tutorial
Dans cette vidéo de Tech With Tim, le présentateur prend le temps d'expliquer en détail le concept de dimensions et d'axes.
Regardez attentivement la section qui explique les dimensions et les axes. Il y montre comment axis=0 opère sur les colonnes (en "collapsant" les lignes) et comment axis=1 opère sur les lignes (en "collapsant" les colonnes). Cette analogie visuelle est très puissante.
4. Fonctions Utilitaires : vstack, hstack
Parce que la concaténation verticale et horizontale est si courante, NumPy fournit deux fonctions raccourcies très pratiques :
np.vstack()(vertical stack) : Équivaut ànp.concatenate(..., axis=0).np.hstack()(horizontal stack) : Équivaut ànp.concatenate(..., axis=1)pour les tableaux 2D.
a = np.array([[1, 2], [3, 4]])
b = np.array([[5, 6], [7, 8]])


# Equivalent à np.concatenate((a, b), axis=0)
print("Avec vstack:\n", np.vstack((a, b)))


# Equivalent à np.concatenate((a, b), axis=1)
print("\nAvec hstack:\n", np.hstack((a, b)))
Un avantage de vstack est qu'il peut intelligemment empiler des tableaux 1D pour former un tableau 2D, en les transformant d'abord en tableaux lignes. C'est une opération très courante.
row1 = np.array([1, 2, 3])
row2 = np.array([4, 5, 6])


# vstack transforme les tableaux 1D en lignes et les empile
feature_matrix = np.vstack((row1, row2))
print(feature_matrix)


# [[1 2 3]
#  [4 5 6]]
L'article que vous avez consulté précédemment couvre également ces fonctions si vous souhaitez revoir les détails.
5. Concaténer vs. Empiler : np.stack
Il existe une distinction subtile mais importante entre np.concatenate et np.stack.
np.concatenatejoint les tableaux le long d'un axe existant. Le nombre de dimensions ne change pas.np.stackempile les tableaux le long d'un nouvel axe. Le nombre de dimensions du tableau résultant augmente de un.
Par exemple, si vous empilez deux tableaux 1D de forme (3,), vous n'obtiendrez pas un tableau de forme (6,) comme avec concatenate, mais un tableau 2D de forme (2, 3).
a = np.array([1, 2, 3])
b = np.array([4, 5, 6])


# Empile les tableaux le long d'un nouvel axe (axis=0 par défaut)
stacked_array = np.stack((a, b))

print("Tableau empilé:\n", stacked_array)
print("Forme du tableau empilé:", stacked_array.shape) # (2, 3)
Cette opération est fondamentale en deep learning, où l'on empile souvent des exemples individuels (comme des images) pour former un "batch" (un lot) de données, ajoutant ainsi une dimension de "batch".
NumPy: Concatenate arrays with np.concatenate, np.stack, etc.
Cette section de l'article de nkmk.me explique clairement la différence entre concatenate et stack.
Lisez la section np.stack(). Concentrez-vous sur la manière dont l'opération stack sur des tableaux 1D produit un tableau 2D, et comment elle opère sur des tableaux 2D pour en produire un de 3D.
Exercice Pratique
Imaginez que vous collectez des données de capteurs. Un premier lot de données contient les mesures de température et de pression pour 3 échantillons. Un second lot contient les mêmes mesures pour 2 autres échantillons. Enfin, vous recevez les mesures d'humidité pour les 5 échantillons.
# Lot 1: température et pression pour 3 échantillons
batch1 = np.array([[25.1, 101.3],
                   [24.8, 101.1],
                   [25.3, 101.4]])


# Lot 2: température et pression pour 2 échantillons
batch2 = np.array([[24.9, 101.2],
                   [25.0, 101.3]])


# Humidité pour les 5 échantillons
humidity = np.array([[60.2], [61.5], [59.8], [62.1], [60.9]])
Vos tâches :
- Combinez
batch1etbatch2en un seul tableauall_datacontenant les mesures de température et de pression pour les 5 échantillons. - Ajoutez la colonne
humidityau tableauall_datapour obtenir un tableau finalfinal_datasetavec 3 colonnes : température, pression et humidité.
Solution
# 1. Combiner les deux lots verticalement (axis=0)
all_data = np.concatenate((batch1, batch2), axis=0)
print("Données combinées (température, pression) :\n", all_data)
print("Forme :", all_data.shape) # Doit être (5, 2)


# 2. Ajouter la colonne d'humidité horizontalement (axis=1)
final_dataset = np.concatenate((all_data, humidity), axis=1)
print("\nJeu de données final (température, pression, humidité) :\n", final_dataset)
print("Forme :", final_dataset.shape) # Doit être (5, 3)
Conclusion
Félicitations ! Vous avez terminé le module sur NumPy et maîtrisez désormais les opérations de base qui sont le fondement de presque tout le calcul scientifique en Python.
Points clés à retenir :
np.concatenate()est la fonction principale pour joindre des tableaux.- Le paramètre
axisest essentiel :axis=0pour un empilement vertical (par lignes) etaxis=1pour un assemblage horizontal (par colonnes). - Les dimensions des tableaux doivent correspondre, sauf sur l'axe de concaténation.
np.vstack()etnp.hstack()sont des raccourcis pratiques pour la concaténation verticale et horizontale.np.stack()est différent : il assemble les tableaux le long d'un nouvel axe, augmentant ainsi le nombre de dimensions.
Vous avez maintenant une base solide en NumPy. Cependant, pour l'analyse de données du monde réel, qui implique souvent des données tabulaires avec des étiquettes, des types de données mixtes et des valeurs manquantes, nous avons besoin d'un outil plus structuré.
Dans le prochain module, nous aborderons Pandas, une bibliothèque construite sur NumPy. Vous découvrirez le DataFrame, l'outil de prédilection des data scientists pour manipuler, nettoyer et analyser des données structurées.