Bonjour ! Dans la leçon précédente, nous avons appris à obtenir une évaluation robuste et fiable de la performance d'un modèle grâce à la validation croisée à k-plis (k-fold cross-validation). Nous savons maintenant que la moyenne des scores obtenus sur plusieurs "plis" est bien plus significative qu'un score unique issu d'une simple division train_test_split.
Cependant, cela ne répond qu'à la moitié de la question. Nous pouvons évaluer un modèle, mais comment l'améliorer ? Lorsque nous avons créé notre RandomForestClassifier, nous avons utilisé des paramètres par défaut ou arbitraires comme n_estimators=100. Est-ce le meilleur choix ? Et si 50, 200 ou même 500 arbres donnaient un meilleur résultat ?
Cette leçon vous apprendra à répondre à cette question. Nous allons découvrir comment optimiser les hyperparamètres d'un modèle pour en maximiser la performance. L'objectif est de vous rendre capable d'utiliser GridSearchCV de Scikit-learn, un outil puissant qui combine une recherche systématique avec la validation croisée que nous venons d'apprendre. C'est une compétence fondamentale pour construire des modèles de machine learning performants.
1. Qu'est-ce qu'un hyperparamètre ?
Avant de les optimiser, il est crucial de bien comprendre ce que sont les hyperparamètres. En machine learning, il existe deux types de "paramètres" :
- Les paramètres du modèle : Ce sont les valeurs que le modèle apprend pendant l'entraînement (
.fit()). Par exemple, dans une régression linéaire, les coefficients (les pentes) de la droite sont des paramètres. Dans un réseau de neurones, ce sont les poids. Nous ne les définissons pas manuellement. - Les hyperparamètres : Ce sont les "réglages" ou les "configurations" du modèle que nous, en tant que data scientists, devons définir avant de lancer l'entraînement. Pour un
RandomForestClassifier, des exemples typiques sontn_estimators(le nombre d'arbres),max_depth(la profondeur maximale de chaque arbre), oumin_samples_leaf(le nombre minimum d'échantillons dans une feuille).
Le choix des hyperparamètres a un impact direct et significatif sur la performance du modèle. Un bon jeu d'hyperparamètres peut faire la différence entre un modèle médiocre et un modèle très performant.
La vidéo suivante, en arabe, explique très clairement cette distinction et l'importance du réglage des hyperparamètres.
Hyperparameter Tuning in Scikit-learn || بالعربية
Cette vidéo de la chaîne "Ons أنس" introduit la notion d'hyperparamètres et les différencie des paramètres appris par le modèle.
Regardez la section qui définit les paramètres et les hyperparamètres en utilisant l'exemple de la régularisation. L'idée clé est que les hyperparamètres sont des réglages que nous fixons avant l'entraînement.
2. La recherche des meilleurs hyperparamètres
Comment trouver la meilleure combinaison d'hyperparamètres ? L'approche la plus intuitive serait d'essayer plusieurs combinaisons manuellement. Par exemple, pour un RandomForestClassifier, nous pourrions écrire des boucles imbriquées pour tester différentes valeurs de n_estimators et max_depth, et pour chaque combinaison, utiliser cross_val_score pour obtenir une évaluation robuste.
# Approche manuelle conceptuelle - NE PAS COPIER CE CODE
n_estimators_options = [50, 100, 150]
max_depth_options = [10, 20, None]
best_score = 0
best_params = {}

for n in n_estimators_options:
    for depth in max_depth_options:
        model = RandomForestClassifier(n_estimators=n, max_depth=depth, random_state=42)
        scores = cross_val_score(model, X, y, cv=5)
        average_score = scores.mean()

        if average_score > best_score:
            best_score = average_score
            best_params = {'n_estimators': n, 'max_depth': depth}

print(f"Meilleur score : {best_score}")
print(f"Meilleurs hyperparamètres : {best_params}")
Cette approche fonctionnerait, mais elle présente des inconvénients majeurs :
- Elle est fastidieuse et répétitive à écrire.
- Elle devient rapidement ingérable si l'on veut tester 3, 4 ou plus d'hyperparamètres (il faudrait 4 boucles imbriquées !).
- Le code est sujet aux erreurs.
Heureusement, il existe une méthode standardisée et bien plus élégante pour faire exactement cela : GridSearchCV.
Les vidéos suivantes illustrent bien cette approche manuelle et montrent pourquoi une solution automatisée est nécessaire.
Machine Learning Tutorial Python - 16: Hyper parameter Tuning (GridSearchCV)
La chaîne codebasics montre comment implémenter une recherche manuelle avec des boucles et souligne ses limites.
Regardez la partie où l'auteur utilise des boucles for imbriquées pour tester différentes combinaisons de kernel et C pour un modèle SVM. Notez qu'il mentionne que cela devient vite compliqué avec plus de paramètres.
3. GridSearchCV : La recherche par grille automatisée
Le nom GridSearchCV décompose parfaitement son fonctionnement :
- Grid Search (Recherche par grille) : Vous définissez une "grille" d'hyperparamètres. Il s'agit simplement d'un dictionnaire où les clés sont les noms des hyperparamètres et les valeurs sont des listes de valeurs que vous souhaitez tester.
GridSearchCVva alors tester chaque combinaison possible de ces valeurs de manière exhaustive. - CV (Cross-Validation) : Pour chaque combinaison d'hyperparamètres,
GridSearchCVn'entraîne pas le modèle une seule fois. Il utilise la validation croisée à k-plis (que nous avons vue dans la leçon précédente) pour obtenir une évaluation robuste de la performance de cette combinaison.
À la fin, GridSearchCV vous indique quelle combinaison a obtenu le meilleur score moyen de validation croisée. Il combine donc une recherche systématique avec notre méthode d'évaluation robuste.
L'article suivant décrit très bien le processus.
Mastering Hyperparameter Tuning with GridSearchCV in ...
Cet article de AlliedOffsets détaille le flux de travail de GridSearchCV.
Concentrez-vous sur la section Workflow of GridSearchCV. Elle décompose le processus en 5 étapes claires que nous allons suivre : définir le modèle, définir l'espace des hyperparamètres (la grille), définir le schéma de validation croisée, exécuter la recherche et évaluer le meilleur modèle.
4. Mise en pratique avec Scikit-learn
Mettons en œuvre le flux de travail décrit ci-dessus. Nous utiliserons un RandomForestClassifier sur le jeu de données du cancer du sein.
Étape 1 : Charger les données et définir le modèle de base
Nous chargeons les données et créons une instance de notre classificateur, sans nous soucier des hyperparamètres pour le moment.
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.ensemble import RandomForestClassifier


# Charger les données et les diviser
cancer = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, random_state=42)


# Définir le modèle de base
rf = RandomForestClassifier(random_state=42)
Étape 2 : Définir la grille d'hyperparamètres
C'est ici que nous spécifions les valeurs à tester. Nous créons un dictionnaire.
# Définir la grille de paramètres à tester
param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [10, 20, None],
    'min_samples_leaf': [1, 2, 4]
}
Dans cet exemple, GridSearchCV testera 3 * 3 * 3 = 27 combinaisons différentes.
Étape 3 : Instancier et exécuter GridSearchCV
Nous créons un objet GridSearchCV en lui passant notre modèle, la grille de paramètres et le nombre de plis pour la validation croisée (cv=5).
# Instancier GridSearchCV
grid_search = GridSearchCV(estimator=rf, param_grid=param_grid, cv=5, n_jobs=-1, verbose=2)


# Lancer la recherche. 'verbose=2' affiche la progression.
# 'n_jobs=-1' utilise tous les cœurs du processeur pour accélérer le calcul.
grid_search.fit(X_train, y_train)
Lorsque vous lancez .fit(), GridSearchCV effectue un travail considérable :
- Pour chacune des 27 combinaisons, il effectue une validation croisée à 5 plis.
- Cela signifie qu'il entraîne et évalue 27 * 5 = 135 modèles !
- Il enregistre le score moyen pour chaque combinaison.
Étape 4 : Analyser les résultats
Une fois l'entraînement terminé, GridSearchCV met à notre disposition plusieurs attributs très utiles :
# Afficher les meilleurs hyperparamètres trouvés
print(f"Meilleurs hyperparamètres : {grid_search.best_params_}")


# Afficher le meilleur score de validation croisée obtenu
print(f"Meilleur score CV : {grid_search.best_score_:.4f}")


# L'objet `best_estimator_` est un nouveau modèle,
# automatiquement ré-entraîné sur TOUT X_train avec les meilleurs paramètres.
# Il est prêt à être utilisé pour la prédiction.
best_rf_model = grid_search.best_estimator_


# Évaluer le modèle final sur l'ensemble de test
test_score = best_rf_model.score(X_test, y_test)
print(f"Score sur l'ensemble de test : {test_score:.4f}")
L'article et la vidéo ci-dessous vous montrent un exemple pratique très similaire, de la définition de la grille à l'analyse des résultats.
Grid Search vs Random Search: Which One Should You ...
Cet article de TrainInDaita fournit un exemple complet de GridSearchCV sur le même jeu de données.
Suivez l'exemple de code : La section "Loading the Dataset" prépare les données, comme nous l'avons fait. La section "Defining the Hyperparameter Grid" montre comment définir la grille. La section "Model Training and Evaluation with Grid Search" vous guide à travers l'instanciation de GridSearchCV, son entraînement et l'interprétation des résultats.
Hyperparameter Tuning in Scikit-learn || بالعربية
La même vidéo en arabe explique comment passer de la méthode manuelle à GridSearchCV.
Regardez la démonstration de GridSearchCV ici. Elle montre comment définir la param_grid, instancier l'objet GridSearchCV, l'entraîner, et surtout, comment accéder aux résultats best_params_, best_score_ et best_estimator_.
5. Avantages, inconvénients et alternatives
GridSearchCV est un outil puissant, mais il est important de comprendre ses compromis.
Avantages :
- Exhaustif : Il garantit de trouver la meilleure combinaison d'hyperparamètres au sein de la grille que vous avez spécifiée.
- Facile à utiliser : L'API de Scikit-learn est simple et s'intègre parfaitement dans le flux de travail existant.
Inconvénient :
- Coût de calcul : Le nombre de combinaisons à tester augmente de manière exponentielle avec le nombre d'hyperparamètres. Si vous testez 5 hyperparamètres avec 5 valeurs chacun, cela fait combinaisons ! Avec une validation croisée à 5 plis, cela représente plus de 15 000 entraînements de modèles. Cela peut devenir très lent.
Alternative : RandomizedSearchCV
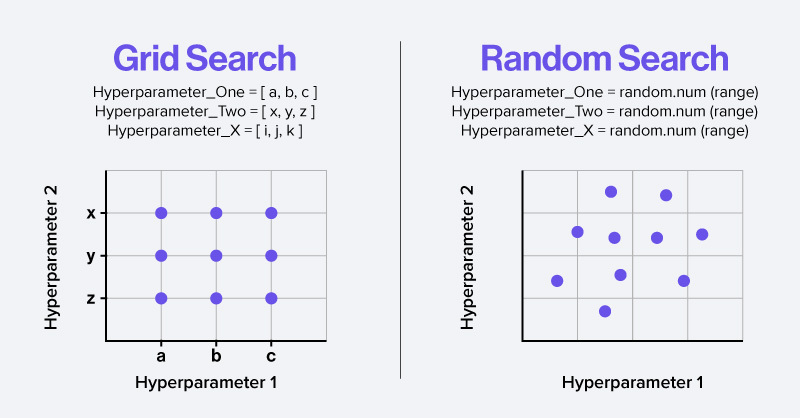
Lorsque la grille de recherche est très grande, GridSearchCV peut être trop lent. Une alternative populaire est RandomizedSearchCV. Au lieu de tester toutes les combinaisons, RandomizedSearchCV en teste un nombre fixe (n_iter) choisi au hasard à partir de distributions de valeurs que vous spécifiez.
- Grid Search : teste systématiquement chaque point d'une grille prédéfinie.
- Random Search : "pioche" un nombre fixe de points au hasard dans un espace de recherche plus large.
Cette approche est souvent plus efficace. En explorant plus largement l'espace des hyperparamètres, elle a de bonnes chances de trouver une très bonne combinaison beaucoup plus rapidement, même si ce n'est pas mathématiquement la meilleure possible.
Les images ci-dessous illustrent parfaitement cette différence.

La vidéo que nous avons déjà vue introduit également RandomizedSearchCV comme une solution au problème de coût de calcul de GridSearchCV.
Hyperparameter Tuning in Scikit-learn || بالعربية
Cette section de la vidéo présente RandomizedSearchCV comme une alternative efficace.
Regardez l'explication de RandomizedSearchCV ici. Notez le paramètre clé n_iter, qui contrôle le nombre de combinaisons aléatoires à tester, vous permettant de maîtriser le budget de calcul.
Conclusion
Félicitations ! Vous avez maintenant une compétence essentielle de plus dans votre boîte à outils de machine learning. Vous ne vous contentez plus d'évaluer des modèles, vous pouvez désormais les optimiser systématiquement pour en extraire les meilleures performances.
Points clés à retenir :
- Les hyperparamètres sont les réglages d'un modèle que nous définissons avant l'entraînement.
- Leur optimisation, ou tuning, est cruciale pour la performance du modèle.
GridSearchCVautomatise ce processus en combinant une recherche par grille exhaustive avec la validation croisée pour une évaluation robuste.- Le processus implique de définir un modèle, une grille de paramètres (
param_grid), et d'utiliser.fit()sur l'objetGridSearchCV. - Les résultats sont facilement accessibles via
.best_params_,.best_score_, et.best_estimator_. - Le principal inconvénient est le coût de calcul, qui peut être atténué par des alternatives comme
RandomizedSearchCVpour les grands espaces de recherche.
Maintenant que nous savons évaluer et optimiser rigoureusement nos modèles, nous sommes prêts à explorer des algorithmes plus complexes et puissants. Dans la prochaine leçon, nous aborderons le Gradient Boosting, un algorithme très performant qui bénéficie grandement d'un bon réglage des hyperparamètres.