Bonjour ! Dans la leçon précédente, nous avons construit un modèle de forêt aléatoire, qui est nettement plus performant qu'un simple arbre de décision. Nous avons terminé sur une question cruciale : comment savoir si la précision de 96,5 % que nous avons obtenue est fiable ? Après tout, cette précision dépend du random_state que nous avons utilisé pour notre train_test_split. Un autre random_state aurait pu nous donner un score différent, peut-être meilleur, peut-être pire.
Cette leçon aborde ce problème fondamental. Nous allons apprendre une technique beaucoup plus robuste pour évaluer nos modèles : la validation croisée à k-plis (k-fold cross-validation). L'objectif est de vous permettre d'appliquer cette méthode pour obtenir une estimation fiable et stable des performances de vos modèles, ce qui est une compétence essentielle pour tout praticien du machine learning.
1. Le problème d'une seule division (Train-Test Split)
Jusqu'à présent, nous avons toujours évalué nos modèles en divisant nos données une seule fois en un ensemble d'entraînement et un ensemble de test.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Le problème est que cette division est aléatoire. Selon la "chance" que nous avons eue lors de la division, l'ensemble de test peut contenir des exemples particulièrement "faciles" ou particulièrement "difficiles".
- Scénario "chanceux" : Tous les exemples difficiles se retrouvent dans
X_train. Le modèle apprend à les gérer, et l'ensembleX_testne contient que des cas simples. Le score de précision sera artificiellement élevé et trop optimiste. - Scénario "malchanceux" : Par hasard, beaucoup d'exemples difficiles ou atypiques se retrouvent dans
X_test. Le modèle n'a pas eu l'occasion d'apprendre de cas similaires et son score de précision sera injustement bas.
Dans les deux cas, le score que nous obtenons n'est pas une mesure fiable de la capacité du modèle à généraliser sur de nouvelles données inconnues. Il reflète simplement sa performance sur cette division particulière.
La vidéo suivante de StatQuest explique très clairement pourquoi nous avons besoin d'une meilleure approche que cette simple division.
Machine Learning Fundamentals: Cross Validation
Cette vidéo de Josh Starmer illustre les limites d'une division unique et introduit l'idée de la validation croisée.
Regardez d'abord la critique de la méthode de division simple ici. L'idée est que le choix du bloc de test est arbitraire. Ensuite, suivez l'explication intuitive de la solution ici, qui consiste à utiliser successivement chaque bloc pour le test.
2. La solution : la validation croisée à k-plis (K-Fold Cross-Validation)
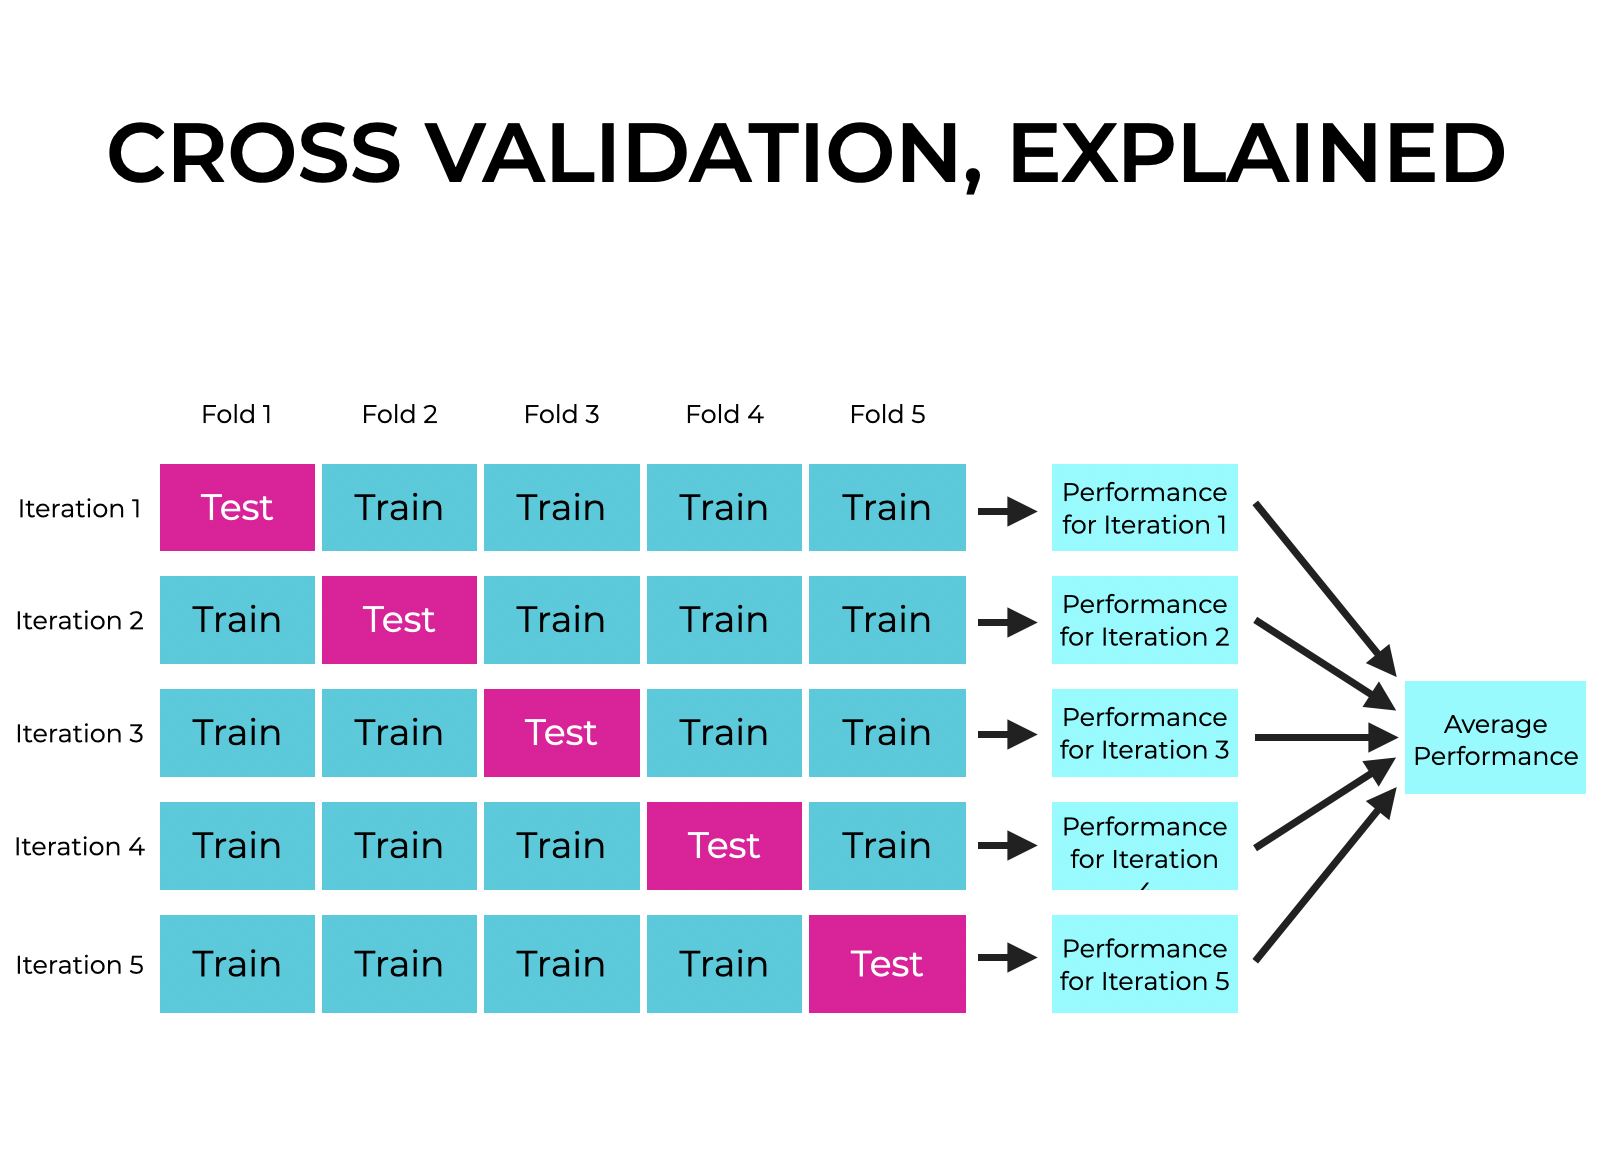
Plutôt que de faire une seule division, l'idée de la validation croisée est d'en faire plusieurs et de moyenner les résultats. La méthode la plus courante est la validation croisée à k-plis (ou k-folds). Voici comment elle fonctionne :
- Diviser : On divise l'ensemble de données d'entraînement en
ksous-ensembles de taille égale, appelés "plis" (folds). Une valeur commune pourkest 5 ou 10. - Itérer : On effectue
kitérations. À chaque itération :- On choisit un pli pour servir d'ensemble de test (ou de validation).
- On utilise les
k-1autres plis pour former l'ensemble d'entraînement. - On entraîne le modèle sur l'ensemble d'entraînement et on l'évalue sur l'ensemble de test, puis on enregistre le score.
- Moyenne : Après les
kitérations, nous avonskscores de performance. La performance finale du modèle est la moyenne de ceskscores.
L'image suivante illustre parfaitement ce processus pour k=5 :
L'article suivant, en arabe, explique ce concept en détail.
ما هو التحقق المتقاطع في التعلم الآلي؟ - الدكتور علاء طعيمة
Cet article du Dr. Alaa Taimeh fournit une excellente explication conceptuelle de la validation croisée.
Lisez les sections suivantes : "ما هو التحقق المتقاطع ؟" pour comprendre la définition et le processus itératif avec un exemple à 5 plis. "مزايا وعيوب استخدام التحقق المتقاطع" pour saisir pourquoi cette méthode est supérieure à une division unique (estimation plus stable, meilleure utilisation des données) et quel est son principal inconvénient (coût de calcul).
3. Validation croisée vs. Division simple
Pour bien consolider votre compréhension, comparons directement les deux approches.
| Aspect | Validation Croisée à k-plis | Division Entraînement/Test simple |
|---|---|---|
| Utilisation des données | Chaque point de donnée est utilisé à la fois pour l'entraînement et pour le test (dans des itérations différentes). | Une partie des données (ex: 25%) n'est jamais utilisée pour l'entraînement. |
| Estimation de la performance | Fournit une estimation robuste et stable (moyenne de k scores). Moins sensible au hasard. |
Fournit une estimation bruyante et variable. Dépend fortement de la division aléatoire initiale. |
| Risque de surapprentissage | Risque plus faible, car le modèle est évalué sur l'ensemble des données. | Risque plus élevé si la division de test est "trop facile". |
| Coût de calcul | Plus élevé. Le modèle est entraîné k fois. |
Faible. Le modèle est entraîné une seule fois. |
Ce tableau est inspiré de l'excellent article suivant de DigitalOcean, qui propose également une comparaison claire.
Understand K-Fold Cross-Validation:A Step-by-Step Guide | DigitalOcean
Cet article offre une comparaison directe entre les deux méthodes d'évaluation.
Étudiez le tableau comparatif dans la section "K-Fold vs. Train-Test Split". Il résume efficacement les compromis entre les deux approches.
4. Application avec Scikit-learn
Heureusement, Scikit-learn rend la validation croisée extrêmement simple à mettre en œuvre. Il n'est pas nécessaire d'écrire la boucle manuellement. On utilise la fonction cross_val_score.
Cette fonction prend en arguments :
estimator: L'instance de votre modèle (ex:RandomForestClassifier()).X: L'ensemble de vos caractéristiques.y: L'ensemble de vos cibles.cv: Le nombre de plis (lek).
Elle s'occupe de tout le processus de division, d'entraînement et de test itératif, puis retourne un tableau NumPy contenant les k scores.
Appliquons cela à notre classificateur de forêt aléatoire de la leçon précédente.
# 1. Importer les bibliothèques
import numpy as np
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.ensemble import RandomForestClassifier


# 2. Charger les données (cette fois, nous n'avons pas besoin de les diviser nous-mêmes)
data = load_breast_cancer()
X = data.data
y = data.target


# 3. Créer une instance du modèle
# Nous utilisons les mêmes paramètres que dans la leçon précédente
rf_classifier = RandomForestClassifier(n_estimators=100, random_state=42)


# 4. Évaluation avec une seule division (l'ancienne méthode)
# Nous le faisons juste pour comparer
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
rf_classifier.fit(X_train, y_train)
single_split_score = rf_classifier.score(X_test, y_test)
print(f"Score avec une seule division (train_test_split) : {single_split_score:.4f}\n")


# 5. Évaluation avec la validation croisée à 5 plis (la nouvelle méthode robuste)
# cross_val_score utilise l'intégralité de X et y
scores = cross_val_score(rf_classifier, X, y, cv=5) # cv=5 signifie 5 plis

print(f"Scores pour chaque pli : {scores}")
print(f"Précision moyenne avec la validation croisée : {scores.mean():.4f}")
print(f"Écart-type des scores : {scores.std():.4f}")
Analyse des résultats :
- Le score de la division unique vous donne un seul chiffre, par exemple
0.9649. C'est le résultat "chanceux" ou "malchanceux" que nous avons obtenu avecrandom_state=42. - La validation croisée vous donne un tableau de 5 scores, par exemple
[0.973, 0.947, 0.956, 0.938, 0.982]. - La moyenne (
.mean()) de ces scores, environ0.959, est une estimation beaucoup plus fiable de la performance réelle de votre modèle. C'est le chiffre que vous devriez rapporter. - L'écart-type (
.std()) vous indique la variabilité des scores entre les plis. Un faible écart-type signifie que la performance du modèle est stable, quelle que soit la partie des données utilisée pour le test.
Les vidéos et articles suivants montrent également comment utiliser cross_val_score en pratique.
Machine Learning Tutorial Python 12 - K Fold Cross Validation
Cette vidéo de codebasics montre comment passer d'une implémentation manuelle de la validation croisée à l'utilisation simple et directe de cross_val_score.
Regardez la section qui introduit cross_val_score comme un moyen prêt à l'emploi pour faire exactement ce que nous venons de discuter.
Understand K-Fold Cross-Validation:A Step-by-Step Guide | DigitalOcean
La section d'implémentation de cet article vous guide à travers un exemple complet.
Suivez les étapes 1 à 5 pour voir un autre exemple complet, de l'importation des données à l'appel de cross_val_score sur un autre jeu de données.
Conclusion
Aujourd'hui, vous avez appris une technique fondamentale pour évaluer rigoureusement les modèles de machine learning. Au lieu de vous fier à un score unique et potentiellement trompeur, vous pouvez maintenant calculer une estimation de performance robuste et fiable.
Points clés à retenir :
- Une simple division
train_test_splitproduit une estimation de performance variable et peu fiable, car elle dépend de la répartition aléatoire des données. - La validation croisée à k-plis (k-fold cross-validation) résout ce problème en créant
kdivisions des données, en entraînantkmodèles et en moyennant leurs scores. - Le résultat est une estimation plus stable et réaliste de la capacité du modèle à généraliser.
- Le principal inconvénient est un coût de calcul plus élevé, car on entraîne
kmodèles au lieu d'un seul. - Dans Scikit-learn, la fonction
cross_val_scoreimplémente ce processus de manière simple et efficace.
Maintenant que nous disposons d'une méthode robuste pour évaluer un modèle, nous pouvons aborder la question posée à la fin de la leçon précédente : comment trouver la meilleure combinaison d'hyperparamètres pour notre modèle ? Dans la prochaine leçon, nous verrons comment combiner la puissance de la validation croisée avec une recherche systématique pour optimiser nos modèles à l'aide de GridSearchCV.