Bonjour ! Dans la leçon précédente, nous avons vu comment optimiser les "réglages" d'un modèle, les hyperparamètres, à l'aide de GridSearchCV. Vous savez maintenant comment transformer un bon modèle en un excellent modèle en recherchant systématiquement la meilleure configuration possible.
Jusqu'à présent, nous avons surtout travaillé avec des forêts aléatoires (Random Forest), un modèle d'ensemble où de nombreux arbres de décision sont entraînés indépendamment les uns des autres avant de "voter" pour la prédiction finale. Aujourd'hui, nous allons explorer une autre approche d'ensemble, encore plus puissante : le Gradient Boosting. Contrairement aux forêts aléatoires, le Gradient Boosting construit ses arbres de manière séquentielle, chaque nouvel arbre ayant pour mission de corriger les erreurs du précédent.
L'objectif de cette leçon est de vous faire comprendre le mécanisme intuitif et puissant du Gradient Boosting, puis de vous montrer comment l'implémenter avec Scikit-learn. Cette technique est l'une des plus performantes pour les données tabulaires (comme celles que l'on trouve dans des fichiers CSV), et sa maîtrise est une compétence clé en machine learning.
1. L'idée fondamentale : Apprendre de ses erreurs
La principale différence entre une forêt aléatoire et le Gradient Boosting réside dans la manière dont les arbres collaborent.
- Forêt Aléatoire (Random Forest) : Imaginez un groupe d'experts qui étudient un problème chacun de leur côté, puis se réunissent pour voter. Chaque arbre est un "expert" indépendant.
- Gradient Boosting : Imaginez une chaîne d'experts. Le premier expert fait une première ébauche de prédiction. Le deuxième expert ne regarde pas le problème initial, mais se concentre uniquement sur les erreurs commises par le premier. Il tente de prédire ces erreurs. Le troisième expert se concentre sur les erreurs restantes, et ainsi de suite. La prédiction finale est la somme du travail de tous ces experts.
Cette approche séquentielle, où chaque nouveau modèle corrige les lacunes des précédents, est ce qu'on appelle le boosting.
La vidéo suivante, en arabe, explique très bien cette idée de construire des arbres pour prédire l'erreur des arbres précédents.
شرح مبسط بالعربي Most advanced Machine learning model XGBoost, CatBoost, LightGBM, Adaboost S05E05
Cette vidéo de la chaîne "أجياد العرب" donne une excellente intuition de la différence entre les algorithmes de boosting.
Concentrez-vous sur la section qui explique le Gradient Boosting. L'idée clé est la suivante : on construit un premier arbre, on calcule son erreur, puis on construit un deuxième arbre qui a pour objectif de prédire cette erreur.
Visuellement, on peut représenter ce processus comme une accumulation de modèles, où chaque nouveau modèle ajuste la prédiction globale pour se rapprocher de la vérité.

2. Le mécanisme du Gradient Boosting pas à pas
Maintenant que nous avons l'intuition, plongeons un peu plus dans le mécanisme, en prenant l'exemple d'un problème de régression (prédire une valeur numérique).
Le processus se déroule en plusieurs étapes itératives :
-
Faire une première prédiction simple : Au tout début, le modèle n'a aucune information. La meilleure première estimation est donc simplement la moyenne de toutes les valeurs cibles (
y) de l'ensemble d'entraînement. C'est notre prédiction initiale, . -
Calculer les erreurs (résidus) : Pour chaque point de données, on calcule la différence entre la valeur réelle observée et notre prédiction actuelle. C'est ce qu'on appelle le résidu.
Ces résidus représentent tout ce que notre modèle ne parvient pas encore à expliquer.
-
Entraîner un nouvel arbre sur les résidus : C'est l'étape cruciale. On entraîne un nouvel arbre de décision (un "apprenant faible", ou weak learner) non pas pour prédire la cible originale
y, mais pour prédire les résidus calculés à l'étape précédente. Cet arbre apprend donc à modéliser les erreurs de notre modèle actuel. -
Mettre à jour la prédiction globale : On ajoute la prédiction de ce nouvel arbre à notre prédiction globale. Cependant, pour éviter de corriger trop brutalement et de sur-ajuster (
overfitting), on ne prend qu'une petite fraction de cette nouvelle prédiction. Cette fraction est contrôlée par un hyperparamètre très important : le taux d'apprentissage (learning_rate). -
Répéter : On retourne à l'étape 2 avec nos nouvelles prédictions globales, on calcule les nouveaux résidus (qui devraient être plus faibles), on entraîne un nouvel arbre sur ces nouvelles erreurs, et ainsi de suite.
On répète ce processus pour un nombre défini d'arbres (n_estimators), chaque arbre affinant progressivement la prédiction globale.
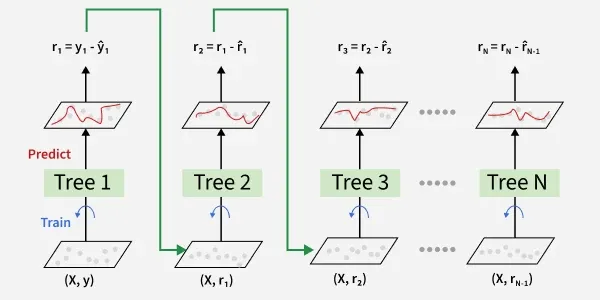
L'article et la vidéo ci-dessous détaillent ce processus de manière très claire et rigoureuse.
A Guide to The Gradient Boosting Algorithm
Cet article de DataCamp offre un excellent guide pas à pas du fonctionnement de l'algorithme.
Lisez attentivement la section The Gradient Boosting Algorithm: A Step-by-Step Guide. Elle vous guidera à travers un exemple simple en utilisant un jeu de données de ventes. Portez une attention particulière aux étapes : Make an initial prediction (la moyenne). Calculate the pseudo-residuals (les erreurs). Build a weak learner (un arbre entraîné sur les résidus). Faites bien le lien entre ces étapes et celles que nous venons de décrire.
Gradient Boost Part 2 (of 4): Regression Details
Cette vidéo de StatQuest with Josh Starmer est une référence pour comprendre les détails de l'algorithme du Gradient Boost pour la régression.
Regardez les segments suivants pour visualiser chaque étape en détail : L'initialisation du modèle avec la moyenne de la cible. Le calcul des pseudo-résidus, qui sont simplement la différence entre l'observé et le prédit. La construction d'un arbre pour prédire ces résidus. Le calcul des valeurs de sortie pour chaque feuille de l'arbre. La mise à jour de la prédiction en utilisant le taux d'apprentissage (learning rate).
Une note sur le "Gradient" : Le nom "Gradient Boosting" vient du fait que ce processus de chasse aux résidus est en réalité une manière astucieuse de faire de la descente de gradient. Les "pseudo-résidus" sont mathématiquement équivalents au gradient (la direction de la plus forte pente) de la fonction de perte. Chaque arbre que nous ajoutons nous fait faire un pas dans la direction opposée du gradient, minimisant ainsi l'erreur globale. C'est un concept avancé, mais il est bon de savoir d'où vient le nom !
3. Les hyperparamètres clés à optimiser
Comme vous pouvez l'imaginer, la performance d'un modèle Gradient Boosting dépend fortement de ses hyperparamètres. Grâce à la leçon précédente sur GridSearchCV, vous êtes parfaitement équipé pour les optimiser ! Voici les plus importants :
n_estimators: Le nombre total d'arbres à construire séquentiellement. Plus il y a d'arbres, plus le modèle peut devenir complexe et performant, mais attention à l'overfitting et au temps de calcul.learning_rate: Le taux d'apprentissage (ou "shrinkage"). C'est peut-être l'hyperparamètre le plus important. Il contrôle la contribution de chaque arbre. Une petite valeur (ex: 0.1, 0.05) signifie que chaque arbre contribue peu, ce qui rend le modèle plus robuste à l'overfitting, mais nécessite généralement un plus grandn_estimators.max_depth: La profondeur maximale de chaque arbre de décision individuel. Des arbres peu profonds (ex:max_depth=3) sont la norme pour le Gradient Boosting, car on veut que chaque arbre soit un "apprenant faible" qui ne capture qu'une petite partie du signal.
Ces trois paramètres sont interconnectés. Typiquement, si vous baissez le learning_rate, vous devez augmenter le n_estimators pour atteindre une bonne performance.
L'article de DataCamp et la vidéo en arabe expliquent très bien ces hyperparamètres.
A Guide to The Gradient Boosting Algorithm
Revenons à l'article de DataCamp pour une description des hyperparamètres.
Lisez la section Configuring Gradient Boosting Models. Elle décrit les paramètres que nous venons de voir (learning_rate, n_estimators, max_depth) et quelques autres utiles pour la régularisation.
شرح مبسط بالعربي Most advanced Machine learning model XGBoost, CatBoost, LightGBM, Adaboost S05E05
La vidéo en arabe que nous avons vue précédemment contient également une excellente section sur les hyperparamètres.
Regardez la discussion sur les hyperparamètres les plus importants. L'auteur explique très bien la relation entre le learning_rate, la profondeur de l'arbre (tree_depth) et le nombre d'arbres.
4. Mise en pratique avec Scikit-learn
Maintenant, mettons tout cela en pratique. Nous allons utiliser GradientBoostingClassifier de Scikit-learn pour un problème de classification. L'API est très similaire à celle des autres modèles que vous connaissez déjà.
Nous allons suivre une procédure robuste en utilisant un Pipeline pour combiner le pré-traitement et le modèle, ce qui est une excellente pratique.
import pandas as pd
import seaborn as sns
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report


# 1. Charger et préparer les données
# Nous utilisons le jeu de données 'diamonds' pour prédire la qualité de la coupe ('cut').
diamonds = sns.load_dataset("diamonds")
X = diamonds.drop("cut", axis=1)
y = diamonds["cut"]


# Diviser les données
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)


# 2. Définir le pré-traitement
# Identifier les colonnes numériques et catégorielles
categorical_features = X.select_dtypes(include=['object', 'category']).columns
numerical_features = X.select_dtypes(include=['int64', 'float64']).columns


# Créer le transformateur de colonnes
preprocessor = ColumnTransformer(
    transformers=[
        ('num', StandardScaler(), numerical_features),
        ('cat', OneHotEncoder(handle_unknown='ignore'), categorical_features)
    ])


# 3. Créer le Pipeline avec le modèle
# On utilise des paramètres par défaut pour l'instant
gb_pipeline = Pipeline(steps=[('preprocessor', preprocessor),
                              ('classifier', GradientBoostingClassifier(random_state=42))])


# 4. Entraîner le modèle
gb_pipeline.fit(X_train, y_train)


# 5. Évaluer le modèle
y_pred = gb_pipeline.predict(X_test)
print("Rapport de classification (paramètres par défaut) :")
print(classification_report(y_test, y_pred))


# Vous pouvez maintenant utiliser GridSearchCV pour optimiser ce pipeline !
param_grid = {
    'classifier__n_estimators': [100, 200],
    'classifier__learning_rate': [0.1, 0.05],
    'classifier__max_depth': [3, 5]
}


# n_jobs=-1 utilise tous les coeurs de votre CPU
grid_search = GridSearchCV(gb_pipeline, param_grid, cv=3, n_jobs=-1, verbose=2)
grid_search.fit(X_train, y_train)

print(f"\nMeilleurs hyperparamètres : {grid_search.best_params_}")
print(f"Meilleur score CV : {grid_search.best_score_:.4f}")


# Évaluation finale avec le meilleur modèle
best_model = grid_search.best_estimator_
y_pred_best = best_model.predict(X_test)
print("\nRapport de classification (après optimisation) :")
print(classification_report(y_test, y_pred_best))
Ce code suit les meilleures pratiques que nous avons apprises : il sépare les données, met en place un pipeline de pré-traitement robuste et utilise GridSearchCV pour trouver les meilleurs hyperparamètres pour notre GradientBoostingClassifier. Notez l'amélioration potentielle de la performance après optimisation.
Conclusion
Félicitations ! Vous avez ajouté l'un des algorithmes les plus puissants du machine learning classique à votre arsenal. Le Gradient Boosting est un incontournable pour les compétitions de science des données et les problèmes industriels sur données tabulaires.
Points clés à retenir :
- Le Gradient Boosting est un modèle d'ensemble qui construit des arbres séquentiellement.
- Le principe fondamental est que chaque nouvel arbre est entraîné pour corriger les erreurs (résidus) de l'ensemble des arbres précédents.
- Ce processus est une forme de descente de gradient dans l'espace des fonctions, ce qui lui donne son nom.
- Les hyperparamètres cruciaux sont
n_estimators,learning_rate, etmax_depth, qui doivent être réglés avec soin, par exemple avecGridSearchCV. - Scikit-learn fournit des implémentations faciles à utiliser comme
GradientBoostingClassifieretGradientBoostingRegressor.
Bien que l'implémentation de Scikit-learn soit excellente, il existe des bibliothèques encore plus rapides et optimisées comme XGBoost, LightGBM et CatBoost, qui sont les standards de l'industrie. Le principe de base reste exactement le même.
Dans la prochaine leçon, nous allons changer radicalement de perspective. Nous quitterons le monde de l'apprentissage supervisé pour explorer l'apprentissage non supervisé, où les données n'ont pas d'étiquettes. Nous commencerons par le clustering avec l'algorithme K-Means.