Bonjour ! Dans la leçon précédente, nous avons exploré le Gradient Boosting, un puissant algorithme d'apprentissage supervisé. Nous avons vu comment il construit des modèles de manière séquentielle, chaque nouvel arbre corrigeant les erreurs du précédent. Cette approche conclut notre exploration approfondie des techniques où les données sont étiquetées (y).
Aujourd'hui, nous changeons de paradigme pour entrer dans le monde de l'apprentissage non supervisé (unsupervised learning). Que faire lorsque nos données n'ont pas d'étiquettes ? Comment y trouver une structure ou des motifs cachés ? C'est la question fondamentale à laquelle l'apprentissage non supervisé tente de répondre.
Notre objectif pour cette leçon est d'expliquer en détail le fonctionnement de l'un des algorithmes les plus fondamentaux et les plus utilisés dans ce domaine : le K-Means. Nous allons décortiquer son mécanisme itératif qui permet de regrouper des données en "clusters" ou "grappes" de manière automatique. C'est votre première étape dans la découverte de structures cachées au sein des données.
1. De l'apprentissage supervisé à l'apprentissage non supervisé
Jusqu'à présent, tous les algorithmes que nous avons étudiés (régression linéaire, forêts aléatoires, gradient boosting) étaient des algorithmes d'apprentissage supervisé. Ils apprenaient à partir de données où chaque exemple (X) était accompagné d'une étiquette ou d'une valeur cible (y). Le but était d'apprendre une fonction capable de prédire y pour de nouvelles données X.
En apprentissage non supervisé, la situation est différente : nous n'avons que les données X, sans aucune étiquette y. L'objectif n'est pas de prédire une valeur, mais de découvrir une structure intrinsèque aux données. L'une des tâches les plus courantes est le clustering, qui consiste à regrouper les données en sous-ensembles homogènes appelés clusters.
Clustering | ML-005 Lecture 13 | Stanford University | Andrew Ng
La vidéo suivante d'Andrew Ng offre une excellente introduction à l'apprentissage non supervisé et au clustering.
Regardez le début de la vidéo pour bien comprendre la différence entre l'apprentissage supervisé et non supervisé. Andrew Ng présente visuellement le concept de données non étiquetées et introduit le clustering comme une méthode pour y trouver une structure. Il cite également plusieurs applications concrètes, comme la segmentation de marché ou l'analyse de réseaux sociaux.
2. L'algorithme K-Means : une approche intuitive
K-Means est un algorithme qui cherche à partitionner un jeu de données en K clusters distincts, où K est un nombre que nous devons spécifier à l'avance. L'idée est que les points d'un même cluster doivent être aussi similaires que possible, tandis que les points de clusters différents doivent être aussi dissemblables que possible.
L'algorithme fonctionne de manière itérative en quatre étapes simples, comme le montrent les schémas ci-dessous.

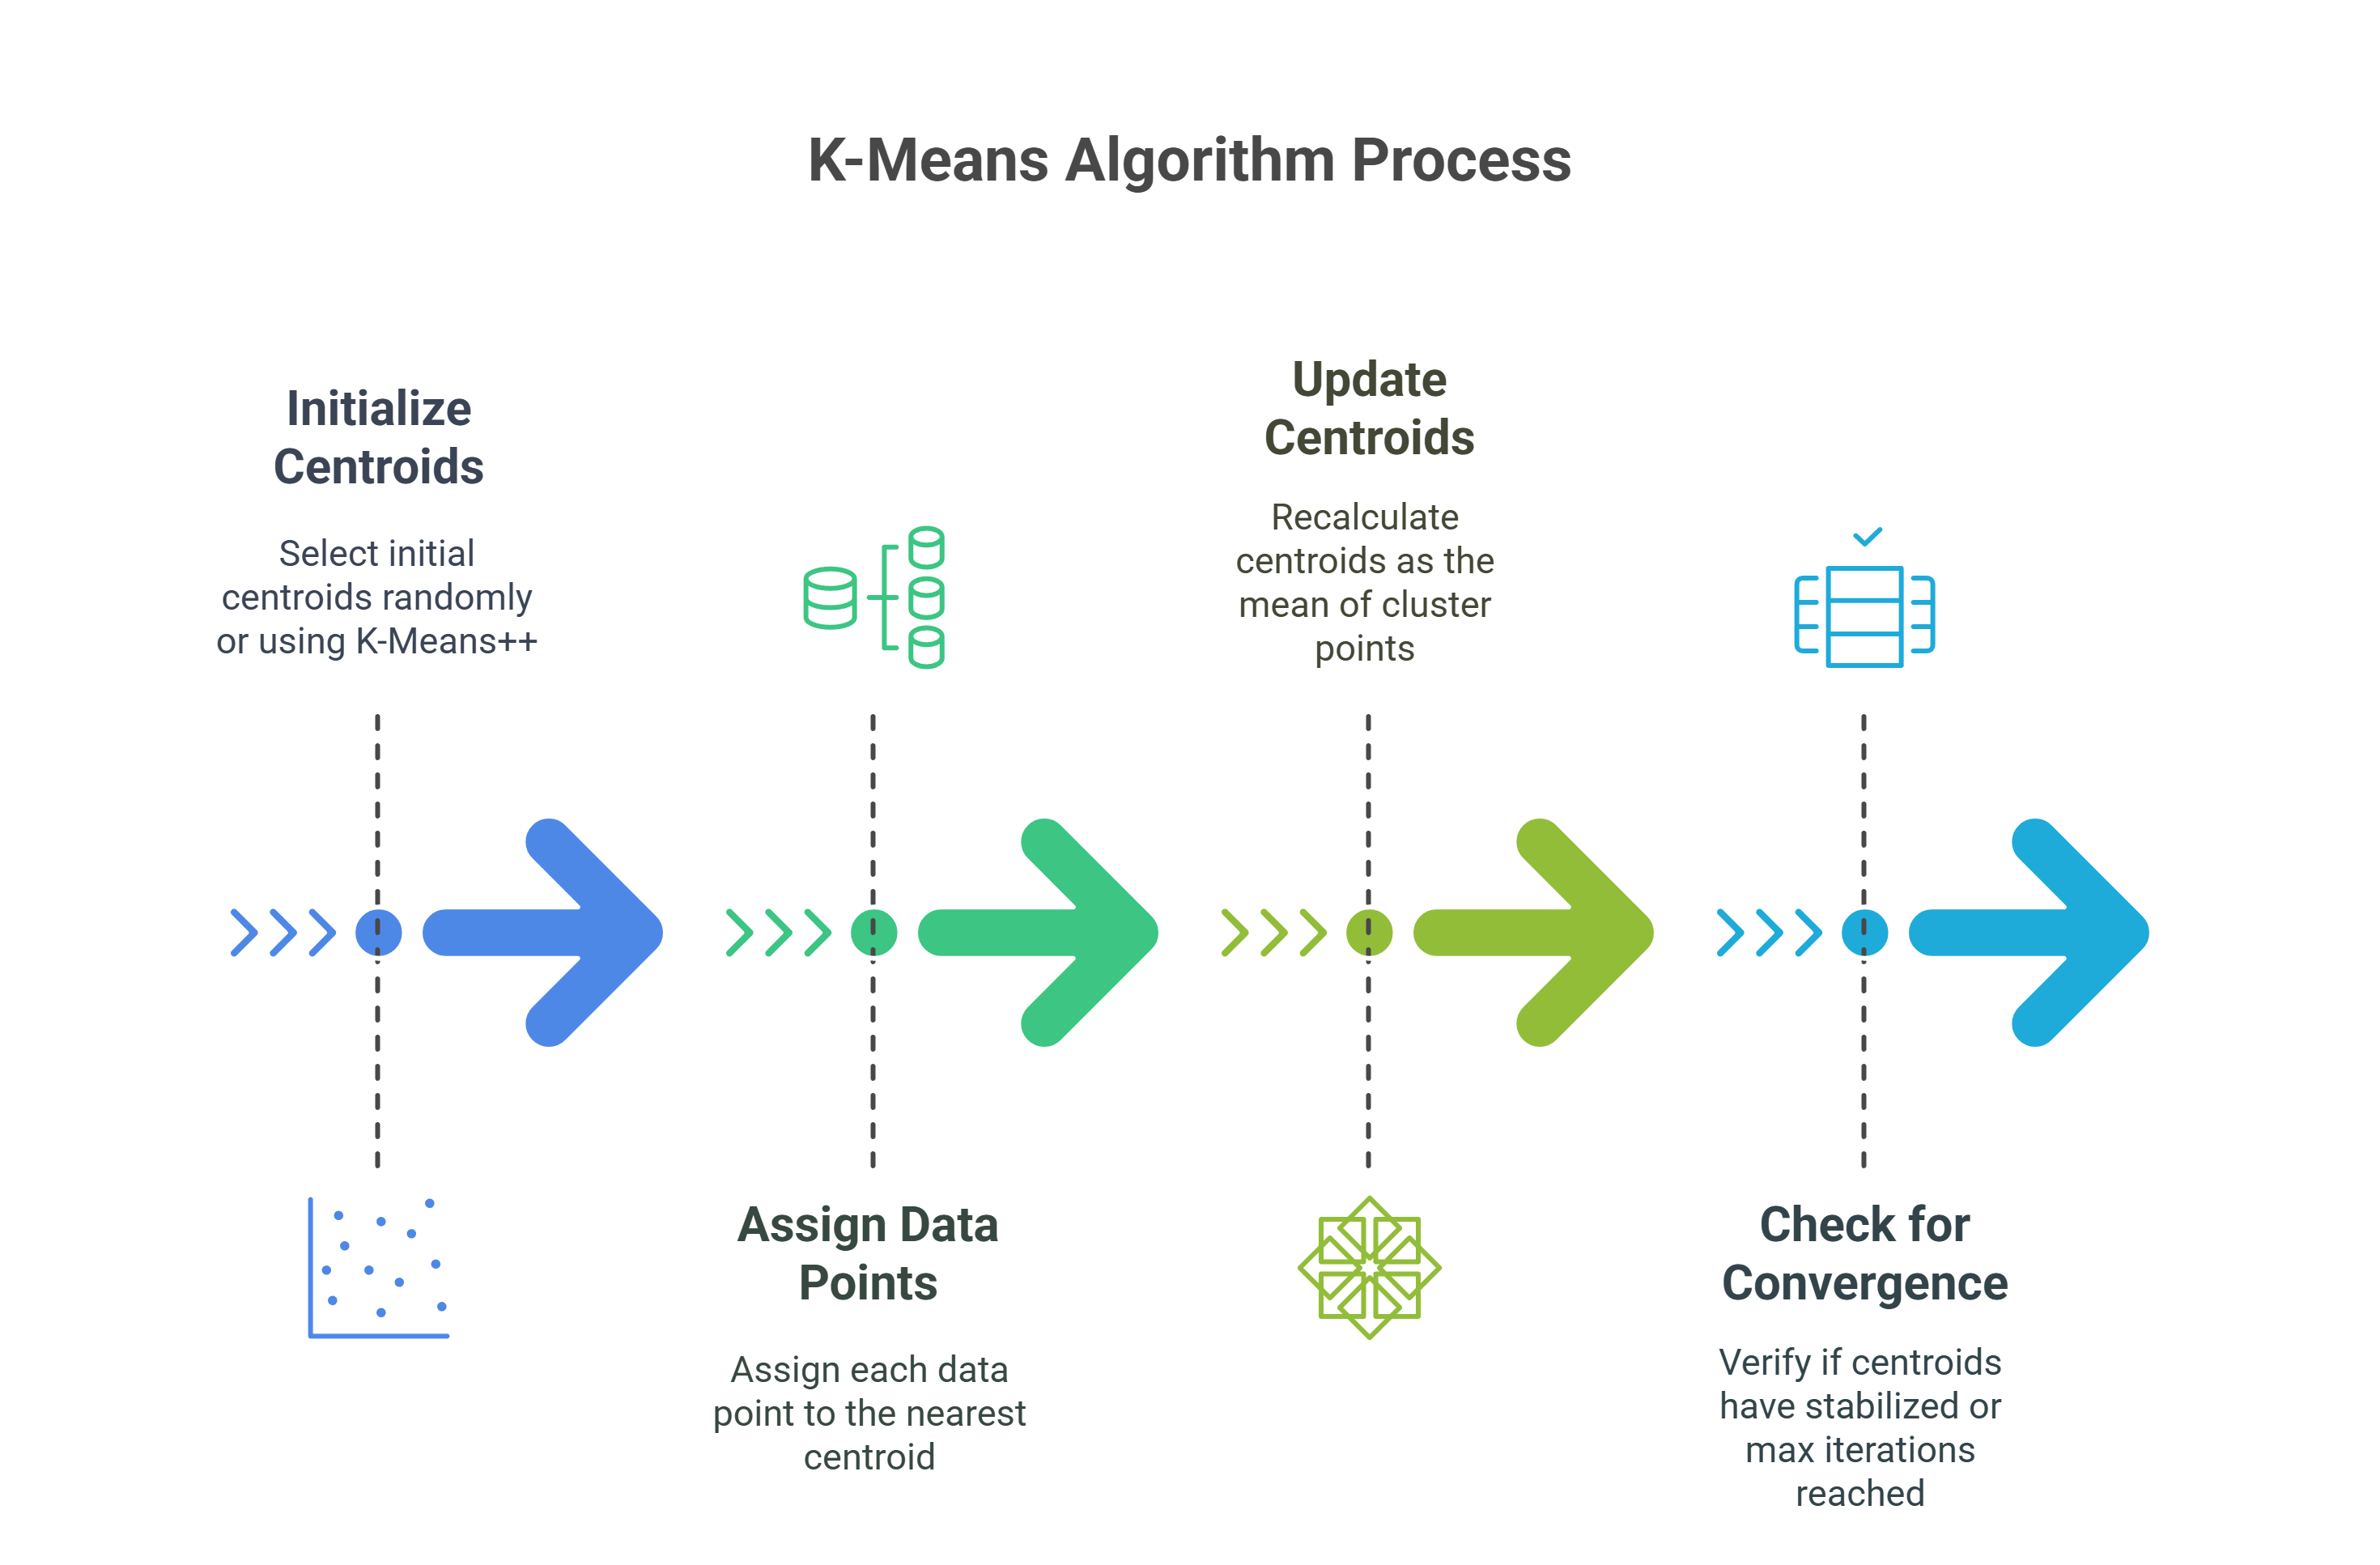
Voyons ces étapes plus en détail :
-
Initialisation : On choisit K points de données au hasard (ou via une méthode plus intelligente comme K-Means++) qui serviront de centres initiaux pour nos clusters. Ces centres sont appelés centroïdes (centroids).
-
Étape d'assignation (Cluster Assignment) : Pour chaque point de données, on calcule sa distance à chacun des K centroïdes. On assigne ensuite le point au cluster dont le centroïde est le plus proche.
-
Étape de mise à jour (Centroid Update) : Une fois que tous les points ont été assignés à un cluster, on recalcule la position de chaque centroïde. Le nouveau centroïde d'un cluster devient le point moyen (la moyenne des coordonnées) de tous les points qui appartiennent à ce cluster.
-
Convergence : On répète les étapes 2 et 3 jusqu'à ce que les assignations des points aux clusters ne changent plus, ou que les centroïdes ne se déplacent quasiment plus. À ce moment, l'algorithme a convergé et les clusters sont formés.
La vidéo suivante illustre parfaitement ce processus itératif.
Clustering | ML-005 Lecture 13 | Stanford University | Andrew Ng
Revenons à la vidéo d'Andrew Ng, qui offre une animation très claire de l'algorithme K-Means en action.
Regardez la section qui décompose le processus. Observez comment les centroïdes (les croix rouge et bleue) sont initialisés au hasard, puis comment les points sont colorés en fonction du centroïde le plus proche (étape d'assignation). Ensuite, regardez comment les centroïdes se déplacent vers le centre de leur nuage de points respectif (étape de mise à jour). Ce cycle se répète jusqu'à ce que plus rien ne bouge.
3. Les mathématiques derrière K-Means
Maintenant que l'intuition est claire, explorons la formulation mathématique qui sous-tend l'algorithme. Comme vous avez une formation en mathématiques, vous apprécierez de voir comment cette idée simple se traduit en un problème d'optimisation.
L'objectif : Minimiser l'inertie
K-Means est un algorithme d'optimisation. Son objectif est de trouver la configuration de clusters qui minimise la somme des carrés des distances intra-cluster (en anglais, Within-Cluster Sum of Squares ou WCSS). Cette mesure est également appelée inertie.
L'objectif est de minimiser la fonction de coût suivante, souvent appelée fonction de distorsion :
Décortiquons cette formule :
- est le nombre de clusters.
- est l'ensemble des points appartenant au cluster .
- est le centroïde (le point moyen) du cluster .
- est le carré de la distance euclidienne entre un point et le centroïde de son cluster.
- La somme interne calcule la somme des distances au carré pour tous les points d'un même cluster.
- La somme externe additionne ces valeurs pour tous les clusters.
En bref, l'algorithme cherche à rendre les clusters aussi compacts que possible en minimisant la somme des distances au carré de chaque point à son centre de cluster.
K-means Clustering: Complete Guide with Algorithm ...
Cet article de M. Brenndörfer est une excellente ressource pour approfondir la théorie et la pratique de K-Means.
Commencez par lire la section sur la fonction objectif pour bien comprendre le concept de WCSS (ou inertie) et pourquoi on utilise les distances au carré. Ensuite, lisez la section qui formalise les étapes de l'algorithme que nous venons de voir : Initialisation, Assignation, Mise à jour, et Convergence. Faites le lien entre ces deux étapes itératives et la minimisation de la fonction de coût J. L'étape d'assignation minimise J en optimisant les clusters C_i pour des centroïdes \mu_i fixes, tandis que l'étape de mise à jour minimise J en optimisant les centroïdes \mu_i pour des clusters C_i fixes.
L'importance de la mise à l'échelle (Feature Scaling)
La distance euclidienne est au cœur de K-Means. Rappelez-vous que la distance euclidienne entre deux points et dans un espace à dimensions est :
K-Means utilise le carré de cette distance. Cela signifie que les caractéristiques (features) avec des échelles de valeurs très grandes domineront le calcul de la distance. Par exemple, si une feature est un revenu (en dizaines de milliers de dollars) et une autre est l'âge (en dizaines d'années), le revenu aura un impact beaucoup plus important sur la distance, ce qui peut fausser les résultats du clustering.
Il est donc crucial de mettre les features à la même échelle avant d'appliquer K-Means, par exemple en utilisant la standardisation (StandardScaler) que nous avons déjà étudiée.
Machine Learning Tutorial Python - 13: K Means Clustering Algorithm
La vidéo de "codebasics" illustre de manière très convaincante pourquoi la mise à l'échelle est indispensable.
Regardez la section qui montre un clustering incorrect. L'auteur explique que le problème vient des échelles très différentes entre l'axe des X et l'axe des Y. Puis, dans la section suivante, il applique un MinMaxScaler et montre comment le clustering devient bien meilleur. C'est une démonstration pratique d'un concept théorique essentiel.
4. Défis majeurs de K-Means
Bien que simple et efficace, K-Means présente deux défis majeurs qu'il est important de comprendre.
Défi 1 : Le choix de K
L'algorithme requiert de spécifier le nombre de clusters K à l'avance. Mais comment savoir combien de clusters "naturels" existent dans les données ? C'est souvent une question difficile.
Une méthode heuristique populaire pour guider ce choix est la méthode du coude (Elbow Method). L'idée est de faire tourner l'algorithme K-Means pour différentes valeurs de K (par exemple, de 1 à 10) et de calculer l'inertie (WCSS) pour chaque K. On trace ensuite l'inertie en fonction de K.
En général, l'inertie diminue à mesure que K augmente (au pire, chaque point devient son propre cluster et l'inertie est nulle). Cependant, le gain de réduction de l'inertie diminue. Le "coude" de la courbe, c'est-à-dire le point où la courbe commence à s'aplatir, est souvent considéré comme une bonne indication pour le K optimal.
Machine Learning Tutorial Python - 13: K Means Clustering Algorithm
La vidéo de "codebasics" explique très clairement cette méthode.
Regardez la section qui explique la méthode du coude. L'auteur montre comment on calcule la somme des carrés des erreurs (SSE, qui est notre WCSS/inertie) pour différents K et comment on identifie le "coude" sur le graphique pour choisir le meilleur K.
Défi 2 : La sensibilité à l'initialisation
Le résultat final de K-Means peut dépendre des centroïdes de départ, qui sont souvent choisis au hasard. Une mauvaise initialisation peut mener l'algorithme à converger vers un "optimum local" plutôt que vers la meilleure solution possible (l'"optimum global"). Cela signifie que vous pourriez obtenir des clusters de mauvaise qualité simplement par malchance lors de l'initialisation.
Pour pallier ce problème, deux stratégies sont couramment utilisées :
- Exécutions multiples : On exécute l'algorithme K-Means plusieurs fois (par exemple, 10 fois) avec des initialisations aléatoires différentes. On choisit ensuite le résultat final qui a la plus faible inertie. C'est ce que fait Scikit-learn par défaut avec le paramètre
n_init. - Initialisation intelligente (K-Means++) : Au lieu de choisir les centroïdes initiaux complètement au hasard, l'algorithme K-Means++ les choisit de manière à ce qu'ils soient éloignés les uns des autres. Cela augmente considérablement les chances de converger vers une bonne solution. C'est également la méthode par défaut dans Scikit-learn.
K-means Clustering: Complete Guide with Algorithm ...
Retournons à l'article de M. Brenndörfer pour une explication détaillée de K-Means++.
Lisez la section sur K-Means++. L'auteur explique pourquoi l'initialisation aléatoire peut être problématique et comment K-Means++ choisit les centroïdes de manière plus intelligente, en favorisant des points éloignés des centroïdes déjà choisis. Les visualisations comparatives sont particulièrement utiles pour saisir la différence.
Conclusion
Aujourd'hui, nous avons fait nos premiers pas dans l'apprentissage non supervisé en décortiquant l'algorithme K-Means. C'est une technique fondamentale qui vous servira de base pour de nombreuses tâches d'analyse exploratoire et de segmentation.
Points clés à retenir :
- L'apprentissage non supervisé vise à trouver une structure dans des données non étiquetées. Le clustering est une tâche clé de ce domaine.
- K-Means est un algorithme itératif qui partitionne les données en K clusters en alternant deux étapes : l'assignation des points au centroïde le plus proche et la mise à jour des centroïdes comme moyenne des points du cluster.
- L'objectif mathématique de K-Means est de minimiser l'inertie (WCSS), qui est la somme des carrés des distances de chaque point à son centroïde.
- L'algorithme est sensible à l'échelle des features (la mise à l'échelle est essentielle) et à l'initialisation des centroïdes (on utilise K-Means++ et des exécutions multiples pour y remédier).
- Le choix du nombre de clusters K est un défi, mais la méthode du coude peut aider à prendre une décision éclairée.
Dans la prochaine leçon, nous mettrons tout cela en pratique. Vous apprendrez à appliquer l'algorithme K-Means à un jeu de données réel en utilisant Scikit-learn et à mettre en œuvre la méthode du coude pour trouver le nombre optimal de clusters.