Bonjour ! Dans la leçon précédente, nous avons posé les bases théoriques de l'algorithme K-Means. Nous avons compris son fonctionnement itératif, son objectif de minimiser l'inertie (WCSS), et les défis qu'il présente, notamment le choix du nombre de clusters K et sa sensibilité à l'initialisation.
Aujourd'hui, nous passons de la théorie à la pratique. L'objectif est de vous rendre capable d'appliquer concrètement K-Means à un jeu de données en utilisant la bibliothèque Scikit-learn. Nous verrons comment implémenter l'algorithme, et surtout, comment utiliser la méthode du coude (Elbow Method) pour déterminer un nombre optimal de clusters. Cette leçon est une étape cruciale pour transformer vos connaissances théoriques en compétences pratiques d'analyse de données.
1. Appliquer K-Means avec Scikit-learn
Scikit-learn rend l'utilisation de K-Means très simple grâce à la classe KMeans du module sklearn.cluster. Avant de plonger dans le code, familiarisons-nous avec ses paramètres les plus importants :
n_clusters: C'est le paramètre le plus important, notre fameux K. Il définit le nombre de clusters que l'algorithme doit trouver.init: Spécifie la méthode d'initialisation des centroïdes. La valeur par défaut est'k-means++', la méthode intelligente que nous avons vue pour éviter les mauvaises initialisations. C'est un excellent choix que nous conserverons.n_init: Indique combien de fois l'algorithme sera exécuté avec des centroïdes de départ différents. Scikit-learn choisira automatiquement la meilleure exécution (celle avec la plus faible inertie). La valeur par défaut,'auto', gère cela très bien pour nous.random_state: Comme pour les autres algorithmes, nous utilisons ce paramètre en lui donnant une valeur (par exemple, 42) pour garantir que nos résultats soient reproductibles.
Le processus est simple : on instancie la classe KMeans avec les paramètres désirés, puis on l'entraîne sur nos données avec la méthode .fit_predict(), qui va à la fois entraîner le modèle et retourner les étiquettes de cluster pour chaque point de données.
L'importance cruciale de la mise à l'échelle
Rappelez-vous, K-Means se base sur la distance euclidienne. Des caractéristiques (features) avec des échelles très différentes peuvent fausser complètement les résultats. Avant de coder, voyons une démonstration pratique de ce problème et de sa solution.
Machine Learning Tutorial Python - 13: K Means Clustering Algorithm
La vidéo de "codebasics" illustre parfaitement ce point.
Regardez d'abord la section qui montre un clustering incorrect. Vous verrez comment des échelles différentes sur les axes X et Y conduisent à des clusters qui ne semblent pas logiques. Ensuite, regardez comment l'auteur résout ce problème en appliquant une mise à l'échelle (MinMaxScaler) aux données avant de relancer l'algorithme. Observez à quel point les clusters résultants sont plus cohérents. Cela renforce l'idée qu'il s'agit d'une étape de prétraitement non négociable pour K-Means.
Après la mise à l'échelle, l'auteur applique à nouveau K-Means. Le code ressemble à ceci :
from sklearn.preprocessing import MinMaxScaler
from sklearn.cluster import KMeans


# Supposons que 'df' est notre DataFrame avec les colonnes 'age' et 'income'
# Mise à l'échelle des features
scaler = MinMaxScaler()
df['income_scaled'] = scaler.fit_transform(df[['income']])
df['age_scaled'] = scaler.fit_transform(df[['age']])


# Entraînement de K-Means sur les données mises à l'échelle
km = KMeans(n_clusters=3, random_state=42, n_init='auto')
predicted_clusters = km.fit_predict(df[['age_scaled', 'income_scaled']])


# On peut alors ajouter ces prédictions au DataFrame
df['cluster'] = predicted_clusters
Les résultats après mise à l'échelle sont bien meilleurs, comme le montre la vidéo. Les centroïdes des clusters, qui représentent le "centre" de chaque groupe, sont accessibles via l'attribut km.cluster_centers_.
2. Trouver le K optimal : La Méthode du Coude en pratique
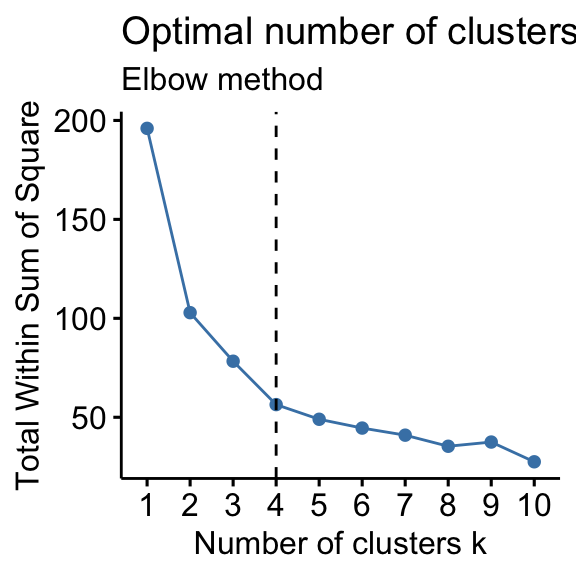
Nous avons vu la théorie de la méthode du coude : trouver le point où l'inertie cesse de diminuer de manière significative. Mettons maintenant cela en œuvre. L'idée est de calculer l'inertie pour un éventail de valeurs de K et de visualiser le résultat.
Finding The Optimal Number of Clusters in Machine Learning
La chaîne NeuralNine propose une explication et une implémentation très claires de cette méthode.
Regardez la section qui montre comment implémenter la méthode du coude. L'auteur crée une boucle pour tester différentes valeurs de K, stocke l'inertie de chaque modèle (kmeans.inertia_), puis trace le graphique. Observez bien comment il interprète le "coude" sur le graphique généré : c'est le point où la courbe s'aplatit, indiquant que l'ajout de plus de clusters n'apporte plus un gain significatif.
Le code pour générer ce graphique est assez simple et suit une logique que vous pouvez réutiliser dans tous vos projets de clustering.
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans


# Supposons que 'scaled_data' contient nos données prétraitées
k_range = range(1, 11)
inertia_list = []

for k in k_range:
    km = KMeans(n_clusters=k, random_state=42, n_init='auto')
    km.fit(scaled_data)
    inertia_list.append(km.inertia_)


# Tracer le graphique
plt.figure(figsize=(8, 6))
plt.plot(k_range, inertia_list, marker='o')
plt.xlabel('Nombre de clusters (K)')
plt.ylabel('Inertie')
plt.title('Méthode du coude pour K optimal')
plt.xticks(k_range)
plt.grid(True)
plt.show()
Ce code vous produira un graphique similaire à l'image ci-dessus, vous permettant de choisir une valeur pertinente pour K.
3. Étude de cas complète : Clustering sur le jeu de données Iris
Mettons maintenant toutes les pièces du puzzle ensemble avec un exemple classique : le jeu de données Iris. Ce jeu de données contient des mesures pour 3 espèces différentes de fleurs d'iris. Nous allons faire comme si nous ne connaissions pas les espèces et voir si K-Means peut les retrouver tout seul.
Vous pouvez suivre ces étapes en vous inspirant des exemples de code dans les articles que nous allons utiliser.
Introduction to k-Means Clustering with scikit-learn in Python
Cet article de DataCamp offre un excellent guide pratique. Nous allons nous en inspirer pour la structure de notre code.
Lisez la section sur la normalisation pour voir comment préparer les données. Puis, parcourez la section sur le choix du nombre de clusters, qui montre comment implémenter une boucle pour tester différentes valeurs de K et tracer le résultat pour trouver le "coude".
Voici le plan d'action, que vous pouvez implémenter dans un notebook Jupyter :
Étape 1 : Charger et préparer les données
Nous chargeons le jeu de données Iris depuis Scikit-learn et le mettons à l'échelle.
from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler


# Charger les données
iris = load_iris()
X = iris.data  # Les features
y = iris.target  # Les vraies étiquettes (on les garde pour comparer à la fin)


# Mettre les données à l'échelle
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Étape 2 : Appliquer la méthode du coude
Nous utilisons le code que nous avons vu précédemment pour trouver le K optimal. Vous devriez voir un coude très net à K=3, ce qui correspond bien aux 3 espèces de fleurs.
Étape 3 : Entraîner le modèle final et visualiser les résultats
Maintenant que nous savons que K=3 est un bon choix, nous entraînons notre modèle final.
# Entraîner le modèle final
km_final = KMeans(n_clusters=3, random_state=42, n_init='auto')
clusters = km_final.fit_predict(X_scaled)


# Visualiser les résultats (en utilisant les 2 premières features pour un graphique 2D)
plt.figure(figsize=(10, 7))
plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=clusters, cmap='viridis', marker='o')


# Afficher les centroïdes
centers = km_final.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75, marker='X')

plt.xlabel('Longueur du sépale (standardisée)')
plt.ylabel('Largeur du sépale (standardisée)')
plt.title('Résultats du Clustering K-Means sur Iris (K=3)')
plt.show()
Étape 4 : Évaluer la qualité du clustering
Comment savoir si nos clusters correspondent à la réalité ? Puisque nous avons les vraies étiquettes (y), nous pouvons comparer visuellement les clusters trouvés par K-Means avec les vraies espèces.
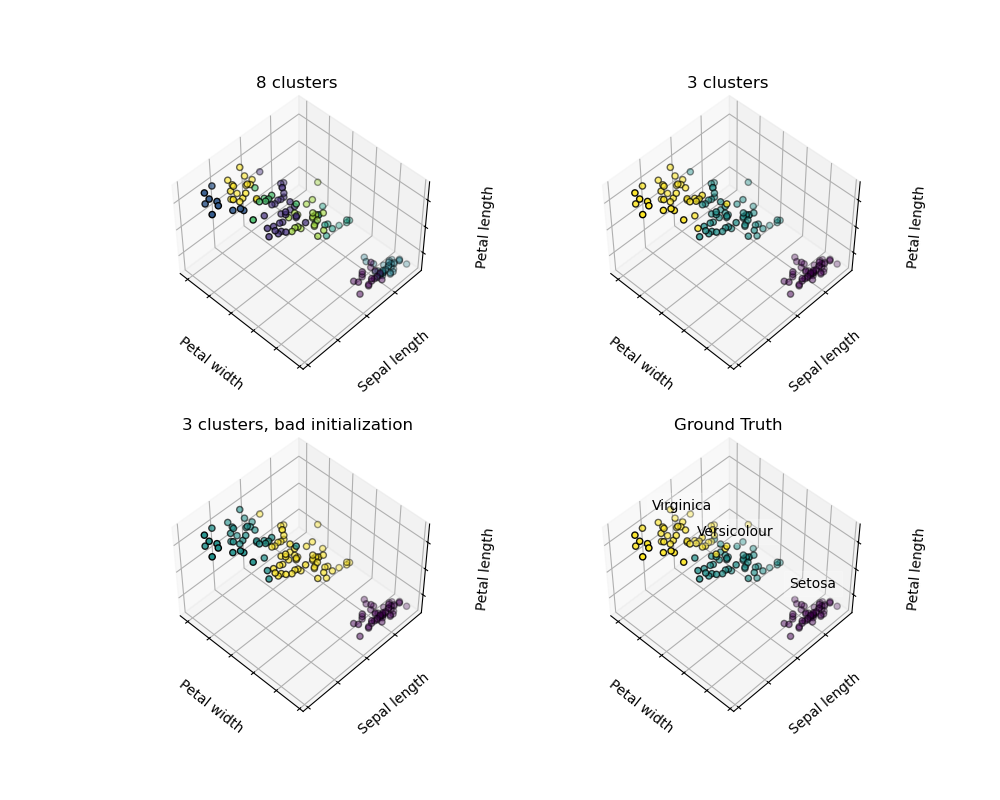
Cette image montre que K-Means a fait un excellent travail ! Il a parfaitement isolé une espèce (le cluster violet, Setosa) et a très bien séparé les deux autres, même s'il y a une petite zone de chevauchement. L'image "3 clusters, bad initialization" nous rappelle également pourquoi la stratégie d'initialisation k-means++ est si importante.
Conclusion
Dans cette leçon, nous avons franchi une étape essentielle en passant de la théorie à la pratique. Vous êtes maintenant capable de mener une analyse par clustering de bout en bout avec K-Means.
Points clés à retenir :
- L'implémentation de K-Means dans Scikit-learn se fait via la classe
sklearn.cluster.KMeans. - La mise à l'échelle des données (par ex. avec
StandardScaler) est une étape de prétraitement obligatoire pour K-Means. - La méthode du coude est une technique pratique et visuelle pour choisir le nombre de clusters K. Elle s'implémente en traçant l'inertie (
model.inertia_) pour différentes valeurs de K. - Le processus complet inclut : le chargement, la mise à l'échelle, la recherche du K optimal, l'entraînement du modèle final, et la visualisation/interprétation des clusters.
Dans la prochaine leçon, nous aborderons une autre technique d'apprentissage non supervisé très puissante : l'Analyse en Composantes Principales (PCA). Nous verrons comment PCA peut nous aider à réduire la dimensionnalité de nos données, ce qui est souvent utile pour la visualisation ou comme étape de prétraitement avant d'appliquer des algorithmes comme K-Means, surtout sur des jeux de données avec de très nombreuses features.