Bonjour ! Dans la leçon précédente, nous avons vu comment adapter des modèles pré-entraînés comme ResNet pour la classification d'images. Ces modèles, les réseaux de neurones convolutifs (CNN), sont parfaits pour des données structurées en grille, comme les pixels d'une image. Aujourd'hui, nous changeons de décor pour aborder un type de données totalement différent : les séquences.
Votre objectif est de comprendre les grands modèles de langage (LLM), qui sont fondamentalement des experts dans le traitement de séquences de texte. Pour y parvenir, nous devons d'abord comprendre les architectures qui ont été conçues pour ce type de données. L'objectif de cette leçon est donc de décrire l'architecture d'un Réseau de Neurones Récurrent (RNN) simple et ses applications aux séquences. Nous verrons pourquoi les modèles que nous avons étudiés jusqu'à présent ne suffisent pas et comment les RNN résolvent ce problème grâce à un concept de "mémoire".
1. Pourquoi avons-nous besoin d'une nouvelle architecture ?
Imaginez que vous vouliez analyser le sentiment d'une critique de film. Vous pourriez être tenté d'utiliser un réseau de neurones classique (feedforward). Cependant, vous rencontreriez rapidement deux problèmes majeurs :
- Entrées de longueur variable : Les critiques de films n'ont pas toutes la même longueur. Un réseau de neurones standard attend une entrée de taille fixe, ce qui le rend inadapté.
- L'ordre des mots est crucial : Les phrases "le film n'était pas bon" et "le film était bon, pas..." utilisent les mêmes mots, mais leur ordre change complètement le sens. Un réseau de neurones standard traite ses entrées indépendamment les unes des autres et perd cette information séquentielle.
Les CNN, bien que puissants pour les images, ne sont pas non plus la solution, car ils sont conçus pour trouver des motifs dans des voisinages spatiaux fixes, pas dans des séquences temporelles ou linguistiques.
Nous avons donc besoin d'un modèle capable de traiter des séquences de n'importe quelle longueur tout en tenant compte de l'ordre des éléments. C'est précisément le rôle des Réseaux de Neurones Récurrents (RNN).
La vidéo suivante de StatQuest explique très clairement pourquoi les séquences nécessitent une approche différente et introduit l'idée maîtresse des RNN.
Recurrent Neural Networks (RNNs), Clearly Explained!!!
Cette vidéo de Josh Starmer est excellente pour construire l'intuition derrière les RNN.
Regardez la première partie, de l'introduction aux données séquentielles jusqu'à l'explication de la différence avec les réseaux de neurones classiques et l'introduction de la boucle de rétroaction (feedback loop).
2. L'architecture d'un RNN : une boucle et une mémoire
L'idée centrale d'un RNN est simple mais puissante : il possède une boucle. Au lieu de simplement faire passer l'information vers l'avant, une partie de la sortie du réseau à un instant t est renvoyée en entrée à l'instant t+1. Cette information réinjectée est appelée état caché (hidden state) et sert de "mémoire" au réseau, lui permettant de conserver une trace de ce qu'il a vu précédemment dans la séquence.
Visuellement, on représente souvent un RNN de deux manières : une forme "pliée" compacte avec une boucle, et une forme "dépliée" qui montre comment le réseau traite la séquence pas à pas.
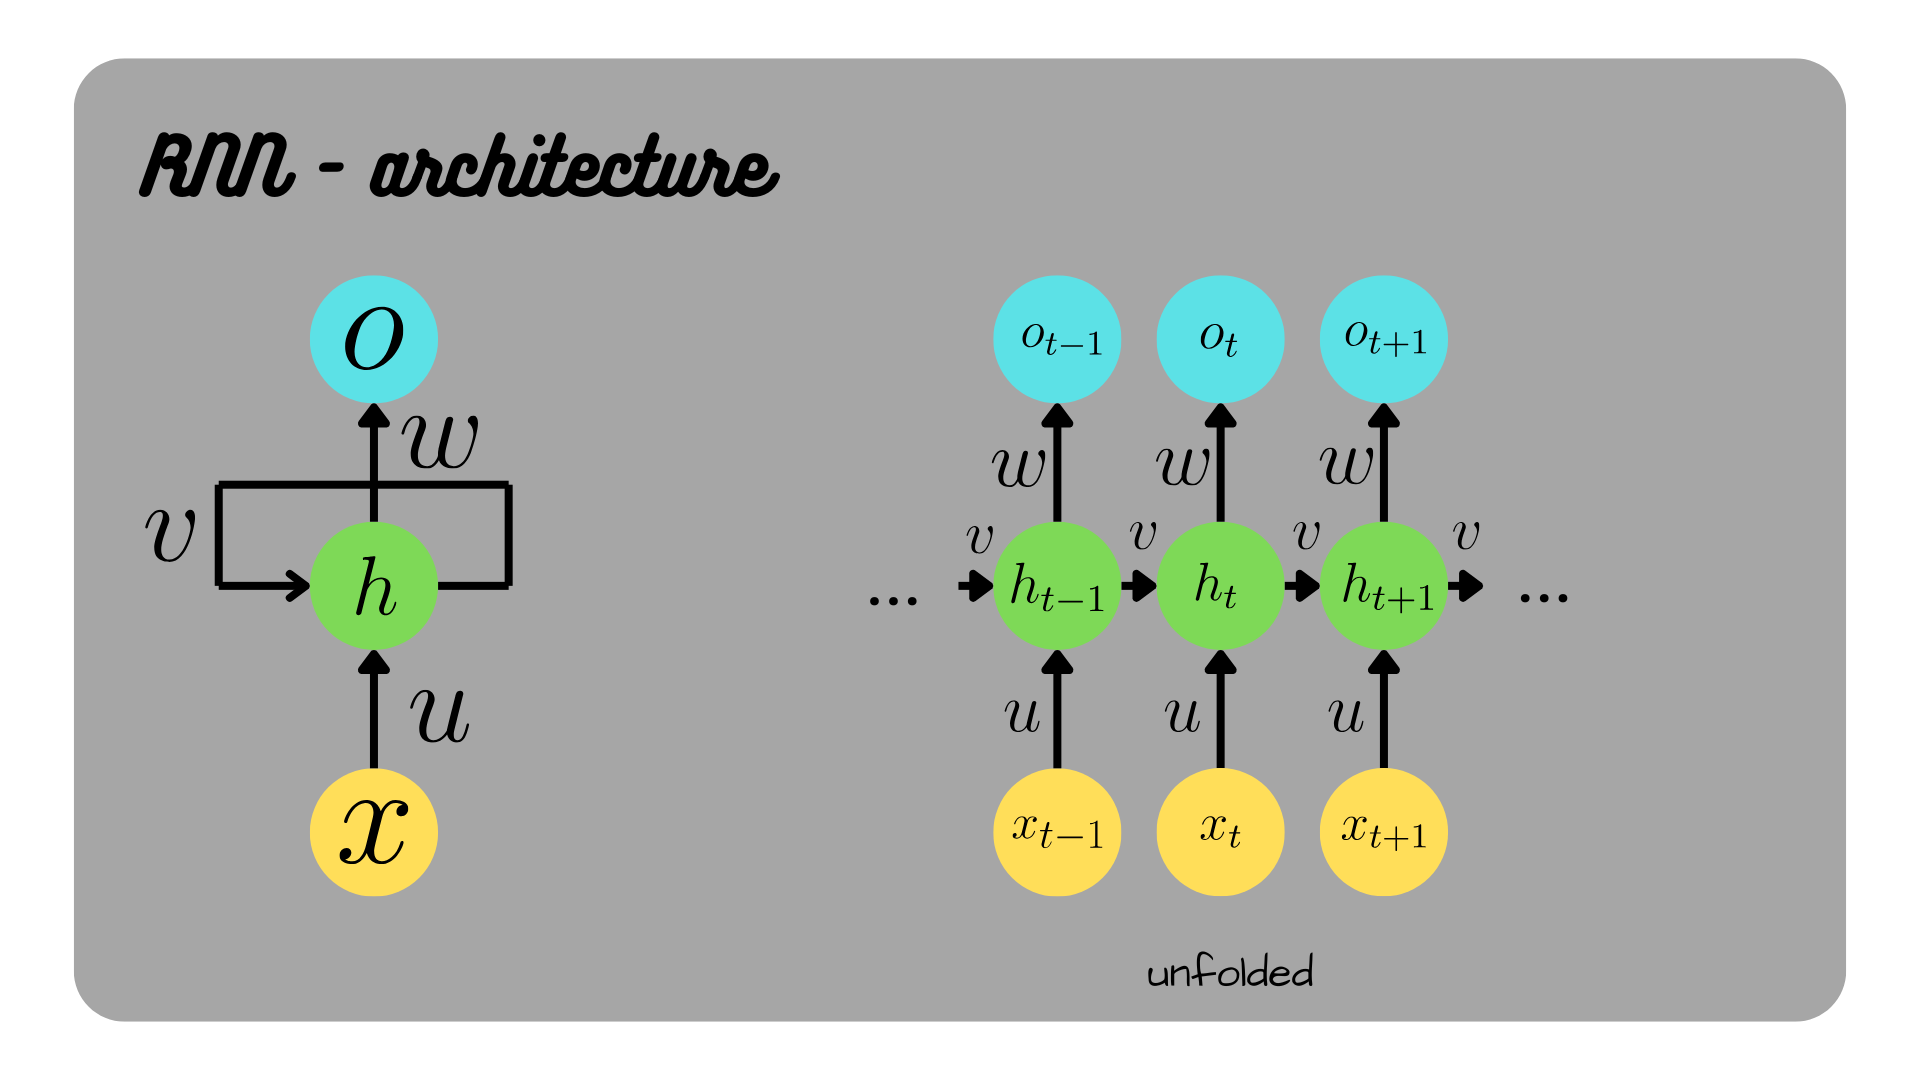
Il est crucial de comprendre que la version dépliée ne représente pas plusieurs réseaux de neurones différents. C'est le même réseau, avec les mêmes poids (, , ), qui est réutilisé à chaque étape de la séquence.
Le tutoriel vidéo en arabe suivant explique ce concept de dépliage de manière très claire.
Recurrent Neural Network (RNN) شرح عربي
Cette vidéo d'Ahmed Ibrahim détaille l'architecture et les équations d'un RNN.
Concentrez-vous sur la section qui explique l'architecture de base, de l'introduction au concept de récurrence jusqu'à la présentation des formes pliée et dépliée. Cela vous aidera à bien visualiser comment l'information circule.
Comment ça marche mathématiquement ?
Le fonctionnement à chaque pas de temps est régi par deux équations simples. En reprenant les notations de l'image ci-dessus, mais en utilisant des conventions plus standard :
-
Calcul du nouvel état caché :
- est le vecteur d'entrée à l'instant (par exemple, un mot).
- est l'état caché de l'étape précédente.
- et sont les matrices de poids (pour l'état caché précédent et l'entrée actuelle, respectivement).
- est le biais.
tanhest une fonction d'activation, souvent utilisée dans les RNN, qui écrase le résultat entre -1 et 1.
-
Calcul de la sortie :
- est le nouvel état caché que nous venons de calculer.
- est la matrice de poids pour la sortie.
- est le biais de sortie.
L'article suivant, "An Introduction to Recurrent Neural Networks for Beginners", présente ces équations de manière très concise.
An Introduction to Recurrent Neural Networks for Beginners
Cet article de Victor Zhou est une excellente ressource pour comprendre les mécanismes fondamentaux des RNN.
Concentrez-vous sur la section 2, "The How". Lisez attentivement la partie qui commence par "Here's what makes an RNN recurrent" et qui se termine juste avant les équations. Ensuite, étudiez attentivement les deux équations qui définissent le fonctionnement du RNN. Notez bien que les poids W_{xh}, W_{hh}, et W_{hy} sont partagés à travers tous les pas de temps.
3. Les applications des RNN
La flexibilité des RNN leur permet de s'adapter à une variété de tâches en fonction de la structure des entrées et des sorties. On peut les classer en plusieurs catégories :

Voici quelques exemples concrets :
- Plusieurs-vers-un (Many-to-One) : Une séquence d'entrées produit une seule sortie. C'est le cas de la classification de sentiment, où une critique (séquence de mots) est classée comme "positive" ou "négative" (une seule sortie).
- Un-vers-plusieurs (One-to-Many) : Une seule entrée produit une séquence de sorties. L'exemple classique est le légendage d'images (image captioning), où une image (entrée unique) génère une description textuelle (séquence de mots).
- Plusieurs-vers-plusieurs (Many-to-Many) :
- Synchronisé : Une séquence d'entrées produit une séquence de sorties de même longueur, où chaque sortie correspond à une entrée. C'est utilisé pour la classification de chaque image d'une vidéo.
- Désynchronisé : Une séquence d'entrées produit une séquence de sorties qui peut avoir une longueur différente. C'est le cœur de la traduction automatique, où une phrase dans une langue est traduite en une phrase dans une autre langue.
L'article suivant, "Deep Learning Illustrated", donne de bons exemples pour chaque catégorie.
Deep Learning Illustrated, Part 4: Recurrent Neural Networks
Cet article illustre bien les différents types de problèmes que les RNN peuvent résoudre.
Lisez la section "What type of problems does an RNN solve?". Elle décrit les catégories Many-to-One, One-to-Many, et Many-to-Many avec des exemples clairs.
4. Le talon d'Achille des RNN simples (Aperçu)
Les RNN simples sont excellents en théorie, mais ils ont une faiblesse majeure : une mémoire à court terme. Lorsqu'une séquence devient très longue, l'information des premières étapes a tendance à se "diluer" ou à disparaître à mesure qu'elle passe à travers les nombreuses étapes du réseau.
Ce phénomène est dû au problème de l'évanescence du gradient (vanishing gradient problem). Pendant l'entraînement, les gradients (les signaux d'erreur) doivent être propagés à travers toutes les étapes de la séquence. S'ils sont multipliés par de petits nombres à chaque étape, ils peuvent devenir si petits qu'ils n'ont plus d'effet sur les poids des premières étapes. Le réseau devient alors incapable d'apprendre des dépendances à long terme.
La vidéo de StatQuest explique ce problème de manière très intuitive.
Recurrent Neural Networks (RNNs), Clearly Explained!!!
Cette partie de la vidéo illustre pourquoi les RNN simples peinent avec les longues séquences.
Regardez la section qui explique le problème de l'évanescence/explosion du gradient. Le concept est illustré en se concentrant sur le poids de la boucle récurrente. Observez ce qui se passe lorsque ce poids est plus grand que 1 (explosion) et lorsqu'il est plus petit que 1 (évanescence).
Ne vous inquiétez pas si les détails de l'entraînement vous semblent complexes. L'important est de retenir que les RNN simples ont du mal à se souvenir d'informations lointaines, ce qui a motivé le développement d'architectures plus avancées.
Conclusion
Dans cette leçon, nous avons fait un grand pas en avant, passant des données en grille aux données séquentielles. Vous avez découvert une toute nouvelle famille de réseaux de neurones, les RNN, conçus pour gérer l'ordre et le contexte.
Points clés à retenir :
- Les RNN sont spécialisés dans le traitement de données séquentielles (texte, séries temporelles, etc.).
- Leur architecture est basée sur une boucle récurrente qui leur permet de maintenir un état caché, agissant comme une mémoire.
- Un RNN utilise le même ensemble de poids à chaque étape de la séquence, ce qui le rend efficace.
- Il existe différentes configurations (plusieurs-vers-un, un-vers-plusieurs, etc.) pour résoudre divers problèmes, de la classification de sentiment à la traduction automatique.
- Les RNN simples souffrent du problème de l'évanescence du gradient, ce qui limite leur capacité à apprendre des dépendances à long terme.
Ce dernier point est crucial et nous servira de tremplin pour notre prochaine leçon. Nous y explorerons des variantes plus sophistiquées des RNN, comme les LSTM (Long Short-Term Memory) et les GRU (Gated Recurrent Unit), qui ont été spécifiquement conçues pour surmonter ce problème de mémoire à court terme grâce à des mécanismes de "portes" intelligentes. Ce sera une étape fondamentale de plus vers la compréhension des modèles de langage modernes.