Bonjour ! Dans la leçon précédente, nous avons exploré l'architecture des Réseaux de Neurones Récurrents (RNN) et comment ils traitent les données séquentielles grâce à leur "mémoire" sous forme d'état caché. Nous avons terminé en mentionnant que cette mémoire est malheureusement à court terme, un défaut majeur que nous allons disséquer aujourd'hui.
L'objectif de cette leçon est d'expliquer en détail le problème de l'évanescence du gradient (vanishing gradient problem) dans les RNN. Comprendre ce phénomène est une étape cruciale, car il constitue la principale motivation derrière le développement d'architectures plus complexes comme les LSTM et les GRU, qui sont des piliers des modèles de langage modernes que vous souhaitez maîtriser. Nous allons voir pourquoi un simple RNN peine à apprendre des liens entre des mots éloignés dans une phrase et comment cela se manifeste mathématiquement.
1. L'intuition : un signal qui s'affaiblit ou explose
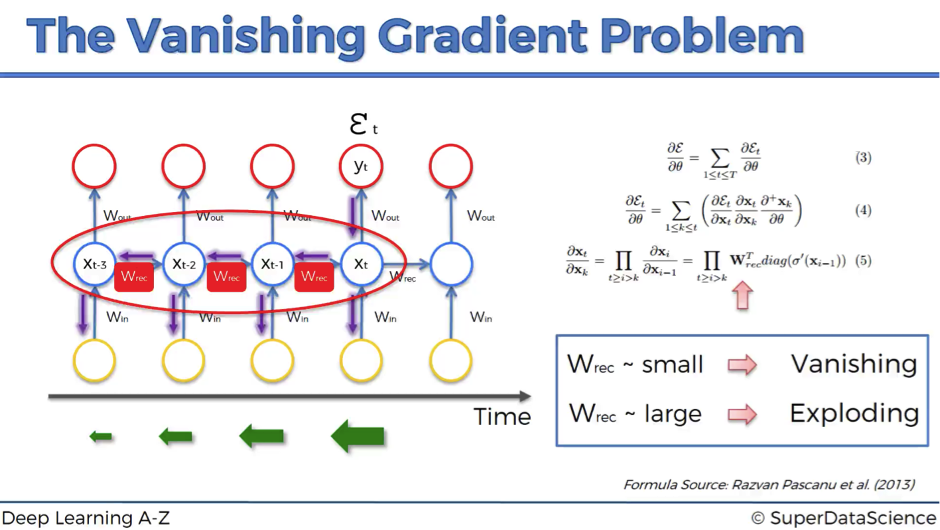
Pour comprendre ce qui se passe, rappelons-nous de la structure "dépliée" d'un RNN. Pendant l'entraînement, pour corriger une erreur à la fin d'une séquence, le signal d'erreur (le gradient) doit être propagé en arrière à travers chaque pas de temps.
La vidéo de StatQuest, que nous avons déjà vue, illustre ce concept de manière très intuitive. Elle se concentre sur l'effet de la multiplication répétée du poids de la boucle récurrente.
Recurrent Neural Networks (RNNs), Clearly Explained!!!
Cette partie de la vidéo de Josh Starmer explique de manière simple et visuelle le cœur du problème.
Concentrez-vous sur le segment qui explique le problème de l'évanescence/explosion du gradient. Observez l'effet lorsque le poids de la boucle est plus grand que 1 (le signal explose) et lorsqu'il est plus petit que 1 (le signal s'évanouit).
L'idée clé est que le gradient, en remontant le temps, est multiplié à chaque étape par une matrice. Un produit de nombreux termes inférieurs à 1 tend vers zéro (évanescence), tandis qu'un produit de nombreux termes supérieurs à 1 tend vers l'infini (explosion). Dans la pratique, l'évanescence est le problème le plus courant et le plus insidieux.
2. La cause mathématique : la règle de dérivation en chaîne
Maintenant, formalisons cette intuition. Votre bagage mathématique vous sera utile ici. L'entraînement d'un RNN se fait par rétropropagation à travers le temps (Backpropagation Through Time, BPTT). Il s'agit simplement de l'algorithme de rétropropagation standard appliqué au réseau déplié.
Le problème réside dans le calcul du gradient de la perte à un instant final par rapport à un état caché à un instant antérieur . En appliquant la règle de dérivation en chaîne, on obtient :
Ce qui peut s'écrire de manière plus compacte :
Chaque terme est une matrice Jacobienne qui dépend de l'équation de l'état caché . Cette matrice est :
Le gradient est donc le résultat d'un long produit de matrices. C'est la source fondamentale du problème.
L'article suivant, "Vanishing Gradients: Why RNNs Fail on Long Sequences", explique cette dérivation mathématique en détail.
Vanishing Gradients in RNNs: Why Neural Networks Forget Long ...
Cet article de Michael Brenndoerfer est une ressource très complète pour comprendre en profondeur les mécanismes du problème.
Commencez par lire l'introduction et la section "The Gradient Product Problem". Portez une attention particulière à la partie qui dérive la formule du gradient comme un produit de matrices. L'article explique très bien pourquoi ce problème est intrinsèque à l'architecture du RNN et non un simple bug d'implémentation.
3. Les deux coupables
Deux éléments principaux contribuent à ce que le produit des matrices Jacobiennes tende vers zéro.
Coupable n°1 : Les fonctions d'activation saturantes
Les fonctions d'activation comme la tangente hyperbolique (tanh) ou la sigmoïde sont dites "saturantes" : leur sortie s'aplatit aux extrêmes, et par conséquent, leur dérivée tend vers zéro.

Chaque Jacobienne dans notre produit contient le terme diag(tanh'(...)). Comme la dérivée de tanh est au mieux égale à 1 (et souvent bien inférieure en pratique), chaque multiplication a tendance à réduire la magnitude du gradient. La fonction sigmoïde est encore pire, avec une dérivée maximale de 0,25.
La vidéo en arabe d'Ahmed Ibrahim explique bien ce point.
Recurrent Neural Network (RNN) شرح عربي
Cette vidéo que vous avez déjà consultée contient une excellente section sur la rétropropagation qui aborde ce problème.
Regardez le segment qui commence vers l'analyse des fonctions d'activation. L'auteur y compare les dérivées de la sigmoïde et de tanh et explique pourquoi elles conduisent au problème de l'évanescence, surtout avec de longues séquences. Il explique comment la multiplication de nombreux petits nombres fait disparaître le gradient.
Coupable n°2 : La matrice de poids récurrente
Même si les dérivées de l'activation étaient toujours de 1, le produit répété de la matrice de poids peut toujours causer des problèmes. Le comportement de la puissance d'une matrice, , est gouverné par ses valeurs propres.
- Si la plus grande valeur propre (en magnitude, aussi appelée rayon spectral) est inférieure à 1, le produit convergera exponentiellement vers la matrice nulle. C'est le cas de l'évanescence.
- Si elle est supérieure à 1, le produit divergera. C'est le cas de l'explosion.
En pratique, entre les poids initialisés pour être stables (rayon spectral ) et l'effet réducteur des fonctions d'activation, le régime d'évanescence est quasi inévitable dans les RNN simples.
4. Les conséquences pratiques : l'incapacité d'apprendre des dépendances à long terme
La conséquence directe de l'évanescence du gradient est que le réseau devient incapable d'apprendre des relations entre des éléments éloignés dans une séquence.
Imaginez la phrase : "Les chats, que j'ai vus dans la rue hier soir, sont fatigués".
Pour que le modèle apprenne que le verbe "sont" doit s'accorder avec "chats" et non "rue", le gradient de l'erreur sur le mot "sont" doit remonter jusqu'au mot "chats". Si le gradient devient quasi nul en chemin, la mise à jour des poids qui renforcerait ce lien sera également quasi nulle. Le réseau n'apprendra jamais cette dépendance.
On parle de "mémoire d'horizon" ou de "distance de gradient effective" pour décrire la fenêtre temporelle limitée dans laquelle un RNN peut réellement apprendre. Au-delà de cet horizon, les informations du passé sont inaccessibles au processus d'apprentissage.
Vanishing Gradients in RNNs: Why Neural Networks Forget Long ...
Cet article formalise cette notion et donne des exemples concrets.
Lisez la section "Effective Gradient Distance" qui définit ce concept. Ensuite, parcourez la section "Empirical Evidence of Vanishing in Practice" qui liste des expériences classiques (comme la tâche de copie) qui démontrent l'échec des RNN sur des dépendances à long terme.
5. Et le problème de l'explosion du gradient ?
Bien que moins fréquent, le problème de l'explosion du gradient (exploding gradient) existe aussi. Il se produit lorsque les multiplications répétées font croître le gradient de manière exponentielle.
Heureusement, ce problème est plus facile à gérer :
- Il est facile à détecter : les valeurs des gradients deviennent gigantesques (voire
NaN, "Not a Number"), et la perte du modèle explose, faisant planter l'entraînement. - Il a une solution simple : une technique appelée troncature de gradient (gradient clipping). Si la norme du gradient dépasse un certain seuil, on la réduit simplement à ce seuil. Cela empêche les mises à jour de poids d'être trop drastiques.
Le problème de l'évanescence est plus dangereux car il est silencieux. L'entraînement peut sembler se dérouler normalement, mais le modèle n'apprend tout simplement pas les dépendances à long terme.
Conclusion
Aujourd'hui, nous avons plongé au cœur de la faiblesse fondamentale des RNN simples. Cette exploration était technique mais essentielle pour justifier la suite de notre parcours vers les LLM.
Points clés à retenir :
- Le problème de l'évanescence du gradient est la principale limitation des RNN simples.
- Il est causé par la rétropropagation à travers le temps (BPTT), qui implique un long produit de matrices Jacobiennes.
- Deux facteurs principaux contribuent à ce problème : les fonctions d'activation saturantes (comme
tanhet sigmoïde) dont la dérivée est , et la matrice de poids récurrente dont les valeurs propres peuvent réduire le signal. - La conséquence est que le RNN a une mémoire à court terme et ne peut pas apprendre les dépendances à long terme dans les séquences.
- Le problème de l'explosion du gradient est le phénomène inverse, mais il est plus facile à détecter et à corriger grâce à la troncature de gradient.
Ce problème structurel des RNN a conduit les chercheurs à concevoir de nouvelles architectures. Dans notre prochaine leçon, nous découvrirons les LSTM (Long Short-Term Memory) et les GRU (Gated Recurrent Units), des types de RNN plus sophistiqués qui introduisent des mécanismes de "portes" pour contrôler explicitement le flux d'informations et de gradients, résolvant ainsi le problème de l'évanescence.