Bonjour ! Dans notre dernière leçon, nous avons disséqué le problème de l'évanescence du gradient, la faiblesse fondamentale des RNN simples qui les empêche d'apprendre des dépendances à long terme. Nous avons vu que la multiplication répétée de matrices lors de la rétropropagation à travers le temps fait "disparaître" le signal d'erreur, rendant l'entraînement inefficace pour les longues séquences.
Aujourd'hui, nous allons découvrir la solution élégante à ce problème. L'objectif de cette leçon est de décrire comment les architectures LSTM (Long Short-Term Memory) et GRU (Gated Recurrent Unit) résolvent le problème de l'évanescence du gradient grâce à des mécanismes de portes (gating mechanisms). Vous verrez comment une conception plus intelligente permet au réseau de contrôler activement ce qu'il mémorise, oublie et utilise pour ses prédictions, créant ainsi une véritable mémoire à long terme. C'est la dernière étape de notre exploration des architectures fondamentales avant d'avoir toutes les bases pour aborder les modèles de langage modernes.
1. L'idée fondamentale du LSTM : une autoroute pour la mémoire
La solution proposée par les inventeurs du LSTM, Sepp Hochreiter et Jürgen Schmidhuber, est à la fois simple et brillante. Au lieu d'essayer de faire passer toute l'information par le même chemin récurrent (l'état caché ), qui subit des transformations complexes à chaque étape, ils ont introduit une voie parallèle.
Cette voie est appelée l'état de la cellule (cell state), souvent noté . Pensez-y comme à une sorte de "tapis roulant" ou d'autoroute de l'information qui traverse toute la chaîne de la séquence.
Le blog de Christopher Olah est une référence absolue pour comprendre les LSTM. Il utilise des diagrammes exceptionnels pour expliquer le concept.
Lisez la section d'introduction qui rappelle le problème des dépendances à long terme. Ensuite, concentrez-vous sur la section "The Core Idea Behind LSTMs" pour comprendre le rôle de l'état de la cellule (cell state).
Ce qui est crucial, c'est que l'information peut circuler le long de cet état de cellule avec très peu de modifications. Elle n'est pas systématiquement multipliée par une matrice de poids à chaque pas de temps. C'est cette conception qui va permettre au gradient de se propager en retour sur de longues distances sans s'évanouir.
La vidéo de StatQuest introduit cette idée en parlant de deux chemins séparés : un pour la mémoire à long terme (le cell state) et un pour la mémoire à court terme (l'état caché).
Long Short-Term Memory (LSTM), Clearly Explained
Josh Starmer, de StatQuest, explique ici l'idée centrale qui distingue les LSTM des RNN simples.
Regardez l'introduction qui explique comment les LSTM utilisent deux chemins distincts pour la mémoire à long et à court terme. C'est une excellente façon de conceptualiser la solution avant de plonger dans les détails.
2. Le contrôle du flux : les mécanismes de portes (Gates)
Bien sûr, ce tapis roulant ne serait pas très utile s'il ne faisait que transporter de l'information sans jamais la modifier. Le génie du LSTM réside dans sa capacité à ajouter ou à retirer de l'information de l'état de la cellule de manière sélective. Ce contrôle est réalisé par des structures appelées portes (gates).
Une porte est essentiellement un petit réseau de neurones qui régule le passage de l'information. Techniquement, il s'agit d'une couche avec une fonction d'activation sigmoïde, suivie d'une opération de multiplication point par point.
- La fonction sigmoïde produit une sortie entre 0 et 1.
- Ce vecteur de valeurs (entre 0 et 1) est ensuite multiplié avec le vecteur d'information que l'on veut réguler.
- Une valeur de
0à une porte signifie "ne rien laisser passer", tandis qu'une valeur de1signifie "tout laisser passer".
Un LSTM standard utilise trois portes pour contrôler et protéger l'état de la cellule.

Pour bien comprendre leur fonctionnement, nous allons les examiner une par une. L'article "Illustrated Guide to LSTM's and GRU's" et la vidéo associée sont d'excellents supports pour visualiser ces étapes.
Illustrated Guide to LSTM's and GRU's: A step by step explanation
Cette vidéo de "The AI Hacker" propose une explication très claire et visuelle des opérations au sein d'une cellule LSTM.
Regardez le segment détaillé qui décompose la cellule LSTM, en commençant par l'introduction au concept de portes et au rôle de la sigmoïde. Puis suivez l'explication pas à pas de chaque porte : La porte de l'oubli (forget gate) La porte d'entrée (input gate) La porte de sortie (output gate)
Étape 1 : La porte de l'oubli (Forget Gate)
La première étape consiste à décider quelle information de l'état de la cellule précédent () doit être jetée.
- Fonction : Oublier l'information non pertinente.
- Mécanisme : La porte de l'oubli prend en entrée l'état caché précédent () et la nouvelle entrée (), et produit un vecteur avec des valeurs entre 0 et 1. Ce vecteur est ensuite multiplié avec l'état de la cellule précédent .
- Exemple : Si le réseau traite une phrase et rencontre un nouveau sujet, il peut apprendre à "oublier" le genre et le nombre de l'ancien sujet.
Étape 2 : La porte d'entrée (Input Gate)
La deuxième étape consiste à décider quelle nouvelle information doit être stockée dans l'état de la cellule. Cela se fait en deux temps :
- Quoi mettre à jour ? La "porte d'entrée" (), une couche sigmoïde, décide quelles valeurs nous allons mettre à jour.
- Quelle information ajouter ? Une couche
tanhcrée un vecteur de nouvelles valeurs candidates () qui pourraient être ajoutées à l'état.
- Fonction : Stocker de nouvelles informations pertinentes.
- Mécanisme : On combine les deux pour mettre à jour l'état de la cellule. La nouvelle information () est "filtrée" par la porte d'entrée () avant d'être ajoutée à l'état de la cellule.
- Exemple : Après avoir oublié l'ancien sujet, le réseau ajoute les informations (genre, nombre) du nouveau sujet à l'état de la cellule.
La mise à jour de l'état de la cellule est donc :
Où représente la multiplication point par point (Hadamard product).
Étape 3 : La porte de sortie (Output Gate)
Enfin, le réseau doit décider quoi produire en sortie. La sortie sera une version filtrée de l'état de la cellule.
- Fonction : Décider quelle partie de la mémoire à long terme (cell state) est pertinente pour la sortie actuelle et la mémoire à court terme (hidden state).
- Mécanisme : Une couche sigmoïde () décide quelles parties de l'état de la cellule vont être incluses dans la sortie. L'état de la cellule est passé à travers une fonction
tanh, puis multiplié par la sortie de la porte de sortie . Le résultat est le nouvel état caché . - Exemple : Si le réseau vient de voir un sujet, il pourrait décider de sortir une information indiquant que le sujet est pluriel, car cette information est pertinente pour conjuguer le verbe qui pourrait suivre.
3. La solution au problème de l'évanescence du gradient
Revenons à l'équation de mise à jour de l'état de la cellule : .
C'est ici que réside la solution. Contrairement à un RNN simple où était le résultat d'une transformation non-linéaire incluant une multiplication de matrice (), la relation entre et est principalement additive.
Lors de la rétropropagation, le gradient peut maintenant circuler de à en passant simplement par la multiplication avec la porte de l'oubli . Le réseau peut apprendre à maintenir proche de 1 pour l'information qu'il doit conserver sur le long terme. Cela crée un chemin presque direct pour le gradient, une sorte d'"autoroute du gradient", qui n'est pas affectée par les multiplications répétées de matrices de poids qui causaient l'évanescence.
En d'autres termes, le LSTM peut apprendre à ouvrir et fermer ses portes pour préserver le gradient et ainsi apprendre des dépendances sur des centaines de pas de temps.
Illustrated Guide to LSTM's and GRU's: A step by ...
Cet article résume très bien l'idée maîtresse.
Lisez la section "Core Concept". Elle explique comment l'état de la cellule agit comme une autoroute qui transfère l'information, et comment les portes ajoutent ou retirent de l'information. C'est le mécanisme qui protège le gradient.
4. Une alternative plus simple : la GRU (Gated Recurrent Unit)
L'architecture LSTM, bien que très puissante, est assez complexe. En 2014, des chercheurs ont proposé une version simplifiée appelée Gated Recurrent Unit (GRU). La GRU atteint des performances comparables sur de nombreuses tâches avec une structure plus légère.
Les principales simplifications de la GRU sont :
- Fusion de l'état de la cellule et de l'état caché : Il n'y a plus de , seul l'état caché transporte l'information.
- Deux portes au lieu de trois :
- Porte de mise à jour (Update Gate) : Similaire à un mélange de la porte de l'oubli et de la porte d'entrée du LSTM. Elle décide quelle information du passé conserver et quelle nouvelle information ajouter.
- Porte de réinitialisation (Reset Gate) : Détermine à quel point il faut ignorer l'information passée lors de la création de la nouvelle information candidate.
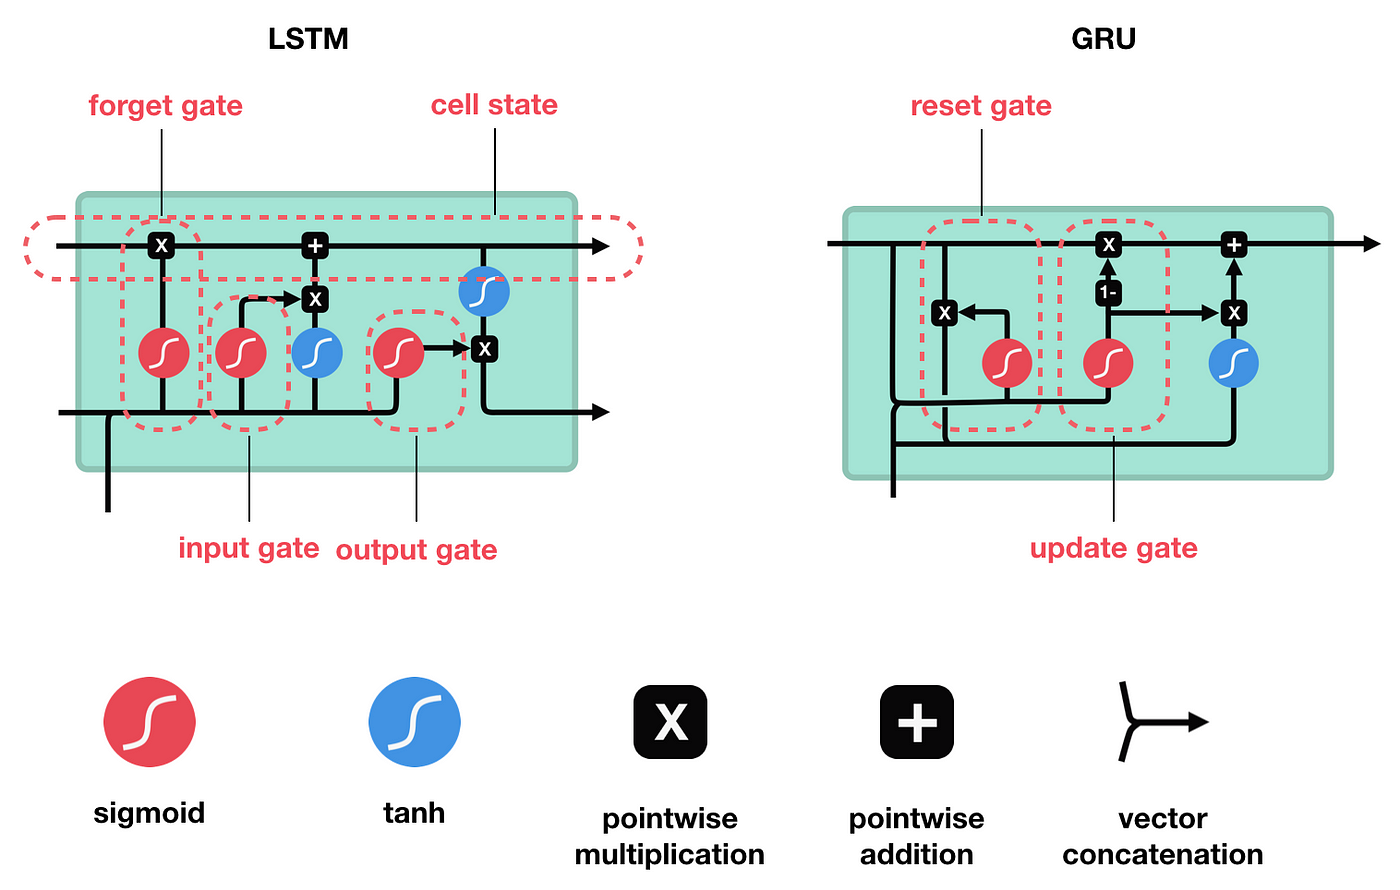
L'article de Colah se termine par une présentation des variantes du LSTM, dont la GRU.
Lisez la dernière partie de la section "Variants on Long Short Term Memory", qui introduit la Gated Recurrent Unit (GRU). L'article explique brièvement ses principales différences avec le LSTM.
La GRU résout le problème de l'évanescence du gradient d'une manière similaire au LSTM, en utilisant des portes pour contrôler le flux d'informations et de gradients. Comme elle est moins complexe, elle est souvent plus rapide à entraîner et peut être un excellent point de départ pour de nombreuses applications. Le choix entre LSTM et GRU dépend souvent du problème spécifique, et il est courant d'essayer les deux pour voir laquelle fonctionne le mieux.
Conclusion
Félicitations, vous êtes arrivé au terme de ce module sur les architectures de deep learning ! Cette leçon était la clé de voûte, reliant le problème identifié dans la leçon précédente à sa solution.
Points clés à retenir :
- Les LSTM résolvent le problème de l'évanescence du gradient en introduisant un état de cellule (cell state), une "autoroute" qui permet à l'information et aux gradients de circuler sur de longues distances.
- Le flux d'information dans un LSTM est contrôlé par trois portes : la porte de l'oubli (décide quoi jeter), la porte d'entrée (décide quoi ajouter) et la porte de sortie (décide quoi utiliser pour la prédiction).
- La mise à jour additive de l'état de la cellule est la clé qui empêche le gradient de disparaître lors de la rétropropagation.
- Les GRU sont une alternative plus simple et plus rapide aux LSTM, avec seulement deux portes (de mise à jour et de réinitialisation) et sans état de cellule séparé.
Avec cette compréhension des RNN, LSTM et GRU, vous avez maintenant les bases conceptuelles des modèles séquentiels qui ont dominé le traitement du langage naturel pendant des années. Ces idées de portes et de contrôle du flux d'information sont si puissantes qu'elles ont inspiré des mécanismes d'attention, qui sont au cœur des architectures Transformer et des modèles de langage (LLM) modernes que vous souhaitez maîtriser. Vous avez fait un grand pas vers votre objectif