Bonjour ! Dans la leçon précédente, nous avons exploré la théorie de l'apprentissage par transfert. Vous avez découvert pourquoi cette technique est si puissante, les deux stratégies principales (extraction de caractéristiques et réglage fin) et quand il est judicieux de l'utiliser. C'est le secret qui permet d'obtenir des résultats de pointe en vision par ordinateur sans avoir besoin de la puissance de calcul de Google ou de millions d'images.
Aujourd'hui, nous passons de la théorie à la pratique. L'objectif de cette leçon est de vous guider pas à pas pour adapter un réseau de neurones convolutif (CNN) pré-entraîné, comme ResNet, pour une nouvelle tâche de classification d'images en utilisant PyTorch. Nous allons mettre les mains dans le code, voir comment charger ces modèles, les modifier et les entraîner sur un nouveau jeu de données. Cette compétence est l'une des plus utiles et des plus employées dans le domaine de l'apprentissage profond.
1. La Recette de l'Apprentissage par Transfert
Adapter un modèle pré-entraîné suit une recette assez standard. Que vous utilisiez ResNet, EfficientNet ou une autre architecture, les étapes fondamentales restent les mêmes. Le processus consiste à traiter le modèle pré-entraîné comme deux parties distinctes : une base qui extrait les caractéristiques visuelles (les couches convolutives) et une tête qui classifie ces caractéristiques (les couches entièrement connectées).

Voici les étapes que nous allons suivre :
- Charger un modèle pré-entraîné depuis
torchvision.modelsavec ses poids appris sur ImageNet. - Geler les paramètres de l'extracteur de caractéristiques pour qu'ils ne soient pas mis à jour pendant l'entraînement.
- Identifier et remplacer la tête de classification du modèle par une nouvelle, adaptée au nombre de classes de notre problème.
- Configurer un optimiseur pour n'entraîner que les paramètres de la nouvelle tête de classification.
- Lancer la boucle d'entraînement sur notre nouveau jeu de données.
La vidéo suivante, que nous avons déjà consultée, montre un aperçu rapide de ce processus en action.
PyTorch Tutorial 15 - Transfer Learning
Cette vidéo de Patrick Loeber sur YouTube est un excellent rappel visuel du processus.
Pour vous rafraîchir la mémoire, regardez rapidement l'explication du concept. Ensuite, observez comment il charge le modèle ResNet18 pré-entraîné, puis comment il remplace la couche finale pour l'adapter à sa nouvelle tâche. C'est exactement ce que nous allons faire.
2. Mettre en œuvre le Processus en PyTorch
Voyons maintenant comment traduire chaque étape en code PyTorch.
Étape 1 & 2 : Charger le modèle et geler les poids
PyTorch rend le chargement de modèles pré-entraînés incroyablement simple. Nous allons utiliser la bibliothèque torchvision.models.
import torchvision.models as models


# Charger un modèle ResNet18 pré-entraîné
# La nouvelle syntaxe recommandée utilise le paramètre `weights`
model = models.resnet18(weights='IMAGENET1K_V1')


# Geler tous les paramètres du modèle
for param in model.parameters():
    param.requires_grad = False
La ligne param.requires_grad = False est cruciale. Elle indique à l'algorithme de rétropropagation de PyTorch d'ignorer ces paramètres. Aucun gradient ne sera calculé pour eux, et donc leurs valeurs (les poids appris sur ImageNet) ne changeront pas pendant notre entraînement. C'est la définition même de l'extraction de caractéristiques (feature extraction).
Le tutoriel officiel de PyTorch explique très bien cette étape.
Transfer Learning for Computer Vision Tutorial
Cet article de la documentation officielle de PyTorch est une référence incontournable. Il explique comment implémenter la stratégie d'extraction de caractéristiques.
Dans la section "ConvNet as fixed feature extractor", lisez l'explication et le code. Portez une attention particulière à la phrase : "Here, we need to freeze...". C'est exactement le code que nous venons de voir.
Étape 3 : Remplacer la tête de classification
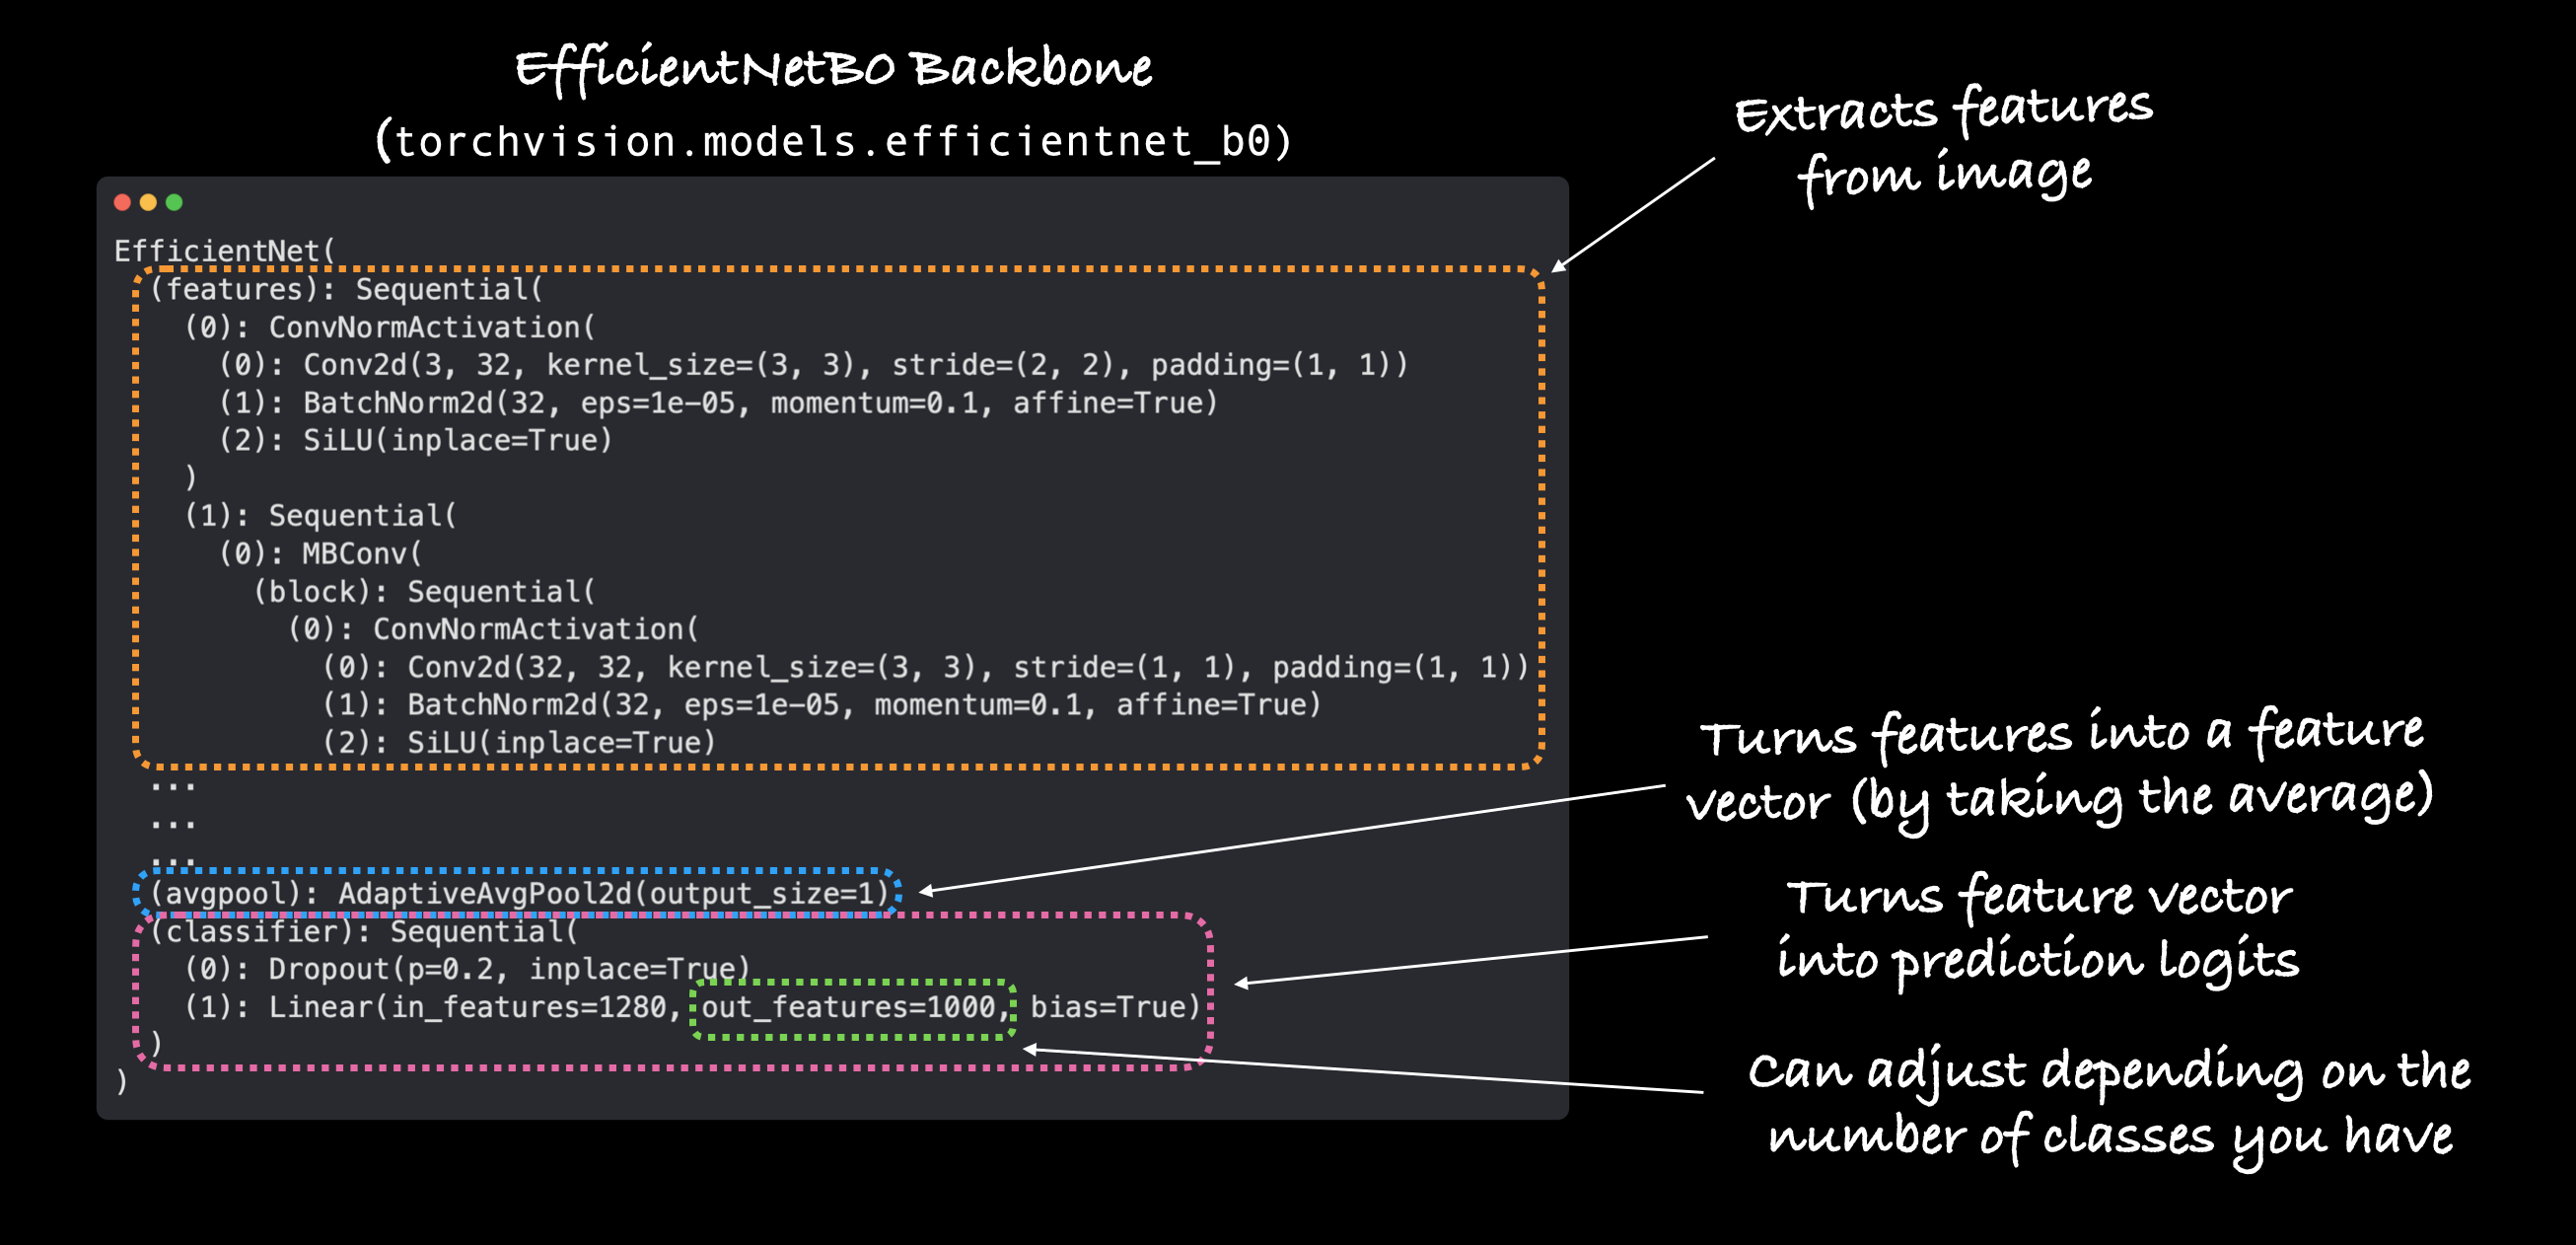
C'est l'étape la plus délicate, car elle dépend de l'architecture spécifique du modèle que vous utilisez. Pour un modèle ResNet, la tête de classification est une seule couche linéaire nommée fc (pour "fully connected"). Pour d'autres modèles, comme EfficientNet, elle peut être un bloc nn.Sequential nommé classifier.
La première chose à faire est donc d'inspecter la structure du modèle :
print(model)
Pour resnet18, vous verrez tout à la fin :... (fc): Linear(in_features=512, out_features=1000, bias=True)
Cela nous apprend deux choses :
- La couche à remplacer s'appelle
fc. - Elle prend en entrée un vecteur de 512 caractéristiques (
in_features=512).
Nous allons maintenant la remplacer par une nouvelle couche linéaire qui prendra 512 caractéristiques en entrée mais qui aura un nombre de sorties égal au nombre de classes de notre nouveau problème (par exemple, 10 classes pour des aliments).
# Nombre de classes de notre nouveau problème
num_classes = 10


# Récupérer le nombre de caractéristiques en entrée de la couche fc
num_ftrs = model.fc.in_features


# Créer une nouvelle couche linéaire et la remplacer
model.fc = nn.Linear(num_ftrs, num_classes)
Un point important : par défaut, les nouvelles couches que vous créez ont requires_grad = True. Donc, même si nous avons gelé tout le reste du modèle, les paramètres de cette nouvelle couche model.fc seront entraînables.
Cette flexibilité est au cœur de PyTorch. Différents modèles ont des têtes différentes, mais la logique reste la même : inspecter, trouver le nombre de in_features, et remplacer.
Étape 4 & 5 : Configurer l'optimiseur et entraîner
Maintenant que le modèle est prêt, la dernière étape consiste à s'assurer que l'optimiseur ne mettra à jour que les paramètres de notre nouvelle tête de classification. C'est plus efficace et cela garantit que nous ne modifions pas accidentellement les poids gelés.
import torch.optim as optim


# Définir la fonction de perte
criterion = nn.CrossEntropyLoss()


# Configurer l'optimiseur pour n'entraîner que les paramètres du classifieur
# On passe model.fc.parameters() au lieu de model.parameters()
optimizer = optim.Adam(model.fc.parameters(), lr=0.001)


# La boucle d'entraînement est la même que celle que vous avez déjà écrite !
# train_model(model, criterion, optimizer, ...)
C'est tout ! Le reste du code (la boucle d'entraînement, la boucle d'évaluation, le chargement des données) est exactement le même que celui que vous avez utilisé dans les leçons précédentes pour entraîner un modèle à partir de zéro. La seule différence est la manière dont nous avons préparé le modèle et l'optimiseur.
3. Exemple Complet : Classification de Fast-Food
Pour consolider tout cela, nous allons suivre un tutoriel complet en arabe qui applique exactement cette recette pour classer des images de fast-food en 10 catégories (burger, pizza, frites, etc.). C'est un excellent exemple pratique.
تصنيف الوجبات السريعة باستخدام نقل التعلم وپاي تورچ
Cet article du blog "Deep Learning Arabic" est un guide pratique parfait. Il vous montrera comment appliquer l'apprentissage par transfert avec ResNet18 sur un jeu de données amusant.
Suivez les étapes du code dans la section "تنفيذ الكود" : Commencez par l'importation des bibliothèques et la configuration du périphérique. Observez les transformations de données, qui sont standards pour les modèles pré-entraînés sur ImageNet. Voyez comment les données sont chargées avec ImageFolder et DataLoader. La section "الخطوة 6" est le cœur de notre leçon. Regardez attentivement comment le modèle ResNet18 est chargé et sa couche fc est remplacée. Notez que l'auteur ne gèle pas explicitement les couches ici, optant pour une stratégie de fine-tuning de tout le modèle. Pour une stratégie d'extraction de caractéristiques pure, nous aurions ajouté la boucle for pour geler les poids avant cette étape. Observez comment l'optimiseur et la fonction de perte sont définis et comment la fonction train_model est appelée. Enfin, lisez la conclusion pour un excellent résumé des points clés appris. L'auteur atteint une précision de plus de 86% en moins de 30 minutes, un résultat qui aurait été très difficile à obtenir en entraînant un CNN à partir de zéro avec un jeu de données de cette taille.
Conclusion
Aujourd'hui, vous avez franchi une étape majeure en passant de la théorie de l'apprentissage par transfert à son application pratique. Vous avez maintenant une "recette" puissante et réutilisable pour aborder une grande variété de problèmes de classification d'images.
Points clés à retenir :
- Le processus d'adaptation d'un modèle pré-entraîné consiste à charger, geler, remplacer et entraîner.
- Utilisez
print(model)pour inspecter l'architecture et trouver le nom de la tête de classification (fc,classifier, etc.) et le nombre dein_features. - Le gel des couches se fait en mettant leur attribut
requires_gradàFalse. C'est la base de la stratégie d'extraction de caractéristiques. - Lors de l'entraînement, l'optimiseur doit être configuré pour ne mettre à jour que les paramètres de la nouvelle tête de classification (
model.fc.parameters()). - Cette méthode permet d'obtenir d'excellentes performances rapidement, même avec des jeux de données relativement petits.
Nous avons beaucoup parlé d'images, qui sont des données structurées en grilles 2D. Cependant, de nombreux problèmes intéressants, notamment dans le traitement du langage naturel (votre objectif final), concernent des données séquentielles comme du texte ou des séries temporelles. Les CNN ne sont pas conçus pour cela. Dans la prochaine leçon, nous aborderons une nouvelle classe d'architectures spécialement conçue pour gérer les séquences : les Réseaux de Neurones Récurrents (RNN).