Bonjour ! Dans la leçon précédente, vous avez construit votre premier réseau de neurones convolutif (CNN) à partir de zéro, une étape impressionnante qui vous a permis de comprendre en profondeur le fonctionnement interne de ces modèles. Vous avez vu comment entraîner un modèle sur le jeu de données MNIST pour qu'il apprenne à reconnaître des chiffres. Cependant, entraîner un modèle aussi profond à partir de rien demande beaucoup de données et de temps de calcul. Que se passe-t-il lorsque nous abordons des problèmes plus complexes du monde réel, mais que nous ne disposons pas d'un jeu de données de la taille d'ImageNet (plus d'un million d'images) ni de la puissance de calcul de Google ou Meta ?
C'est là qu'intervient l'une des idées les plus puissantes et les plus pratiques de l'apprentissage profond. L'objectif de la leçon d'aujourd'hui est d'expliquer le concept de l'apprentissage par transfert (transfer learning) avec des modèles pré-entraînés. Nous allons découvrir comment nous pouvons nous "hisser sur les épaules de géants" en tirant parti du travail déjà effectué par des chercheurs pour résoudre nos propres problèmes de manière beaucoup plus efficace. Cette technique est non seulement fondamentale en vision par ordinateur, mais elle est aussi au cœur de la révolution des grands modèles de langage (LLM), ce qui la rend directement pertinente pour votre objectif final.
1. Qu'est-ce que l'Apprentissage par Transfert ?
Imaginez que vous ayez passé des années à apprendre la cuisine italienne. Vous maîtrisez la fabrication des pâtes, l'équilibre des sauces, l'art de la cuisson. Si vous décidez ensuite d'apprendre la cuisine chinoise, devez-vous réapprendre des compétences de base comme couper un oignon, gérer la chaleur d'une poêle ou comprendre l'équilibre des saveurs ? Bien sûr que non. Vous transférez une grande partie de vos connaissances existantes et vous vous concentrez sur l'apprentissage des nouvelles techniques et des nouveaux ingrédients spécifiques à la cuisine chinoise.
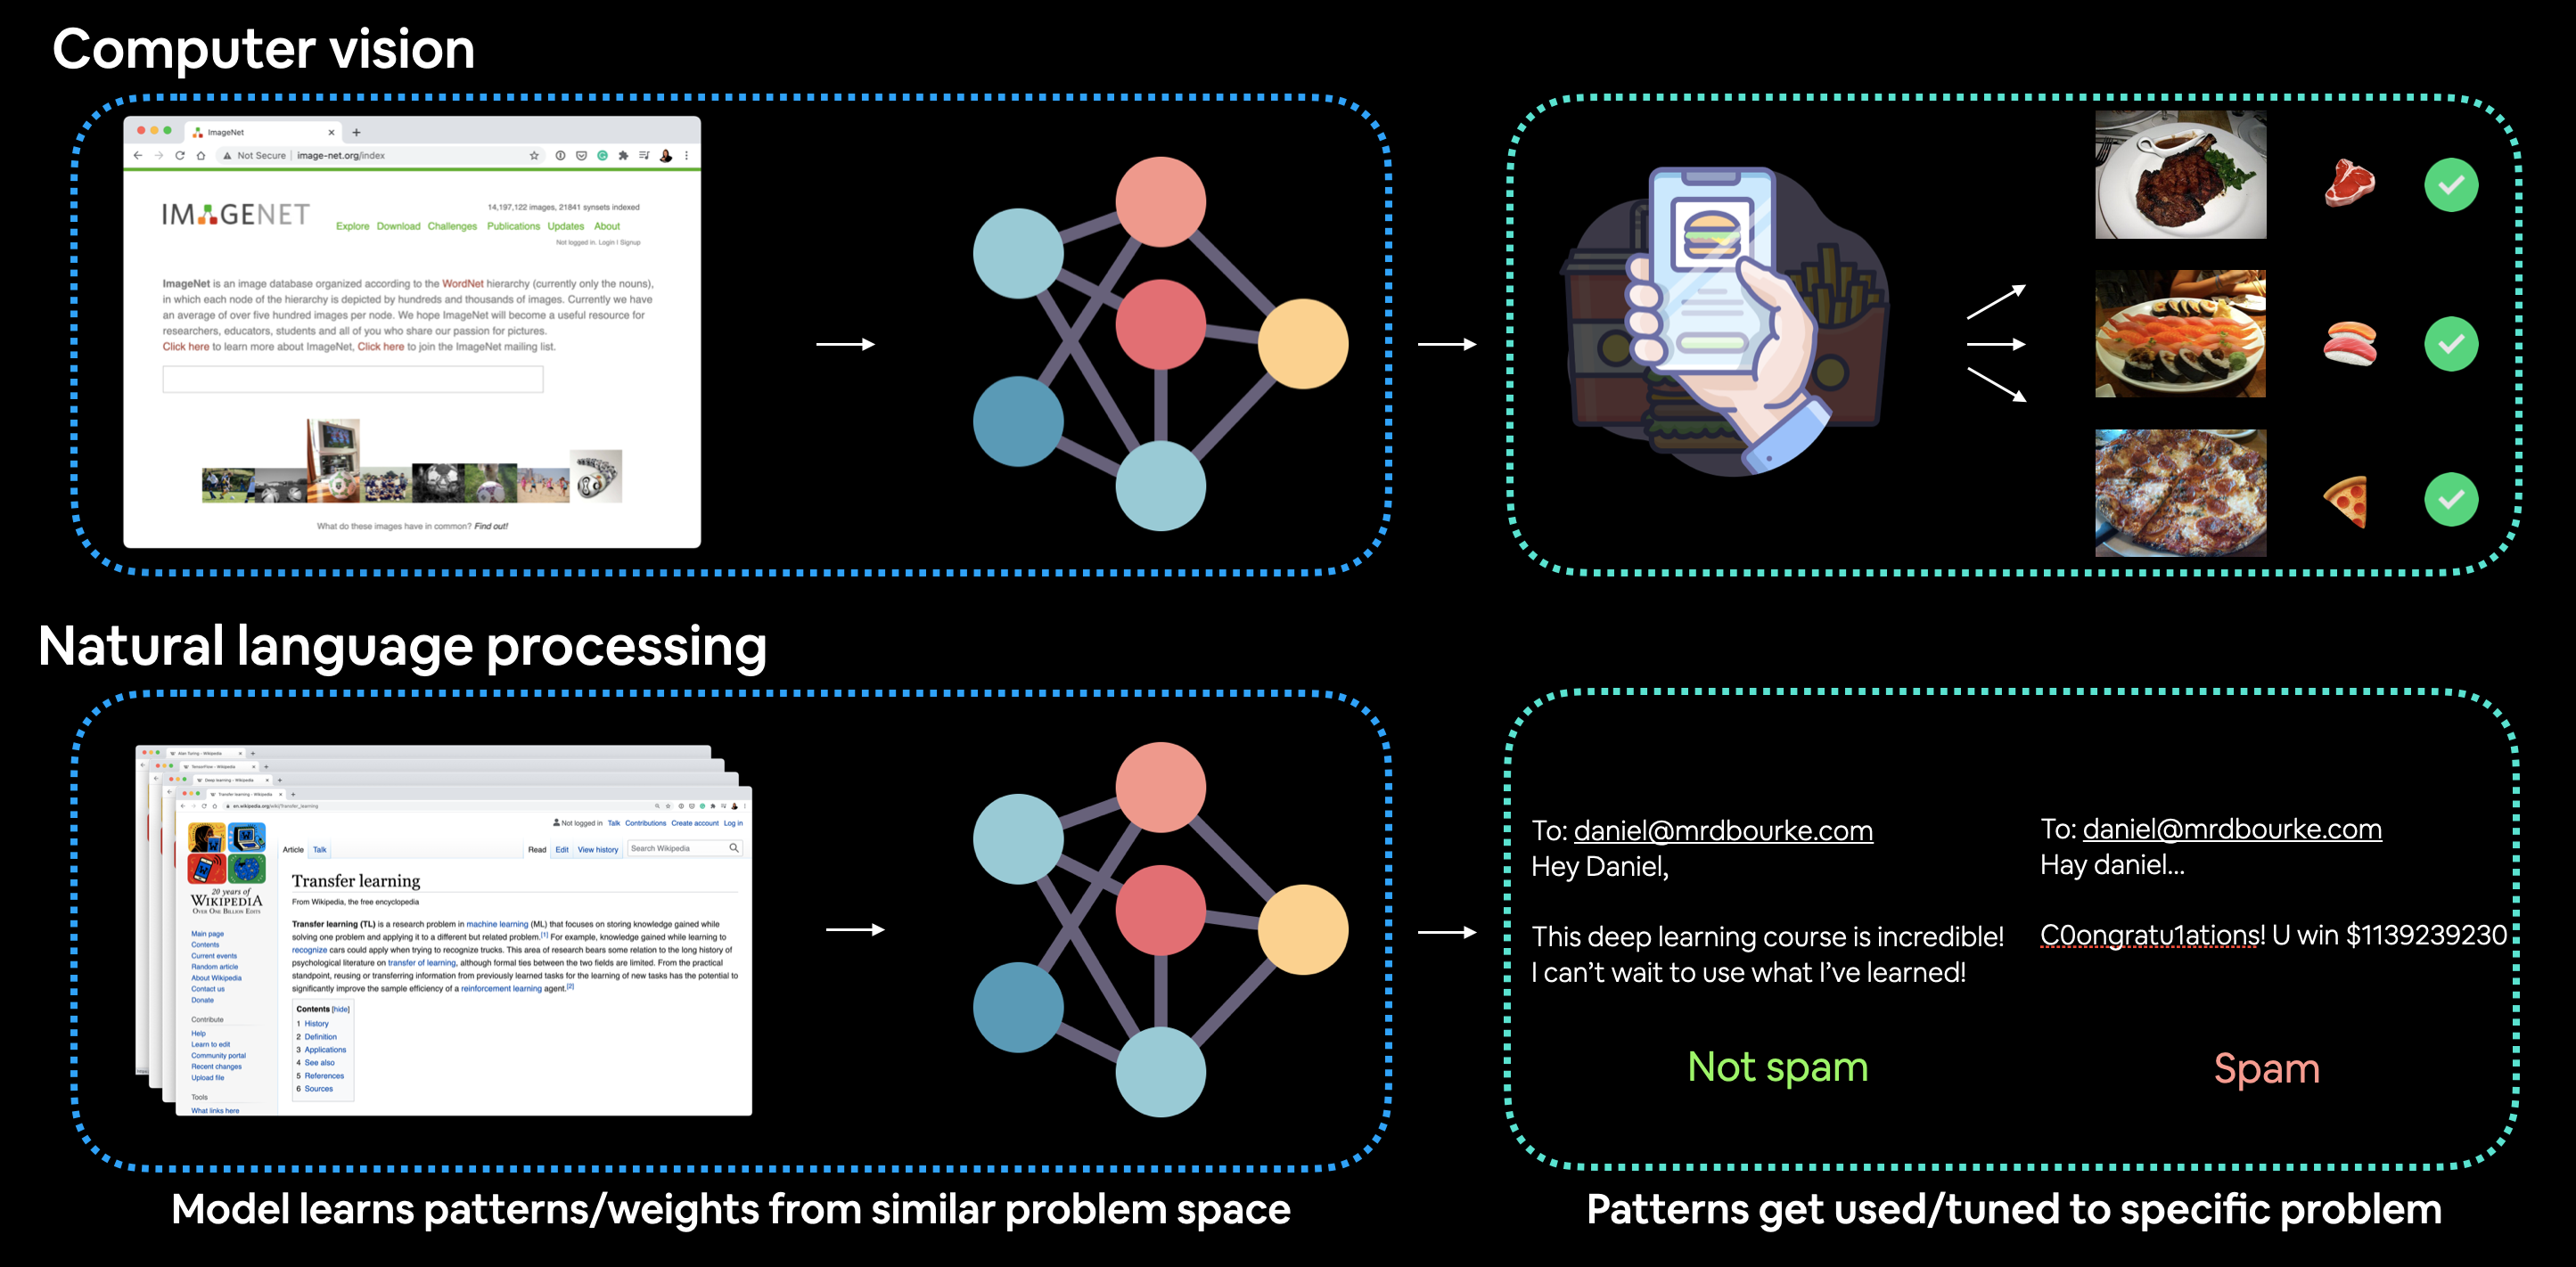
L'apprentissage par transfert en deep learning fonctionne sur le même principe. Au lieu d'entraîner un réseau de neurones à partir de poids initialisés de manière aléatoire (ce qui équivaut à apprendre la cuisine à partir de zéro), nous partons d'un modèle pré-entraîné. Il s'agit d'un modèle qui a déjà été entraîné sur un jeu de données massif et généraliste, le plus souvent ImageNet pour la vision par ordinateur.
Le génie de cette approche réside dans ce que le réseau apprend. Les premières couches d'un CNN apprennent à détecter des caractéristiques très générales et de bas niveau : des bords, des coins, des dégradés de couleurs, des textures. Ces caractéristiques sont universelles et utiles pour presque n'importe quelle tâche de vision. Les couches plus profondes apprennent à combiner ces caractéristiques simples pour reconnaître des motifs plus complexes : des yeux, des roues, des formes géométriques.
Andrew Ng explique cette intuition de manière très claire dans la vidéo suivante.
Cette vidéo de DeepLearningAI, présentée par Andrew Ng, explique l'idée fondamentale derrière l'apprentissage par transfert et pourquoi il est si efficace.
Regardez l'introduction qui explique l'idée de base en utilisant l'exemple du transfert de la reconnaissance d'images à la radiologie. Ensuite, concentrez-vous sur la section qui explique pourquoi cela fonctionne : les caractéristiques de bas niveau apprises sur un grand jeu de données sont transférables à une nouvelle tâche.
Ainsi, en utilisant un modèle pré-entraîné, nous héritons de toute cette connaissance accumulée sur la structure visuelle du monde. Nous n'avons plus besoin de la réapprendre.
2. Comment fonctionne l'Apprentissage par Transfert ?
Maintenant que nous avons l'intuition, examinons le mécanisme. Le processus se déroule en plusieurs étapes logiques. Nous pouvons le visualiser en pensant à la structure d'un CNN, qui est généralement composée de deux parties :
- L'extracteur de caractéristiques (Feature Extractor) : C'est la base convolutive du réseau (les couches
Conv2detMaxPool2d), qui transforme l'image d'entrée en une représentation numérique riche de ses caractéristiques. - Le classifieur (Classifier) : Ce sont les dernières couches entièrement connectées (
Linear) qui prennent la représentation des caractéristiques et la transforment en une prédiction pour la tâche finale (par exemple, les probabilités pour chacune des 1000 classes d'ImageNet).
L'apprentissage par transfert consiste à séparer ces deux parties.
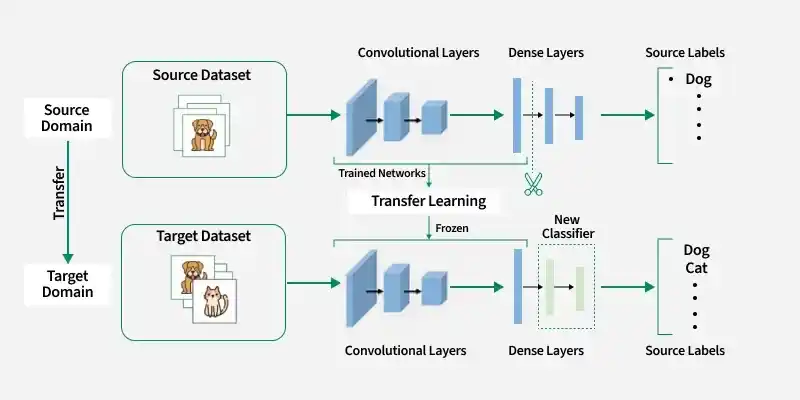
Le processus peut être décomposé comme suit :
-
Partir d'un modèle pré-entraîné : On charge un modèle existant, comme ResNet ou VGG, avec les poids appris sur ImageNet. PyTorch rend cela très facile via
torchvision.models. -
Geler l'extracteur de caractéristiques : On "gèle" les poids de toutes les couches convolutives. Geler signifie que nous indiquons à PyTorch que les gradients ne doivent pas être calculés pour ces couches lors de la rétropropagation. Leurs poids ne seront donc pas mis à jour pendant notre entraînement. En pratique, cela se fait en définissant
requires_grad = Falsepour les paramètres de ces couches. -
Remplacer le classifieur : Le classifieur d'origine est spécifique à la tâche source (par exemple, il a 1000 sorties pour ImageNet). Nous le supprimons et le remplaçons par un nouveau classifieur dont la couche de sortie correspond au nombre de classes de notre nouvelle tâche (par exemple, 2 sorties pour une classification "chien vs chat").
-
Entraîner le nouveau classifieur : On entraîne ensuite le modèle sur notre propre jeu de données. Comme la majeure partie du réseau est gelée, seuls les poids de notre nouveau (et généralement petit) classifieur sont appris. C'est beaucoup plus rapide et nécessite beaucoup moins de données que d'entraîner tout le réseau.
L'article suivant résume bien ce processus.
Transfer Learning For Beginner | Towards Data Science
Cet article de Towards Data Science décrit le processus de manière très directe.
Lisez la section "What is Transfer Learning?". Concentrez-vous sur le paragraphe qui détaille les étapes concrètes : la description du processus de découpage, de remplacement et d'entraînement.
3. Les Deux Stratégies Principales : Feature Extraction vs. Fine-Tuning
Ce que nous avons décrit jusqu'à présent est la forme la plus simple de l'apprentissage par transfert, souvent appelée Feature Extraction (extraction de caractéristiques). C'est parce que nous utilisons le modèle pré-entraîné uniquement comme un extracteur de caractéristiques fixe.
Il existe une deuxième stratégie, plus puissante mais plus exigeante : le Fine-Tuning (réglage fin).
-
Feature Extraction : On gèle toute la base convolutive et on n'entraîne que le nouveau classifieur que l'on a ajouté. C'est rapide et efficace, surtout si notre nouveau jeu de données est petit.
-
Fine-Tuning : Au lieu de geler tout l'extracteur de caractéristiques, on "dégèle" une partie ou la totalité de ses couches et on les entraîne également, mais avec un très faible taux d'apprentissage (learning rate). L'idée est de ne pas modifier radicalement les poids pré-entraînés, mais de les "ajuster" ou de les "affiner" légèrement pour qu'ils s'adaptent mieux aux spécificités de notre nouveau jeu de données.
La vidéo suivante montre la mise en œuvre de ces deux stratégies et compare leurs résultats.
PyTorch Tutorial 15 - Transfer Learning
Cette vidéo de Patrick Loeber sur YouTube met en œuvre l'apprentissage par transfert en PyTorch et illustre clairement la différence entre le fine-tuning et l'extraction de caractéristiques.
Observez comment il met en place les deux approches. D'abord, le fine-tuning, où tout le modèle est ré-entraîné. Ensuite, l'approche de feature extraction, où il gèle les couches de base en utilisant requires_grad = False. Enfin, il compare les résultats, montrant que le fine-tuning donne une meilleure précision, mais que l'extraction de caractéristiques est beaucoup plus rapide.
En résumé, le choix entre ces deux stratégies dépend de la taille de votre jeu de données et de la similarité avec le jeu de données d'origine :
- Petit jeu de données, similaire à l'original : L'extraction de caractéristiques est souvent suffisante et plus sûre pour éviter le sur-apprentissage.
- Grand jeu de données, similaire à l'original : Le fine-tuning de tout le réseau peut donner les meilleures performances.
- Petit jeu de données, différent de l'original : La prudence est de mise. Il peut être judicieux de ne faire du fine-tuning que sur les dernières couches de l'extracteur de caractéristiques, car les premières couches (bords, couleurs) sont plus universelles.
4. Quand utiliser l'Apprentissage par Transfert ?
L'apprentissage par transfert est incroyablement puissant, mais il n'est pas une solution miracle pour tous les problèmes. Il fonctionne mieux sous certaines conditions.
Revenons à la vidéo d'Andrew Ng, qui résume parfaitement les conditions dans lesquelles l'apprentissage par transfert est le plus judicieux.
Regardez la section commençant à ce point. Il explique que le transfert est plus efficace lorsque la tâche source (Tâche A) dispose de beaucoup plus de données que la tâche cible (Tâche B), et que les tâches partagent des caractéristiques de bas niveau pertinentes.
Pour résumer, l'apprentissage par transfert est particulièrement indiqué lorsque :
- Vous avez un jeu de données cible relativement petit. Si vous aviez des millions d'images, vous pourriez envisager d'entraîner un modèle à partir de zéro, mais pour quelques milliers, voire quelques centaines d'images, le transfert est presque toujours la meilleure approche.
- Vous souhaitez économiser du temps et des ressources de calcul. Entraîner un grand CNN à partir de zéro peut prendre des jours ou des semaines sur des GPU puissants. Le fine-tuning d'un modèle pré-entraîné est beaucoup plus rapide.
- La tâche source et la tâche cible sont liées. Le transfert de connaissances d'un modèle entraîné à reconnaître des animaux ne sera probablement pas très utile pour analyser des spectres audio. Cependant, les caractéristiques apprises sur des images d'objets du quotidien (ImageNet) sont très utiles pour reconnaître des types spécifiques de voitures, de fleurs ou même des cellules dans des images médicales.
Le principal inconvénient est que si les jeux de données source et cible sont trop différents, les caractéristiques apprises peuvent ne pas être pertinentes, et l'apprentissage par transfert pourrait ne pas améliorer, voire dégrader les performances.
Conclusion
Aujourd'hui, nous avons exploré le concept fondamental de l'apprentissage par transfert. C'est une technique qui a véritablement démocratisé l'accès à des modèles de deep learning de haute performance.
Points clés à retenir :
- L'apprentissage par transfert consiste à réutiliser un modèle pré-entraîné sur une tâche à grande échelle (tâche source) comme point de départ pour une nouvelle tâche (tâche cible).
- Le processus implique généralement de conserver la base convolutive du modèle (l'extracteur de caractéristiques) et de remplacer sa tête de classification par une nouvelle, adaptée à la tâche cible.
- Les deux stratégies principales sont l'extraction de caractéristiques (geler la base et n'entraîner que le nouveau classifieur) et le fine-tuning (entraîner également une partie ou la totalité de la base avec un faible taux d'apprentissage).
- Cette technique est particulièrement efficace lorsque le jeu de données cible est petit, permettant d'économiser du temps et des ressources tout en obtenant d'excellentes performances.
Maintenant que vous comprenez la théorie et la logique derrière l'apprentissage par transfert, la prochaine étape est de mettre les mains dans le code. Dans la prochaine leçon, nous allons adapter un modèle CNN pré-entraîné (comme ResNet) pour une nouvelle tâche de classification d'images en utilisant PyTorch. Vous verrez par vous-même à quel point cette approche est puissante et efficace en pratique.