Bonjour ! Dans notre leçon précédente, nous avons jeté les bases de l'apprentissage automatique en distinguant les trois grands paradigmes : supervisé, non supervisé et par renforcement. Nous avons brièvement mentionné que l'apprentissage supervisé, qui utilise des données étiquetées, se divise en deux tâches principales.
Aujourd'hui, nous allons nous concentrer entièrement sur cette distinction fondamentale. L'objectif est de comprendre en profondeur la différence entre les tâches de régression et de classification. Cette distinction est l'une des plus importantes en apprentissage automatique, car elle détermine le type de modèle que vous allez construire, les algorithmes que vous pouvez utiliser et la manière dont vous évaluerez sa performance.
1. La différence fondamentale : Quantité vs Catégorie
En apprentissage supervisé, le but est toujours de prédire une sortie (Y) à partir d'une entrée (X). La nature de cette sortie est ce qui sépare la régression de la classification.
-
La régression prédit une valeur continue ou numérique. La sortie est une quantité.
- Question type : "Combien ?" ou "Quelle valeur ?"
- Exemples : Quel sera le prix d'une maison ? Quelle sera la température demain ? Quel sera le score d'un étudiant à un examen ?
-
La classification prédit une étiquette discrète ou une catégorie. La sortie est une classe.
- Question type : "Lequel ?" ou "À quelle catégorie appartient-il ?"
- Exemples : Cet email est-il un spam ou non ? Cette tumeur est-elle maligne ou bénigne ? Quelle est la race de ce chien sur la photo ?
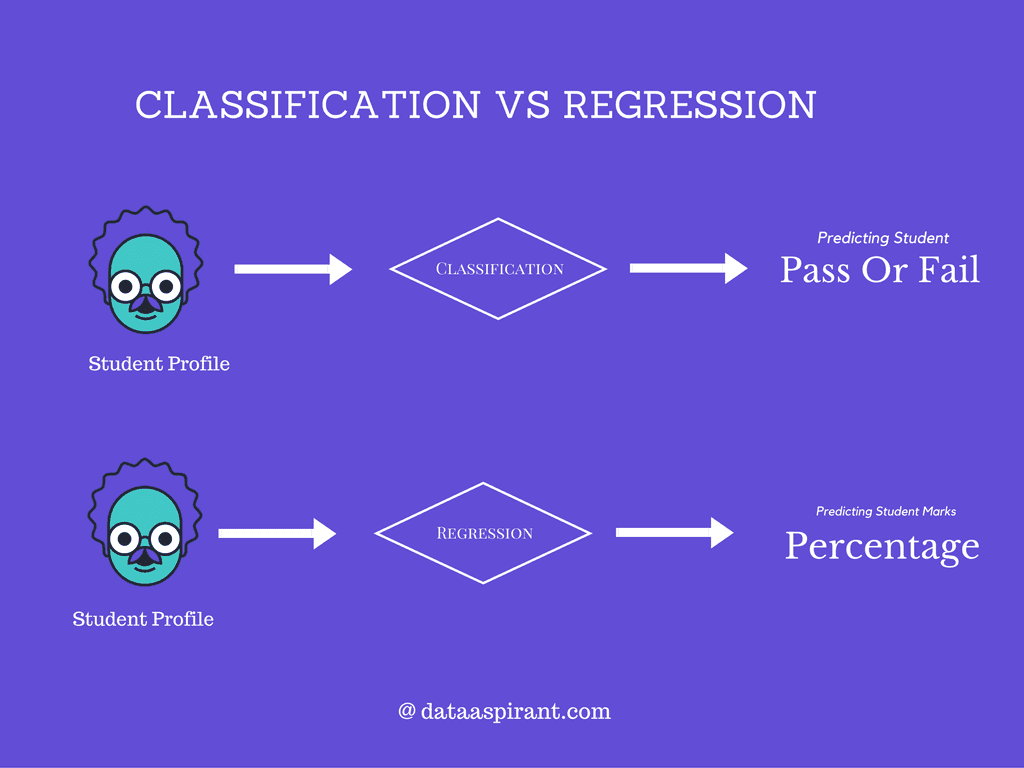
L'image suivante illustre parfaitement cette idée. À partir d'un "profil étudiant", un problème de classification chercherait à prédire une catégorie ("Admis ou Échec"), tandis qu'un problème de régression chercherait à prédire une quantité (le "Pourcentage").
Pour formaliser ces concepts, l'article suivant d'IBM offre une excellente introduction.
Cet article pose les bases de la distinction entre classification et régression, en utilisant un exemple intuitif dans un contexte hospitalier.
Lisez l'introduction jusqu'à la fin du premier paragraphe pour une définition claire. Ensuite, lisez la section "Intuitive divide" jusqu'à la fin de l'exemple de l'hôpital. Cet exemple concret vous aidera à visualiser la différence entre prédire la durée du séjour d'un patient (régression) et prédire s'il sera réadmis (classification).
2. Le type de sortie définit la tâche
Le point crucial à retenir est que la nature de la variable cible y que vous essayez de prédire détermine si vous avez un problème de régression ou de classification.
Pour obtenir une autre perspective, particulièrement claire sur la manière dont les modèles sont évalués différemment, l'article suivant est très utile.
Difference Between Classification and Regression in ...
Cet article de Machine Learning Mastery est très direct et explique non seulement la différence entre les deux tâches, mais aussi comment leur évaluation diffère fondamentalement.
Veuillez lire les deux sections suivantes : Classification Predictive Modeling : Notez comment la performance est mesurée par l'exactitude (accuracy), c'est-à-dire le pourcentage de prédictions correctes. Regression Predictive Modeling : Observez ici que la performance est mesurée par une erreur (comme le RMSE), qui quantifie à quel point les prédictions sont "éloignées" des valeurs réelles.
Cette différence dans l'évaluation est logique : pour une prédiction de catégorie (classification), une prédiction est soit correcte, soit incorrecte. Pour une prédiction de quantité (régression), une prédiction peut être plus ou moins "proche" de la vérité. Prédire un prix de maison à 250 100 € alors que le vrai prix est de 250 000 € est une excellente prédiction, même si elle n'est pas parfaitement exacte.

3. Pourquoi ne pas utiliser la régression pour la classification ?
C'est une question que beaucoup de débutants se posent. Si nous avons un problème de classification binaire (avec deux classes, 0 et 1), pourquoi ne pas simplement utiliser un modèle de régression linéaire et décider que si la sortie est > 0.5, on prédit la classe 1, et sinon, on prédit la classe 0 ?
Cela peut sembler une bonne idée, mais elle est en réalité très peu robuste. Une seule nouvelle donnée, surtout si elle est atypique (un "outlier"), peut complètement fausser la droite de régression et rendre notre seuil de décision inefficace.
La vidéo suivante, de la chaîne Elgouhary AI (en arabe), démontre ce problème de manière exceptionnellement claire à l'aide de l'exemple classique de la classification de tumeurs.
Machine Learning || Linear Regression vs. Classification
Cette vidéo explique pourquoi la régression linéaire n'est pas adaptée aux problèmes de classification et introduit la nécessité d'une autre approche : la régression logistique.
Regardez attentivement la section qui commence à l'explication de l'exemple de tumeur. L'animateur montre d'abord comment une droite de régression avec un seuil à 0.5 semble fonctionner correctement sur un premier ensemble de données. Puis, il ajoute un seul point de données éloigné (à 3:55), et montre comment la nouvelle droite de régression est "tirée" par ce point, ce qui déplace le seuil de décision et conduit à des classifications erronées (à 4:48).
Cette démonstration visuelle est essentielle. Elle prouve que même si l'idée d'utiliser la régression pour la classification semble astucieuse, elle n'est pas fiable en pratique. C'est pourquoi nous avons besoin d'algorithmes spécifiquement conçus pour la classification, comme la régression logistique, que nous étudierons bientôt.
4. Différences dans les algorithmes et l'évaluation
La distinction entre régression et classification a des conséquences directes sur les outils que vous utilisez.
Cet article détaille les algorithmes et les métriques d'évaluation spécifiques à chaque type de tâche.
Parcourez la section Common regression versus classification algorithms. Notez que certains algorithmes comme les arbres de décision (Decision Trees) ou les SVM peuvent être adaptés aux deux tâches, tandis que d'autres sont spécialisés. Retenez en particulier : Régression Linéaire : Pour la régression. Régression Logistique : Pour la classification (malgré son nom !). Ensuite, lisez la section Evaluation metrics. Comparez simplement les noms des métriques pour la régression (MSE, RMSE, R-squared) avec celles pour la classification (Accuracy, Precision, Recall, Confusion Matrix). Vous n'avez pas besoin de comprendre chaque formule en détail pour l'instant, mais reconnaissez qu'il s'agit de deux ensembles de mesures complètement différents.
Conclusion
Aujourd'hui, vous avez solidifié votre compréhension de la différence fondamentale entre la régression et la classification, les deux piliers de l'apprentissage supervisé.
Points clés à retenir :
- Régression : Prédit une quantité continue (ex: prix, température). Évaluée par des métriques d'erreur (ex: RMSE).
- Classification : Prédit une catégorie discrète (ex: spam/non-spam, admis/échec). Évaluée par des métriques d'exactitude (ex: Accuracy, Precision).
- La nature de la sortie
Ydétermine le type de tâche. - Il ne faut pas utiliser des algorithmes de régression pour des tâches de classification, car ils sont sensibles aux outliers et peuvent produire des résultats peu fiables.
- Des algorithmes et des métriques d'évaluation différents sont utilisés pour chaque tâche.
Maintenant que vous savez identifier le type de problème supervisé auquel vous êtes confronté, l'étape suivante consiste à préparer vos données pour entraîner un modèle. Dans la prochaine leçon, nous aborderons une étape cruciale de tout projet de ML : comment diviser un ensemble de données en ensembles d'entraînement et de test, et pourquoi c'est essentiel pour évaluer honnêtement la performance de votre modèle.