Bonjour ! Dans la leçon précédente, nous avons établi une distinction claire entre les problèmes de régression et de classification. Maintenant que vous savez identifier le type de tâche d'apprentissage supervisé, l'étape suivante consiste à préparer vos données pour entraîner et, surtout, évaluer un modèle de manière fiable.
Aujourd'hui, nous allons nous pencher sur l'une des pratiques les plus fondamentales et non négociables en apprentissage automatique : la division de votre ensemble de données. L'objectif de cette leçon est d'apprendre à diviser un jeu de données en un ensemble d'entraînement et un ensemble de test, et de comprendre la raison cruciale qui sous-tend cette pratique. C'est la seule façon de savoir si votre modèle a réellement appris quelque chose d'utile ou s'il a simplement "triché".
1. Pourquoi ne pas s'entraîner sur tout ? La nécessité d'une évaluation impartiale
Imaginez que vous êtes un enseignant qui prépare des élèves pour un examen national. Vous leur donnez des exercices des années précédentes pour qu'ils s'entraînent. Le jour de l'évaluation, leur demanderiez-vous de refaire exactement les mêmes exercices ? Probablement pas. Vous leur donneriez de nouvelles questions pour vérifier s'ils ont compris les concepts sous-jacents, et pas seulement mémorisé les réponses des exercices d'entraînement.
En apprentissage automatique, le principe est exactement le même. Si nous entraînons un modèle sur la totalité de nos données, puis que nous évaluons sa performance sur ces mêmes données, nous n'avons aucun moyen de savoir s'il a généralisé les tendances ou s'il a simplement "appris par cœur" les réponses. Cette mémorisation est un phénomène appelé surapprentissage (overfitting), que nous étudierons plus en détail prochainement.
Pour obtenir une mesure honnête et impartiale de la performance de notre modèle, nous devons l'évaluer sur des données qu'il n'a jamais vues pendant sa phase d'apprentissage.
La solution est de diviser notre ensemble de données initial en deux parties distinctes :
- L'ensemble d'entraînement (training set) : La plus grande partie des données, utilisée pour "enseigner" au modèle. Le modèle examine ces données (les caractéristiques
Xet les étiquettesy) pour apprendre les relations entre elles. - L'ensemble de test (test set) : Une plus petite partie des données, mise de côté et gardée précieusement. Elle n'est utilisée qu'une seule fois, à la toute fin, pour évaluer la performance finale du modèle entraîné sur des données "fraîches".
L'article suivant de Machine Learning Mastery explique très clairement cette logique.
Train-Test Split for Evaluating Machine Learning Algorithms
Cet article explique la justification fondamentale de la division entraînement-test pour évaluer les algorithmes d'apprentissage automatique.
Lisez la section intitulée "Train-Test Split Evaluation". Portez une attention particulière à l'objectif principal : "estimer la performance du modèle d'apprentissage automatique sur de nouvelles données". Lisez également la section "When to Use the Train-Test Split" qui explique que cette méthode est appropriée lorsque le jeu de données est suffisamment grand.
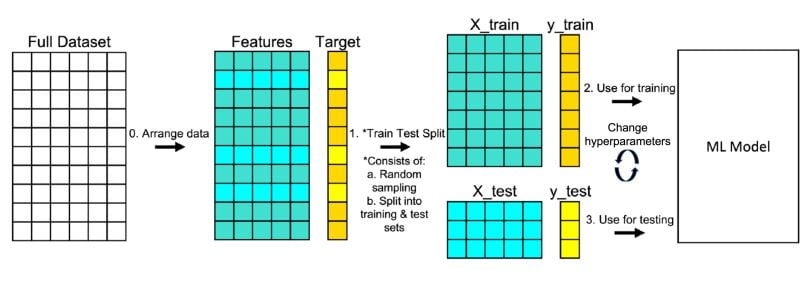
Le diagramme suivant illustre parfaitement ce flux de travail. On part d'un jeu de données complet, on le sépare en caractéristiques (Features) et cible (Target), puis on le divise en sous-ensembles d'entraînement et de test avant de construire le modèle.
2. Comment diviser les données avec Scikit-learn
Heureusement, vous n'avez pas besoin de coder cette division manuellement. La bibliothèque Scikit-learn, que nous utiliserons tout au long de ce module, fournit une fonction très pratique pour cela : train_test_split.
Cette fonction prend vos données de caractéristiques (X) et de cible (y) en entrée et les divise en quatre sorties :
X_train: Les caractéristiques pour l'entraînement.X_test: Les caractéristiques pour le test.y_train: Les cibles correspondantes pour l'entraînement.y_test: Les cibles correspondantes pour le test.
L'image ci-dessous schématise les entrées et les sorties de cette fonction.

Pour une explication détaillée et des exemples de code, l'article de Real Python est une excellente ressource.
Split Your Dataset With scikit-learn's train_test_split() – Real Python
Cet article est un guide pratique complet sur l'utilisation de train_test_split. Il vous montrera comment l'utiliser et expliquera ses paramètres les plus importants.
Commencez par la section "Application of train_test_split()". Cette partie présente la fonction et ses arguments les plus courants. Ensuite, suivez attentivement l'exemple de code qui commence par la création d'un jeu de données simple. Concentrez-vous sur les points suivants : L'appel de base à la fonction : x_train, x_test, y_train, y_test = train_test_split(x, y) Contrôler la taille de la division avec le paramètre test_size. Assurer la reproductibilité avec le paramètre random_state. C'est crucial pour que votre travail soit cohérent. Maintenir les proportions des classes avec le paramètre stratify=y, particulièrement utile pour les problèmes de classification. Ne vous inquiétez pas de l'argument shuffle=False pour l'instant ; le comportement par défaut (mélange aléatoire) est presque toujours ce que vous voudrez.
3. Les paramètres clés à maîtriser
Reprenons les paramètres les plus importants que vous venez de voir :
-
test_size(outrain_size) : Ce paramètre, généralement un nombre flottant entre 0 et 1, définit la proportion du jeu de données à allouer à l'ensemble de test. Par exemple,test_size=0.2signifie que 20 % des données seront pour le test et les 80 % restants pour l'entraînement. Les répartitions courantes sont 80/20 ou 70/30. -
random_state: La fonctiontrain_test_splitmélange les données de manière aléatoire avant de les diviser. C'est une bonne chose, car cela évite que l'ordre des données n'influence la division. Cependant, si vous exécutez le code plusieurs fois, vous obtiendrez une division différente à chaque fois. En fixantrandom_stateà un entier (par exemple,random_state=42), vous garantissez que la division "aléatoire" sera la même à chaque exécution. Cela rend vos résultats reproductibles. La vidéo suivante explique très bien ce concept.
Machine Learning Tutorial Python - 7: Training and Testing Data
Cette vidéo de codebasics montre de manière concise pourquoi le paramètre random_state est important.
Regardez la partie de cette explication où le présentateur montre comment le contenu de X_train change à chaque exécution, puis comment il se fige une fois random_state défini.
stratify: C'est un paramètre essentiel pour les tâches de classification. Imaginez que vous ayez un jeu de données avec 90 % d'échantillons de la classe A et 10 % de la classe B (un jeu de données "déséquilibré"). Une division purement aléatoire pourrait, par malchance, mettre la plupart des rares échantillons de la classe B dans l'ensemble de test, laissant l'ensemble d'entraînement presque sans exemples de cette classe. Pour éviter cela, on utilisestratify=y. Cela garantit que la proportion de chaque classe sera la même dans l'ensemble d'entraînement et l'ensemble de test qu'elle ne l'était dans le jeu de données original.
L'article de Machine Learning Mastery contient un exemple parfait qui illustre l'importance de la stratification.
Train-Test Split for Evaluating Machine Learning Algorithms
Cette section montre un exemple clair de l'impact de la stratification sur un jeu de données déséquilibré.
Lisez la section "Stratified Train-Test Splits". Comparez le résultat du comptage des classes (Counter) dans le premier exemple (sans stratify) et dans le second (avec stratify=y). Vous verrez que seule la seconde méthode préserve parfaitement les proportions.
4. Un aperçu de l'avenir : L'ensemble de validation
Nous avons donc un ensemble pour l'entraînement et un pour le test final. Mais que se passe-t-il si nous voulons essayer différents modèles (par exemple, une régression linéaire contre un arbre de décision) ou ajuster les réglages d'un modèle (ses "hyperparamètres") pour trouver la meilleure configuration ?
Si nous utilisons l'ensemble de test pour faire ces choix, nous commençons à l'utiliser pour prendre des décisions sur notre modèle. Par conséquent, il ne constitue plus une évaluation finale et impartiale. C'est comme si l'enseignant laissait les élèves jeter un coup d'œil aux questions de l'examen final pour décider de la meilleure méthode de révision !
C'est pourquoi, dans de nombreux projets, on introduit un troisième ensemble : l'ensemble de validation (validation set).
- Entraînement : Pour entraîner le modèle.
- Validation : Pour comparer les modèles et ajuster leurs hyperparamètres.
- Test : Pour l'évaluation finale et impartiale du modèle choisi.
La vidéo suivante explique ce concept de manière très intuitive. Nous explorerons cela plus en détail dans le module 9, mais il est bon d'en avoir une première idée dès maintenant.
Validation data: How it works and why you need it - Machine Learning Basics Explained
Cette vidéo utilise une excellente analogie avec un enseignant et des élèves pour expliquer le rôle de chaque division de données.
Regardez ces segments pour comprendre le rôle de chaque ensemble de données : Aperçu rapide des trois ensembles. L'analogie qui explique pourquoi le score d'entraînement ne suffit pas et pourquoi un ensemble de validation est nécessaire pour choisir le meilleur "étudiant" (modèle). Le récapitulatif final, qui résume clairement le but de chaque ensemble : les données d'entraînement pour apprendre les paramètres, les données de validation pour choisir les hyperparamètres (ou le modèle), et les données de test pour estimer la performance finale.
Conclusion
Dans cette leçon, vous avez appris l'une des étapes les plus fondamentales de la préparation des données en apprentissage automatique. La division des données est essentielle pour une évaluation honnête de vos modèles.
Points clés à retenir :
- On divise les données pour évaluer la capacité de généralisation d'un modèle sur des données qu'il n'a jamais vues.
- Le strict minimum est une division en ensemble d'entraînement (pour l'apprentissage du modèle) et ensemble de test (pour l'évaluation finale et impartiale).
- La fonction
train_test_splitde Scikit-learn est l'outil standard pour effectuer cette division en Python. - Les paramètres
test_size,random_stateetstratifysont cruciaux pour réaliser des divisions contrôlées, reproductibles et représentatives. - Pour des tâches plus complexes comme le choix du meilleur modèle ou l'ajustement de ses réglages, un troisième ensemble, l'ensemble de validation, est souvent utilisé.
Maintenant que nous savons comment évaluer correctement un modèle, nous pouvons commencer à diagnostiquer les problèmes courants. Dans la prochaine leçon, nous nous attaquerons directement aux concepts de surapprentissage (overfitting) et de sous-apprentissage (underfitting), et nous verrons comment la performance sur les ensembles d'entraînement et de test nous aide à identifier ces problèmes.