Bonjour ! Dans la leçon précédente, vous avez appris à créer des visualisations de données essentielles avec Matplotlib, transformant des tables de chiffres en graphiques révélateurs. Cette compétence marque la fin de notre module sur la préparation des données. Vous êtes maintenant prêt à franchir une étape décisive et à entrer dans le domaine qui est au cœur de votre objectif d'apprentissage : l'apprentissage automatique (Machine Learning, ou ML).
Cette leçon pose les fondations de ce nouveau module passionnant. L'objectif est de définir ce qu'est l'apprentissage automatique et de comprendre les trois grandes familles d'algorithmes qui le composent : l'apprentissage supervisé, l'apprentissage non supervisé et l'apprentissage par renforcement. Ces concepts sont la clé pour comprendre comment les machines "apprennent" et pour choisir la bonne approche pour un problème donné.
1. Qu'est-ce que l'apprentissage automatique (Machine Learning) ?
Vous avez exprimé un grand intérêt pour les cours d'Andrew Ng, et il n'y a pas de meilleure façon de commencer qu'avec sa perspective. Dans sa célèbre conférence à Stanford, il partage non seulement sa vision de l'impact du ML, mais il donne aussi des définitions claires qui ont façonné le domaine.
Stanford CS229: Machine Learning Course, Lecture 1 - Andrew Ng (Autumn 2018)
Cette vidéo est la première conférence du cours de Machine Learning de l'université de Stanford, enseigné par Andrew Ng. Elle constitue une excellente introduction au domaine.
Pour commencer, regardez l'introduction où Andrew Ng discute de l'impact de l'IA et du ML. Ensuite, portez une attention particulière à la section où il donne deux définitions classiques du Machine Learning, notamment celles d'Arthur Samuel et de Tom Mitchell.
Pour résumer et formaliser ces idées, l'apprentissage automatique est une branche de l'intelligence artificielle (IA) qui se concentre sur la création de systèmes capables d'apprendre à partir de données, d'identifier des motifs (patterns) et de prendre des décisions avec une intervention humaine minimale.
La différence fondamentale avec la programmation traditionnelle est la suivante :
- Programmation traditionnelle : Vous écrivez des règles explicites (logique
if-then-else) pour que l'ordinateur traite des données et produise un résultat.Données + Règles -> Résultats. - Apprentissage automatique : Vous fournissez à l'ordinateur des données et les résultats attendus, et il découvre les règles par lui-même.
Données + Résultats -> Règles.
Le "modèle" est le nom que nous donnons à cet ensemble de règles apprises par la machine. Une fois entraîné, le modèle peut faire des prédictions sur de nouvelles données qu'il n'a jamais vues.
Pour une définition formelle et bien structurée, l'article suivant de Google est une excellente ressource.
Cet article de Google offre une définition claire et concise de l'apprentissage automatique, en le contrastant avec l'approche traditionnelle.
Lisez l'introduction sous le titre "What is Machine Learning?". L'exemple de la prédiction de la pluie illustre parfaitement la différence entre une approche basée sur la physique (règles explicites) et une approche ML (apprentissage à partir des données).
2. Les trois grands types d'apprentissage automatique
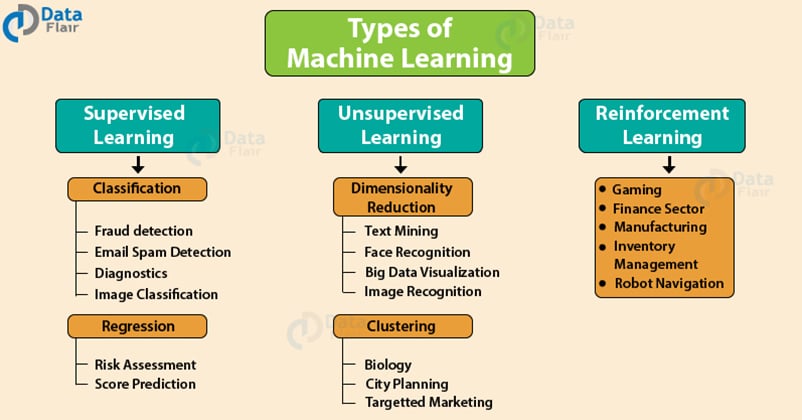
Les algorithmes de ML sont généralement classés en trois catégories principales, en fonction de la manière dont ils apprennent. Le diagramme ci-dessous illustre ces trois types et quelques-unes de leurs applications courantes.
Une autre façon de visualiser la différence est d'examiner le type d'entrée (input), le processus d'apprentissage et la sortie (output) de chaque approche, comme le montre le diagramme suivant.

Explorons maintenant chaque type en détail. La vidéo suivante, de la chaîne Kalam Tech (en arabe), propose des analogies simples et efficaces pour comprendre ces trois concepts.
What is Machine Learning?! Supervised vs Unsupervised vs Reinforcement Learning - بالعربي
Cette vidéo en arabe explique les bases du Machine Learning et ses trois principaux types avec des analogies claires et simples.
Regardez les sections suivantes pour saisir l'idée principale de chaque concept : Définition du ML avec l'analogie d'un enfant apprenant à reconnaître les fruits. Apprentissage Supervisé, comparé à un élève qui apprend avec un professeur. Apprentissage Non Supervisé, comparé à quelqu'un qui découvre des animaux pour la première fois. Apprentissage par Renforcement, avec l'analogie d'une personne explorant un nouveau pays.
a) Apprentissage Supervisé (Supervised Learning)
C'est le type de ML le plus courant. Comme son nom l'indique, l'apprentissage se fait "sous supervision". Cela signifie que nous entraînons le modèle sur un ensemble de données où la "bonne réponse" est déjà connue. Chaque donnée d'entrée (X) est accompagnée d'une étiquette (label ou Y). Le but du modèle est d'apprendre la relation (la "mapping function") qui relie X à Y.
Andrew Ng l'explique brillamment à l'aide d'exemples sur un tableau blanc.
Stanford CS229: Machine Learning Course, Lecture 1 - Andrew Ng (Autumn 2018)
Dans cette partie de sa conférence, Andrew Ng utilise des exemples visuels pour introduire l'apprentissage supervisé et ses deux sous-catégories principales.
Regardez attentivement la section qui commence à l'explication de l'apprentissage supervisé. Il y distingue deux types de problèmes : La régression : prédire une valeur continue (comme le prix d'une maison). La classification : prédire une catégorie discrète (comme le caractère malin ou bénin d'une tumeur).
Analogie : C'est comme apprendre avec des fiches de révision. D'un côté, vous avez la question (l'image d'un chat, X), et de l'autre, la réponse (l'étiquette "chat", Y). Après avoir vu des milliers de fiches, vous devenez capable de reconnaître un chat sur une nouvelle image.
Pour une définition plus formelle, les ressources de Google et d'IBM sont très claires.
What Is Machine Learning (ML)? | IBM
Cet article d'IBM détaille les différents types de ML, en commençant par le plus courant, l'apprentissage supervisé.
Concentrez-vous sur la section Supervised learning. Elle définit clairement la régression et la classification, et introduit le concept crucial de données étiquetées ("labeled data") et de vérité terrain ("ground truth").
b) Apprentissage Non Supervisé (Unsupervised Learning)
Dans ce cas, nous donnons au modèle des données qui ne sont pas étiquetées (seulement des X, pas de Y). Le but n'est pas de prédire une sortie spécifique, mais de découvrir des structures, des motifs ou des groupes cachés dans les données.
Analogie : Imaginez recevoir une boîte pleine de chaussettes de toutes les couleurs et de toutes les tailles, sans aucune instruction. Votre tâche serait de les trier en piles homogènes (par exemple, toutes les chaussettes bleues ensemble, toutes les chaussettes de sport ensemble). Vous ne savez pas comment nommer ces piles au départ, mais vous identifiez des groupes basés sur des similarités.
Les deux tâches les plus courantes en apprentissage non supervisé sont :
- Clustering (Regroupement) : Grouper des données similaires, comme dans l'exemple des chaussettes. Un exemple concret est la segmentation de clients en différents groupes pour du marketing ciblé.
- Association : Découvrir des règles qui décrivent de grandes portions de vos données, comme "les clients qui achètent du pain achètent aussi souvent du lait".
Stanford CS229: Machine Learning Course, Lecture 1 - Andrew Ng (Autumn 2018)
Andrew Ng explique ici le concept d'apprentissage non supervisé en le contrastant avec l'approche supervisée.
Regardez la section sur l'apprentissage non supervisé. Il donne d'excellents exemples comme le regroupement d'articles par Google News ou le problème du "cocktail party" (séparer plusieurs voix d'un seul enregistrement).
What Is Machine Learning (ML)? | IBM
La section sur l'apprentissage non supervisé de l'article d'IBM explique bien son objectif.
Lisez la section Unsupervised learning pour comprendre les fonctions principales comme le clustering, l'association et la réduction de dimensionnalité.
c) Apprentissage par Renforcement (Reinforcement Learning)
Ce type d'apprentissage est inspiré de la psychologie comportementale. Il s'agit d'entraîner un "agent" (le modèle) à prendre des décisions dans un "environnement" pour maximiser une "récompense". L'agent apprend par essais et erreurs.
Analogie : C'est comme dresser un chien. Quand le chien effectue une bonne action (s'asseoir sur commande), vous lui donnez une récompense (une friandise). Quand il fait une mauvaise action, il ne reçoit rien ou est réprimandé (une "pénalité"). Avec le temps, le chien apprend la "politique" (la stratégie) qui maximise ses récompenses.
Les composants clés sont :
- L'agent : Le modèle qui apprend.
- L'environnement : Le monde avec lequel l'agent interagit.
- L'action : Ce que l'agent peut faire.
- La récompense : Le feedback de l'environnement, qui peut être positif ou négatif.
Cette méthode est très utilisée en robotique (apprendre à un robot à marcher), dans les jeux (comme AlphaGo qui a battu le meilleur joueur de Go au monde) et pour l'optimisation de systèmes.
Stanford CS229: Machine Learning Course, Lecture 1 - Andrew Ng (Autumn 2018)
La dernière partie de l'introduction d'Andrew Ng porte sur l'apprentissage par renforcement, avec des exemples très visuels.
Regardez la section sur l'apprentissage par renforcement. L'analogie du dressage de chien et les vidéos de l'hélicoptère autonome et du robot-chien sont très parlantes.
Cet article fournit une définition concise de l'apprentissage par renforcement.
Lisez la courte section Reinforcement learning pour consolider votre compréhension du concept d'apprentissage par récompenses et pénalités.
Conclusion
Vous avez aujourd'hui posé la première pierre de votre parcours en apprentissage automatique. Vous avez exploré la définition fondamentale du ML et, plus important encore, vous avez appris à distinguer ses trois principaux paradigmes.
Points clés à retenir :
- Apprentissage Automatique (ML) : C'est l'art de programmer les ordinateurs pour qu'ils apprennent à partir de données, sans être explicitement programmés pour chaque tâche.
- Apprentissage Supervisé : Le modèle apprend à partir de données étiquetées (
XetY). Il est idéal pour les tâches de régression (prédire une valeur continue) et de classification (prédire une catégorie). - Apprentissage Non Supervisé : Le modèle trouve des structures cachées dans des données non étiquetées (seulement
X). Le clustering est l'application la plus connue. - Apprentissage par Renforcement : Un agent apprend par essais et erreurs en interagissant avec un environnement pour maximiser une récompense.
Maintenant que vous comprenez cette taxonomie, vous êtes prêt à explorer chaque branche plus en profondeur. Dans la prochaine leçon, nous reviendrons à l'apprentissage supervisé, le type le plus utilisé en pratique, et nous nous concentrerons sur la distinction essentielle entre les tâches de régression et de classification.