Bonjour !
Dans la leçon précédente, nous avons vu comment construire des modèles de prédiction en utilisant des séries temporelles et des données alternatives, comme le sentiment des actualités. Nous avons même vu une étude de cas (a78b5) montrant que ces approches améliorent significativement la précision. Cela soulève une question fondamentale : si ces outils sont si puissants, pourquoi la prédiction des marchés reste-t-elle l'un des problèmes les plus difficiles en science des données ?
Aujourd'hui, nous allons répondre à cette question. L'objectif de cette leçon est d'analyser les défis de l'utilisation du Machine Learning (ML) pour la prédiction boursière, en particulier l'efficience des marchés et la non-stationnarité des données. Comprendre ces obstacles est essentiel, non seulement pour construire des modèles plus robustes, mais aussi pour enseigner à vos étudiants pourquoi la finance quantitative est un domaine si exigeant et fascinant.
1. Le premier obstacle : L'efficience du marché
Votre formation en économie vous a sans doute familiarisé avec l'Hypothèse d'Efficience des Marchés (EMH) d'Eugene Fama. Cette théorie postule que les prix des actifs financiers reflètent à tout moment toute l'information disponible. Si c'est vrai, il est théoriquement impossible de "battre le marché" de manière consistante.
Les modèles de Machine Learning, capables de détecter des motifs complexes et non linéaires, semblent défier cette hypothèse, en particulier ses formes faible et semi-forte. Comment concilier les deux ?
Pour approfondir cette interaction entre ML et théories économiques, je vous propose une lecture introductive.
How effectively can AI predict stock prices across different ...
Ce document de recherche, intitulé "How effectively can AI predict stock prices...", offre une excellente synthèse des théories économiques qui encadrent la prédiction par ML. Il positionne l'EMH comme une référence et introduit des concepts plus modernes.
Lisez les sections 4.1 "Efficient Market Hypothesis (EMH)" et 4.2 "The adaptive markets hypothesis (AMH)". Concentrez-vous sur la manière dont les modèles de ML peuvent exploiter les inefficacités décrites par la finance comportementale et comment l'AMH offre un cadre plus réaliste que l'EMH pour comprendre la performance variable des modèles de ML.
De l'efficience à l'adaptation : l'Hypothèse des Marchés Adaptatifs (AMH)
Comme vous l'avez lu, l'AMH d'Andrew Lo propose un terrain d'entente : l'efficience n'est pas un état binaire (vrai ou faux), mais un processus évolutif. Les marchés traversent des périodes d'efficience et d'inefficience, au gré de la compétition, de l'innovation et du comportement des investisseurs.
Cela explique pourquoi une stratégie de ML peut être très profitable pendant un certain temps, puis cesser de fonctionner :
- Le modèle découvre une inefficience (un "alpha").
- Il l'exploite, générant des profits.
- D'autres acteurs du marché (humains ou algorithmiques) découvrent à leur tour ce même schéma, soit indépendamment, soit en observant les flux de marché.
- Leur action collective pour exploiter cette inefficience la fait disparaître. Le prix s'ajuste pour intégrer cette information. L'alpha s'est évaporé.
C'est une véritable course aux armements technologique.
L'illusion de la prédictibilité : l'effet de l'apprentissage des investisseurs
Un défi encore plus subtil est que l'analyse historique des données peut être trompeuse. Des schémas qui semblent prédictifs avec le recul (in hindsight) n'étaient peut-être pas exploitables en temps réel, car les investisseurs étaient encore en train d'apprendre leur signification.
La vidéo suivante, issue d'une conférence académique, explique brillamment ce phénomène.
AI & Machine Learning in Finance: “Evaluating market efficiency in a high-dimensional world”
Dans cette présentation, "Evaluating market efficiency in a high-dimensional world", le chercheur explique comment le processus d'apprentissage collectif des investisseurs peut créer des motifs de rendement qui ressemblent à des inefficacités, mais qui n'en sont pas.
Regardez les extraits suivants pour saisir l'argument principal : 00:24 - 02:22 : Introduction au problème dans un monde "riche en données" (high-dimensional). 02:22 - 05:28 : Rappel des tests d'efficience classiques et du problème fondamental du "biais du recul". 05:28 - 09:07 : Le cœur de l'argument : comment l'apprentissage des investisseurs génère des motifs de prix qui semblent prédictifs, mais qui ne sont que l'artefact de cet apprentissage. 26:34 - 28:48 : Un excellent résumé qui conclut la présentation.
Ce point est crucial : une grande partie de ce qui ressemble à un signal prédictif dans les données historiques est en réalité le bruit de fond de l'apprentissage du marché. Les modèles de ML, sans précautions particulières, sont très doués pour modéliser ce bruit, ce qui mène à un surapprentissage (overfitting) et à de piètres performances en conditions réelles.
2. Le deuxième obstacle : La nature instable des données financières (Non-stationnarité)
Votre expérience en économétrie vous a rendu sensible au concept de stationnarité. Une série est stationnaire si ses propriétés statistiques (moyenne, variance, etc.) sont constantes dans le temps. Malheureusement, les séries financières sont un exemple canonique de non-stationnarité.
Les "règles du jeu" du marché changent constamment, sous l'effet de :
- Changements de régime (ex: passage d'un marché haussier à un marché baissier)
- Chocs macroéconomiques (ex: décisions des banques centrales, crises géopolitiques)
- Évolutions structurelles (ex: nouvelles régulations, innovations technologiques)
La vidéo suivante présente ces caractéristiques, connues sous le nom de "faits stylisés" des données financières.
Financial Engineering Playground: Signal Processing, Robust Estimation, Kalman, Optimization
Cette partie de la conférence "Financial Engineering Playground" introduit les défis statistiques fondamentaux des données financières.
Regardez l'extrait de 04:10 à 09:57. Il met en évidence trois faits stylisés majeurs : la non-stationnarité, les "queues de distribution épaisses" (heavy tails), qui signifient que les événements extrêmes sont plus fréquents que dans une loi normale, et le regroupement de la volatilité (volatility clustering).
Data Drift vs. Concept Drift
Cette non-stationnarité se manifeste de deux manières principales en ML, qui sont cruciales à distinguer :
- Data Drift (ou Virtual Drift) : La distribution des données d'entrée
p(x)change, mais la relation entre les entrées et la sortiep(y|x)reste la même.- Exemple financier : Le volume moyen des transactions sur une action augmente considérablement, mais la façon dont le volume influence le rendement futur reste inchangée.
- Concept Drift (ou Real Drift) : La relation fondamentale entre les entrées et la sortie
p(y|x)change. C'est le défi le plus redoutable.- Exemple financier : Avant 2022, une forte inflation était positive pour les actions. Après 2022 et le cycle de resserrement monétaire, une forte inflation est devenue un signal très négatif. La "règle" a changé.
Les images suivantes illustrent parfaitement cette distinction.

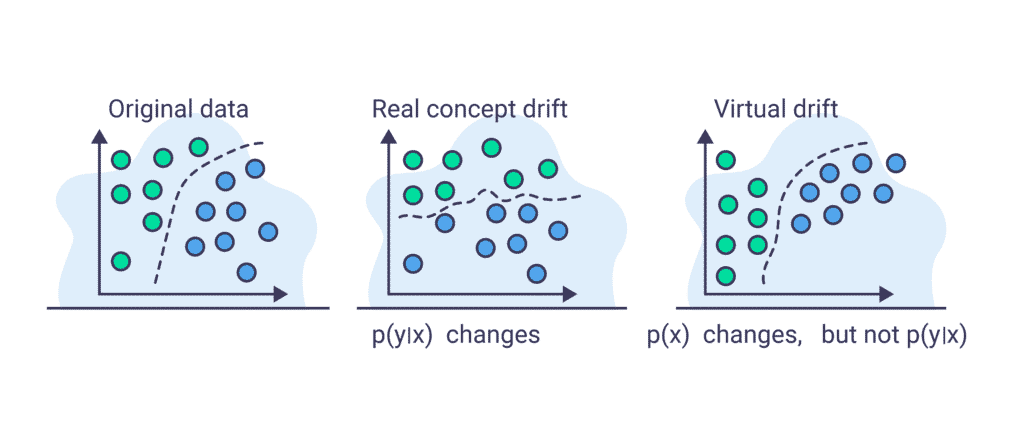
Un modèle de ML entraîné sur des données historiques suppose implicitement que le "concept" qu'il a appris est stable. Lorsque le concept dérive, le modèle devient obsolète et ses prédictions erronées.
Testez votre compréhension !
Imaginez qu'un analyste a développé une stratégie de trading basée sur le ML qui a généré d'excellents rendements sur les données de 2015 à 2019. Lorsqu'elle est déployée en conditions réelles en 2020, la stratégie subit des pertes importantes.
En vous appuyant sur les concepts de cette leçon, proposez deux explications distinctes à cet échec.
Voir la réponse
- Explication via l'efficience du marché (Hypothèse des Marchés Adaptatifs) : Le modèle avait identifié une réelle inefficience de marché présente entre 2015 et 2019. Cependant, au fil du temps, d'autres acteurs du marché ont également découvert et exploité cette même inefficience, ce qui l'a fait disparaître. En 2020, le "alpha" n'existait plus, rendant la stratégie obsolète.
- Explication via la non-stationnarité (Concept Drift) : L'année 2020 a été marquée par la pandémie de COVID-19, un choc systémique majeur. Cet événement a provoqué un changement de régime de marché, modifiant fondamentalement les relations entre les indicateurs économiques, le sentiment du marché et les rendements des actions. Le "concept" que le modèle avait appris sur les données de 2015-2019 n'était plus valide dans le nouvel environnement de 2020.
Gérer les défis en pratique
Face à ces problèmes, les praticiens ont développé un ensemble de techniques pour rendre leurs modèles plus robustes. Le document suivant offre un excellent aperçu de ces "pièges" et des solutions pour les éviter.
Avoiding the Pitfalls on Stock Market: Challenges and ...
L'article "Avoiding the Pitfalls on Stock Market..." est un guide pratique qui recense les principaux défis rencontrés lors du développement d'une stratégie quantitative, de la préparation des données à l'évaluation.
Parcourez cet article court et bien structuré. Concentrez-vous sur les sections qui détaillent les défis (Featurization, Modeling, Evaluation). Notez en particulier les points sur la non-stationnarité (4.1.2), la stochasticité (5.1) et le surapprentissage (6.2, backtest overfitting). Cet article est une excellente ressource à garder pour structurer votre propre cours.
Pour gérer la non-stationnarité, les approches avancées incluent des modèles capables de s'adapter dynamiquement. Par exemple, les filtres de Kalman, que vous connaissez peut-être de l'ingénierie ou de l'économétrie, sont utilisés pour modéliser des paramètres qui varient dans le temps (comme une relation de cointégration entre deux actifs qui évolue). C'est une illustration parfaite de la convergence entre l'économétrie et le ML en finance.
Conclusion
Nous avons confronté l'optimisme technologique de la leçon précédente à la dure réalité des marchés financiers. La prédiction boursière avec le ML n'est pas simplement une question d'appliquer un algorithme puissant à des données ; c'est une lutte constante contre des forces fondamentales.
Points clés à retenir :
- La prédiction par ML est une course aux armements contre l'efficience du marché. Selon l'Hypothèse des Marchés Adaptatifs, les opportunités de profit sont souvent temporaires.
- L'analyse de données historiques est biaisée par l'effet d'apprentissage des investisseurs, qui peut créer des motifs prédictifs illusoires et conduire au surapprentissage.
- Les données financières sont intrinsèquement non-stationnaires. Les modèles de ML doivent être conçus pour s'adapter aux changements de régime et au Concept Drift, sous peine de devenir rapidement obsolètes.
Dans la leçon précédente, nous avons vu comment prédire. Aujourd'hui, nous avons vu pourquoi c'est si difficile. Forts de cette perspective, nous pouvons maintenant explorer d'autres applications de l'IA en finance qui ne reposent pas nécessairement sur la prédiction active et à court terme.
Dans la prochaine leçon, nous nous pencherons sur les robo-advisors. Nous verrons comment ils utilisent la technologie non pas pour battre le marché, mais pour automatiser et optimiser la gestion de portefeuille à long terme pour les investisseurs individuels.