Bonjour !
Dans la leçon précédente, nous avons disséqué les systèmes de trading algorithmique, en identifiant leurs composants et leurs principales stratégies. Nous avons conclu que le "cerveau" de ces systèmes est le composant de génération de signaux, qui s'appuie sur des modèles prédictifs.
Aujourd'hui, nous allons nous concentrer sur la manière de nourrir ce cerveau. L'objectif est de décrire comment les séries temporelles et les données alternatives (par exemple, le sentiment des actualités) sont utilisées dans les modèles de Machine Learning pour la prédiction des marchés. Cette compétence est au cœur de la finance quantitative moderne. Nous verrons comment transformer des données brutes, qu'il s'agisse de l'historique des prix ou d'articles de presse, en signaux exploitables par un algorithme.
1. Utiliser les données de séries temporelles avec le Machine Learning
Votre formation en économétrie vous a familiarisé avec les modèles de séries temporelles classiques comme ARIMA, qui excellent à prévoir une série en se basant sur ses propres dynamiques passées (auto-corrélation, saisonnalité). L'approche du Machine Learning est conceptuellement différente : elle cherche à transformer le problème de prévision en un problème de régression supervisée standard.
L'idée est de créer une "photographie" de l'état du marché à un instant t en utilisant des données du passé, et d'utiliser cette photographie (les caractéristiques, ou features) pour prédire l'état futur du marché à t+1 (la cible, ou target).
La vidéo suivante explique très bien cette transformation fondamentale.
Feature Engineering for Time Series Forecasting - Kishan Manani
Cette vidéo, intitulée "Feature Engineering for Time Series Forecasting", est une excellente introduction à l'approche du Machine Learning pour les séries temporelles. Elle montre comment transformer une série chronologique en un tableau de données classique que des modèles comme Random Forest ou Gradient Boosting peuvent utiliser.
Regardez l'extrait de 08:45 à 12:31. Il explique comment créer la variable cible (ce que l'on veut prédire) et les variables explicatives (les caractéristiques) à partir de l'historique d'une série temporelle, en insistant sur la nécessité d'éviter le "look-ahead bias" (biais de connaissance du futur).
Les types de caractéristiques (Features) créées à partir des séries temporelles
Pour construire notre "photographie" du marché, nous extrayons plusieurs types d'informations de l'historique des prix. Ce processus s'appelle l'ingénierie des caractéristiques (feature engineering). Voici les plus courants :

- Caractéristiques de décalage (Lag Features) : Ce sont simplement les valeurs passées de la série. Par exemple, pour prédire le prix de demain, on peut utiliser comme caractéristiques les prix d'aujourd'hui, d'hier, d'avant-hier, etc. C'est l'analogue des termes autorégressifs (AR) dans un modèle ARIMA.
- Caractéristiques de fenêtre glissante (Window Features) : Au lieu d'utiliser les valeurs brutes, on calcule des statistiques sur une période récente (une "fenêtre"). Par exemple, la moyenne mobile des prix sur 7 jours, l'écart-type sur 30 jours (qui est une mesure de la volatilité), le prix maximum des 5 dernières heures, etc. Cela permet de capturer les tendances et la volatilité récentes.
- Caractéristiques temporelles (Date/Time Features) : On peut aussi extraire des informations de la date elle-même : le jour de la semaine (les lundis ont-ils un comportement différent ?), le mois, le trimestre, l'heure de la journée, etc. Ces caractéristiques aident le modèle à capturer des effets de saisonnalité.
La validation croisée pour les séries temporelles
Un point crucial, qui différencie radicalement l'analyse des séries temporelles de celle des données tabulaires classiques, est la validation des modèles. On ne peut jamais mélanger les données de manière aléatoire pour créer des ensembles d'entraînement et de test. Cela reviendrait à utiliser le futur pour prédire le passé, ce qui conduirait à une évaluation trop optimiste et irréaliste des performances du modèle.
La validation doit respecter l'ordre chronologique. La méthode standard est la validation croisée à fenêtre glissante (rolling-window cross-validation).
La vidéo que vous avez commencée explique très bien ce point.
Feature Engineering for Time Series Forecasting - Kishan Manani
La section suivante de la vidéo "Feature Engineering for Time Series Forecasting" aborde une erreur commune mais fondamentale à éviter : la validation croisée incorrecte pour les données temporelles.
Regardez l'extrait de 17:57 à 19:34. Il illustre pourquoi un train_test_split aléatoire est invalide et comment la validation croisée temporelle fonctionne en déplaçant une fenêtre dans le temps.
2. Intégrer les données alternatives : le sentiment des actualités
Les marchés financiers ne sont pas uniquement le reflet de leurs prix passés. Ils sont profondément influencés par les événements, les nouvelles économiques, les annonces politiques et la psychologie collective. Les données qui capturent ces informations sont appelées données alternatives. Le sentiment extrait des articles de presse en est un exemple phare.
L'idée est de quantifier l'opinion du marché pour l'utiliser comme une caractéristique supplémentaire dans nos modèles. Le processus général est le suivant :
- Collecte de données : Récupérer en temps réel des articles de presse, des dépêches, des tweets, etc., concernant un actif ou le marché en général.
- Analyse de sentiment : Utiliser un modèle de traitement du langage naturel (NLP) pour analyser chaque texte et lui attribuer un score de sentiment (par exemple, de -1 pour très négatif à +1 pour très positif).
- Agrégation : Calculer un score de sentiment agrégé sur une période donnée (par exemple, la moyenne des scores de toutes les nouvelles de la dernière heure).
- Intégration : Utiliser ce score de sentiment comme une nouvelle caractéristique (
feature) dans le modèle de prédiction, aux côtés deslag featuresetwindow featuresvues précédemment.
La vidéo suivante est une démonstration pratique de ce processus.
I Built an AI Bot That Reads Market News and Predicts Sentiment Instantly [Free Python Script]
Cette vidéo, "I Built an AI Bot That Reads Market News...", montre concrètement comment construire un système qui analyse le sentiment des nouvelles financières en temps réel.
Regardez ces deux extraits pour saisir l'idée et voir le résultat : L'introduction (00:00 à 01:47) explique le concept et la motivation : pourquoi quantifier le sentiment des nouvelles ? La démonstration finale (07:05 à 08:27) montre le script en action et le résultat final : un résumé du sentiment du marché (positif, négatif, neutre) basé sur 70 articles.
Testez votre compréhension !
Imaginez que vous construisez un modèle pour prédire le prix de l'action TotalEnergies pour le lendemain. Vous disposez de l'historique des prix de clôture sur 10 ans et d'un flux d'articles de presse.
Comment pourriez-vous créer trois caractéristiques pertinentes (une de chaque type vu jusqu'à présent) pour alimenter votre modèle ?
Voir la réponse
- Caractéristique de décalage (Lag Feature) : Le prix de clôture de l'action TotalEnergies d'aujourd'hui. C'est souvent l'une des informations les plus prédictives pour le prix de demain.
- Caractéristique de fenêtre glissante (Window Feature) : La moyenne mobile sur 20 jours du volume de transactions. Cela donne une idée de l'intérêt récent du marché pour l'action, par rapport à la normale.
- Caractéristique de donnée alternative (Alternative Data Feature) : Le score de sentiment moyen de tous les articles de presse mentionnant "pétrole" ou "OPEP" publiés aujourd'hui. Un sentiment très négatif pourrait indiquer une baisse attendue des prix.
3. La synthèse : Combiner les données pour de meilleures prédictions
La véritable puissance de l'approche Machine Learning réside dans sa capacité à intégrer de manière transparente ces sources de données hétérogènes. Un article de recherche académique peut nous aider à formaliser cette approche.
L'étude suivante a justement testé cette hypothèse : l'ajout du sentiment des nouvelles et d'indicateurs techniques (qui sont une forme de window features) améliore-t-il la prédiction des prix des actions ?
Stock Market Prediction Using Financial News Sentiments and ...
Cet article, "Stock Market Prediction Using Financial News Sentiments and Technical Indicator Data...", formalise l'approche que nous venons de décrire. Il compare rigoureusement la performance de modèles entraînés sur différentes combinaisons de données.
Je vous invite à parcourir ces sections clés : Data Understanding (4.3) et Data Preparation (4.4) : Lisez comment les auteurs ont collecté et fusionné les trois types de données (historique des prix, sentiment des nouvelles, indicateurs techniques). Model Performance Analysis (7.4) : Regardez attentivement le Tableau 1. Il compare l'erreur des modèles (MSE, MAE) sur trois jeux de données. Notez la différence de performance spectaculaire entre un modèle utilisant uniquement les données de prix ("Stock Data") et ceux qui intègrent le sentiment et les indicateurs techniques.
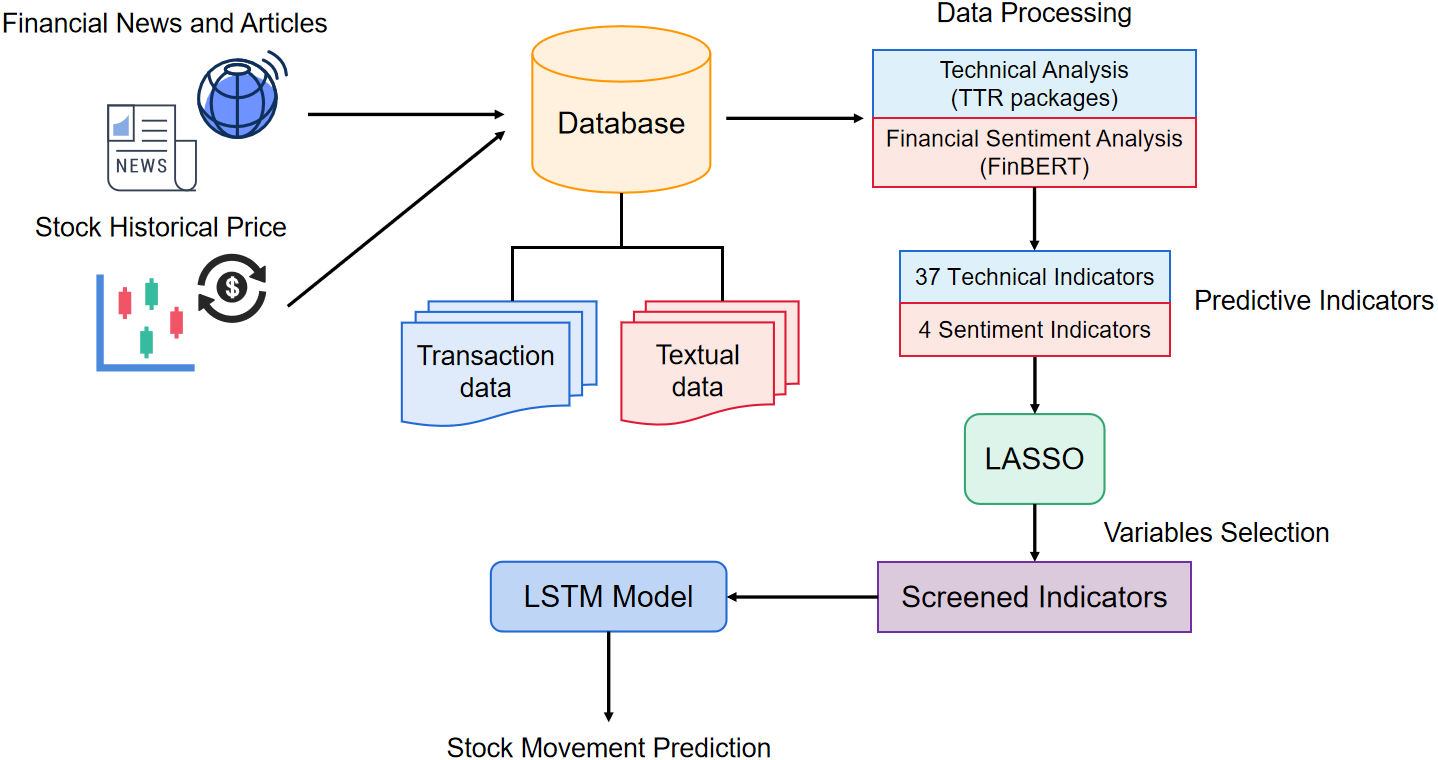
Le résultat de cette étude est sans appel : les modèles qui combinent les prix historiques, le sentiment des nouvelles et les indicateurs techniques sont nettement plus performants que ceux basés uniquement sur les prix. L'erreur de prédiction (MSE) pour le modèle RandomForest, par exemple, chute de 398 à 1.1 en ajoutant le sentiment. C'est la preuve quantitative de la valeur ajoutée de ces données.
Le diagramme suivant résume parfaitement ce flux de travail intégré :
Enfin, il est intéressant de noter que cette approche n'est pas confinée à la prédiction des marchés financiers. Votre formation en économie trouvera un écho dans le fait que les banques centrales utilisent des techniques similaires pour la prévision macroéconomique. Le document de la Banque Centrale de Malaisie "Using news sentiment for economic forecasting" (LINK) montre par exemple que le sentiment des nouvelles est un bon prédicteur de l'investissement privé.
Conclusion
Aujourd'hui, nous avons ouvert la "boîte noire" de la génération de signaux en trading algorithmique. Nous avons vu comment des données apparemment brutes et non structurées peuvent être transformées en caractéristiques puissantes pour les modèles de Machine Learning.
Points clés à retenir :
- L'approche ML pour les séries temporelles consiste à transformer le problème en une tâche de régression supervisée via l'ingénierie de caractéristiques (lags, fenêtres glissantes, etc.).
- La validation des modèles temporels doit impérativement respecter la chronologie pour éviter le biais de connaissance du futur.
- Les données alternatives, comme le sentiment extrait des articles de presse, apportent une information complémentaire cruciale qui n'est pas contenue dans les prix passés.
- La combinaison de séries temporelles, d'indicateurs techniques et de données de sentiment permet d'améliorer significativement la performance des modèles de prédiction.
Dans la prochaine leçon, nous aborderons une question fondamentale : si ces techniques sont si puissantes, pourquoi la prédiction des marchés reste-t-elle si difficile ? Nous discuterons des grands défis que sont l'efficience des marchés et la non-stationnarité des données financières, qui rendent ce domaine à la fois fascinant et extrêmement compétitif.