Bonjour et bienvenue dans cette nouvelle leçon !
Introduction
Dans la leçon précédente, nous avons vu comment le Big Data transforme la conformité réglementaire, permettant aux institutions financières de passer d'un reporting manuel et fastidieux à un écosystème automatisé, souvent appelé RegTech. Nous avons vu que l'un des bénéfices était la surveillance pour des activités comme le blanchiment d'argent.
Aujourd'hui, nous allons approfondir cette idée de surveillance en nous concentrant sur l'une des caractéristiques les plus puissantes du Big Data : la Vélocité. L'objectif de cette leçon est de vous faire comprendre comment l'analyse en temps réel est utilisée pour deux fonctions critiques : la détection de fraude et la surveillance des marchés. Nous verrons comment les institutions financières et les régulateurs exploitent la vitesse pour passer d'une analyse a posteriori à une intervention quasi instantanée, protégeant ainsi les clients et l'intégrité du système financier.
1. Les Fondations de l'Analyse en Temps Réel
Avant de plonger dans les cas d'usage, il est important de comprendre les mécanismes technologiques qui rendent possible l'analyse en temps réel. Il ne s'agit plus d'analyser un lot de données stockées, mais bien un flux continu de données en mouvement.
Le document de recherche suivant introduit les concepts clés qui sous-tendent ces systèmes.
The role of big data in detecting and preventing financial ...
Pour commencer, ce document académique pose les bases conceptuelles de la détection de fraude en temps réel. Il explique comment des technologies spécifiques permettent d'analyser les données "à la volée".
Lisez la section 1.4, intitulée "Real-Time Fraud Detection Mechanisms". Concentrez-vous sur la compréhension des concepts suivants : Streaming data processing (traitement de données en flux) et Complex Event Processing (CEP) : Qu'est-ce que ces technologies permettent de faire ? Les trois actions clés que ces systèmes réalisent : surveiller (monitoring), signaler (flagging), et atténuer (mitigating).
En résumé, les systèmes en temps réel ingèrent des flux de données continus (comme des transactions par carte de crédit), y appliquent des règles ou des modèles pour identifier des événements complexes (ex: une séquence d'actions suspectes), et déclenchent des actions immédiates. Voyons comment cela s'applique à la détection de fraude.
2. Application n°1 : La Détection de Fraude en Temps Réel
Lorsqu'une transaction par carte de crédit est effectuée en ligne ou en magasin, la banque dispose de moins d'une seconde pour prendre une décision : autoriser ou refuser. C'est un défi immense qui combine vitesse et précision.
L'approche traditionnelle reposait sur des règles statiques (par exemple, bloquer une transaction supérieure à 5 000 € provenant d'un pays inhabituel). Ces systèmes étaient rapides mais rigides, générant de nombreux "faux positifs" (blocage de transactions légitimes) et étant incapables de détecter de nouvelles formes de fraude.
L'approche moderne utilise le Machine Learning pour analyser des dizaines, voire des centaines de variables en quelques millisecondes. Cependant, même ici, il existe un compromis entre la complexité (et donc la précision) du modèle et sa vitesse d'exécution.
La vidéo suivante illustre une solution de pointe qui résout ce dilemme en utilisant un ensemble de modèles.
Fraud Detection with AI: Ensemble of AI Models Improve Precision & Speed
Cette vidéo d'IBM Technology illustre une approche de pointe pour la détection de fraude. Elle montre comment combiner différents types de modèles d'IA pour améliorer à la fois la vitesse et la précision.
Regardez les sections suivantes : 00:00-01:32 : Comprenez le défi (moins de 200 ms) et le rôle des modèles de Machine Learning traditionnels (régression logistique, arbres de décision, etc.) qui analysent les données structurées. 01:32-02:12 : Saisissez les limites de ces modèles traditionnels, notamment face à des fraudes nouvelles ou des données non structurées. 05:55-08:44 : Cette partie est cruciale. Elle détaille le flux de travail d'un système à plusieurs modèles : un premier modèle rapide filtre la grande majorité des cas, et un second modèle plus complexe (et plus lent) n'analyse que les cas ambigus. C'est une excellente illustration de l'optimisation.
Votre expertise en modèles économétriques comme la régression logistique vous est ici très utile. Le principe est le même : prédire une issue binaire (fraude/non-fraude). La différence réside dans l'échelle (des millions de transactions), la vitesse d'exécution et, comme le montre la vidéo, l'architecture intelligente qui combine des modèles rapides et simples avec des modèles plus lents et complexes pour optimiser le processus.
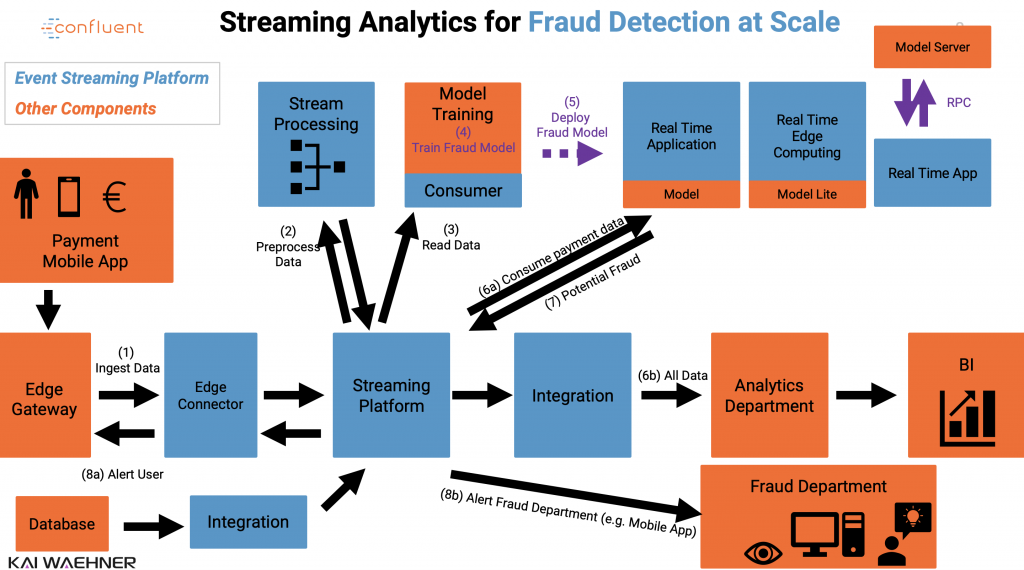
L'architecture technique d'un tel système peut être visualisée comme suit :
3. Application n°2 : La Surveillance des Marchés Financiers
Le même principe d'analyse de flux de données en temps réel est utilisé par les régulateurs et les services de conformité des grandes banques pour garantir l'intégrité des marchés. L'objectif est de détecter des comportements anormaux ou illégaux comme les délits d'initiés, la manipulation de cours (ex: "spoofing") ou les "wash trades".
Ici, les volumes de données sont encore plus astronomiques : chaque ordre passé, modifié ou annulé, et chaque transaction sur des milliers d'instruments financiers génère des données.
L'article suivant décrit comment un régulateur majeur, la Securities and Exchange Commission (SEC) américaine, a mis en place un arsenal d'outils Big Data pour "chasser" les fraudeurs.
Big Data Is Watching You: How the SEC Uses Advanced ...
Pour la surveillance des marchés, les régulateurs comme la SEC américaine ont développé des outils de Big Data très puissants. Cet article décrit comment ces systèmes fonctionnent.
Lisez les trois sections suivantes : "The SEC's Analytical Revolution: ARTEMIS and Beyond" : Comprenez le rôle d'ARTEMIS, qui croise les données de trading avec des chronologies d'événements d'entreprise (annonces de fusion, résultats, etc.) pour détecter des délits d'initiés. "The Market Abuse Unit: A Specialized Force" : Notez comment cette unité spécialisée utilise les outils analytiques pour générer des pistes d'enquête. "The Principles Behind SEC Data Analytics" : Saisissez le principe fondamental : des schémas de trading inhabituels ('unusual trading patterns') constituent un début de preuve. Cela relie l'analyse statistique à la preuve juridique.
Le point fondamental, qui devrait particulièrement résonner avec votre formation quantitative, est que la surveillance de marché repose sur l'analyse statistique d'anomalies. Le système ARTEMIS, par exemple, ne fait rien d'autre que de rechercher des corrélations statistiquement improbables : un trader qui réalise soudainement des gains exceptionnels sur une action juste avant l'annonce d'une nouvelle inattendue et positive pour cette même action.
Comme l'illustre l'article avec l'affaire SEC v. Welhouse, les analystes peuvent quantifier la probabilité qu'un certain schéma de trading soit dû au hasard. Lorsqu'elle est de l'ordre de "une sur mille milliards", elle devient une preuve convaincante devant un tribunal.
Testez votre compréhension !
Une Fintech propose une nouvelle application de paiement mobile. Pour attirer les clients, elle promet des transactions "instantanées". En vous basant sur les concepts vus dans cette leçon, quel est le principal compromis (trade-off) que cette entreprise doit gérer dans la conception de son système de détection de fraude en temps réel ? Comment l'approche "multi-modèles" (vue dans la vidéo IBM) aide-t-elle à résoudre ce compromis ?
Voir la réponse
Le principal compromis est celui entre la vitesse de la transaction et la précision de la détection de fraude.
- Pour garantir une transaction instantanée, le modèle de détection doit être extrêmement rapide (quelques millisecondes). Des modèles plus simples et plus rapides risquent de manquer des fraudes complexes ou de générer plus de "faux positifs" (bloquer des transactions légitimes), frustrant ainsi les utilisateurs.
- Pour une détection très précise, des modèles plus complexes (comme les LLM mentionnés dans la vidéo) sont nécessaires. Ils peuvent analyser plus de contexte, mais ils sont plus lents et plus coûteux en termes de calcul. Les utiliser pour chaque transaction ralentirait tout le système et contredirait la promesse de transactions "instantanées".
L'approche multi-modèles résout ce compromis de manière élégante :
- Un premier modèle, très rapide et léger, analyse 100% des transactions. Il approuve immédiatement les transactions clairement légitimes et bloque celles qui sont manifestement frauduleuses.
- Seul un petit pourcentage de transactions ambiguës ou à risque modéré est transmis à un second modèle, plus lent et plus puissant, pour une analyse approfondie.
- Cette architecture permet de maintenir une vitesse globale élevée pour la plupart des utilisateurs, tout en appliquant une analyse fine uniquement là où c'est nécessaire, optimisant ainsi à la fois l'expérience client et la sécurité.
Conclusion
L'analyse en temps réel, propulsée par les technologies Big Data, est une capacité essentielle de la finance moderne. Elle permet une protection proactive contre la fraude et assure la surveillance continue de l'intégrité des marchés.
Voici les points clés à retenir :
- L'analyse en temps réel s'appuie sur des technologies de traitement de données en flux (streaming) pour analyser les données en mouvement.
- Dans la détection de fraude, l'enjeu est de prendre une décision (autoriser/bloquer) en millisecondes, en trouvant le juste équilibre entre vitesse et précision. Des architectures à plusieurs modèles permettent d'optimiser ce compromis.
- Dans la surveillance des marchés, les régulateurs et les institutions analysent des volumes massifs de données de trading pour détecter des schémas statistiquement anormaux qui pourraient indiquer une manipulation ou un délit d'initié.
Nous avons maintenant exploré plusieurs applications concrètes du Big Data en finance : l'évaluation du risque, la personnalisation, la conformité réglementaire, et aujourd'hui la détection de fraude. Dans la prochaine leçon, nous passerons des "cas d'usage" aux "outils". Nous présenterons les plateformes Big Data les plus courantes, comme Hadoop et Spark, qui constituent l'infrastructure sur laquelle toutes ces applications sont construites.