Bonjour et bienvenue dans cette nouvelle leçon !
Introduction
Au cours des leçons précédentes, nous avons exploré plusieurs applications concrètes du Big Data en finance : l'évaluation du risque de crédit, la personnalisation des services, la conformité réglementaire (RegTech) et, plus récemment, la détection de fraude en temps réel. Nous avons vu ce que ces technologies permettent de faire.
Aujourd'hui, nous allons nous intéresser au comment. L'objectif de cette leçon est d'identifier les plateformes technologiques qui constituent l'infrastructure sous-jacente à toutes ces applications. Nous nous concentrerons sur les deux écosystèmes les plus importants du monde du Big Data : Apache Hadoop et Apache Spark. Comprendre leurs fonctions respectives est essentiel pour saisir comment les institutions financières peuvent gérer et analyser des volumes de données sans précédent.
Cette leçon conclut notre module sur les applications du Big Data et prépare le terrain pour le module suivant, où nous aborderons le Machine Learning, une discipline qui s'appuie massivement sur ces plateformes.
1. La fondation du Big Data : Apache Hadoop
Imaginez que vous deviez analyser un fichier de plusieurs pétaoctets (des millions de gigaoctets) sur un seul ordinateur. Ce serait non seulement extrêmement lent, mais aussi impossible, car le fichier ne tiendrait pas sur le disque dur. Apache Hadoop a été créé pour résoudre ce problème fondamental.
Hadoop est un framework open-source qui permet le stockage distribué et le traitement distribué de très grands ensembles de données sur des clusters d'ordinateurs standards ("commodity hardware"), ce qui le rend très rentable.
Pour bien comprendre Hadoop, regardez la vidéo suivante qui en présente les concepts et les composants principaux.
Cette vidéo d'IBM Technology offre une excellente introduction à Apache Hadoop. Elle explique pourquoi il est nécessaire et décompose son architecture en modules fonctionnels.
Regardez les premières 4 minutes et 30 secondes de la vidéo (00:00 - 04:30). Concentrez-vous sur la compréhension des rôles des composants suivants : HDFS (Hadoop Distributed File System) : Comment assure-t-il le stockage et la tolérance aux pannes ? YARN (Yet Another Resource Negotiator) : Quel est son rôle dans la gestion du cluster ? MapReduce : Quel est le principe de ce modèle de programmation pour le traitement parallèle ?
Les composants clés de l'écosystème Hadoop
Comme vous l'avez vu, Hadoop n'est pas un seul outil mais un écosystème. Résumons ses piliers :
-
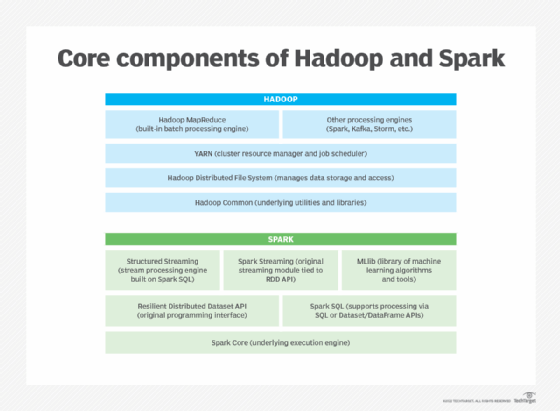
HDFS (Hadoop Distributed File System) : C'est la couche de stockage. HDFS découpe les fichiers volumineux en blocs (par exemple, de 128 Mo ou 256 Mo) et les distribue sur plusieurs machines du cluster. Pour garantir la tolérance aux pannes, chaque bloc est répliqué (généralement 3 fois) et stocké sur des machines différentes. Si une machine tombe en panne, les données restent accessibles.
-
MapReduce : C'est le framework de traitement originel de Hadoop. Il permet de traiter les données en parallèle sur toutes les machines du cluster. Le processus se déroule en deux phases, un concept que votre expertise en traitement de données vous aidera à saisir intuitivement :
- Map : Chaque machine applique une opération de "mapping" (filtrage, transformation) à la portion de données qu'elle détient.
- Reduce : Les résultats intermédiaires de la phase Map sont ensuite agrégés pour produire le résultat final. C'est analogue à une opération
GROUP BYsuivie d'une fonction d'agrégation (commeSUMouCOUNT) en SQL, mais exécutée en parallèle à très grande échelle.
-
YARN (Yet Another Resource Negotiator) : C'est le gestionnaire de ressources du cluster. YARN est le "cerveau" qui alloue les ressources de calcul (CPU, RAM) aux différentes applications qui tournent sur le cluster et qui planifie l'exécution des tâches.
Au-delà de ces trois piliers, de nombreux autres outils gravitent autour de Hadoop pour en simplifier l'usage. Par exemple, Apache Hive permet d'exécuter des requêtes de type SQL sur les données stockées dans HDFS, sans avoir à écrire du code MapReduce complexe en Java.
Voici une illustration visuelle des composants centraux de Hadoop.
2. L'évolution rapide : Apache Spark
Alors que Hadoop a révolutionné le stockage et le traitement par lots (batch processing), il a montré ses limites pour des cas d'usage nécessitant plus de rapidité et d'interactivité, comme l'analyse en temps réel (vue dans la leçon précédente) ou les algorithmes itératifs du Machine Learning.
Apache Spark est un moteur de traitement de données unifié, open-source et beaucoup plus rapide. Sa principale innovation est le traitement en mémoire (in-memory processing).
Contrairement à MapReduce, qui lit et écrit les données sur le disque entre chaque étape d'un calcul, Spark essaie de conserver un maximum de données dans la mémoire vive (RAM) du cluster. Cela réduit considérablement les temps de latence et accélère les calculs de manière spectaculaire (jusqu'à 100 fois plus rapide dans certains cas).
Pour approfondir, la vidéo suivante explique le fonctionnement de Spark et son écosystème.
What exactly is Apache Spark? | Big Data Tools
Cette vidéo de nullQueries explique de manière concise ce qu'est Apache Spark, son architecture et ses avantages par rapport à l'approche traditionnelle de Hadoop MapReduce.
Regardez la vidéo de 00:57 à 04:07. Portez une attention particulière aux points suivants : Le concept de RDD (Resilient Distributed Dataset), l'abstraction de données fondamentale de Spark. L'écosystème de bibliothèques : Spark SQL, Spark Streaming, MLlib et GraphX. Pourquoi Spark est-il considéré comme plus flexible et plus rapide que MapReduce ?
Les composants clés de l'écosystème Spark
Comme Hadoop, Spark est modulaire :
- Spark Core : C'est le moteur d'exécution de base, qui gère les RDDs et l'orchestration des tâches.
- Spark SQL : Permet d'exécuter des requêtes SQL sur les données et de manipuler des DataFrames (un concept similaire aux dataframes de R ou pandas en Python, qui vous est probablement familier).
- Spark Streaming : Permet de traiter des flux de données en quasi-temps réel. C'est la technologie qui alimente les systèmes de détection de fraude que nous avons étudiés.
- MLlib : Une bibliothèque complète d'algorithmes de Machine Learning conçus pour fonctionner à grande échelle. C'est un outil fondamental que nous retrouverons dans les prochains modules.
- GraphX : Une API pour le traitement de graphes (par exemple, pour analyser des réseaux sociaux ou des réseaux de transactions complexes).
3. Hadoop et Spark : Concurrents ou Complémentaires ?
Une question fréquente est de savoir si Spark remplace Hadoop. La réponse est nuancée. Spark est un remplaçant du moteur de traitement MapReduce, mais pas de l'écosystème Hadoop dans son ensemble.
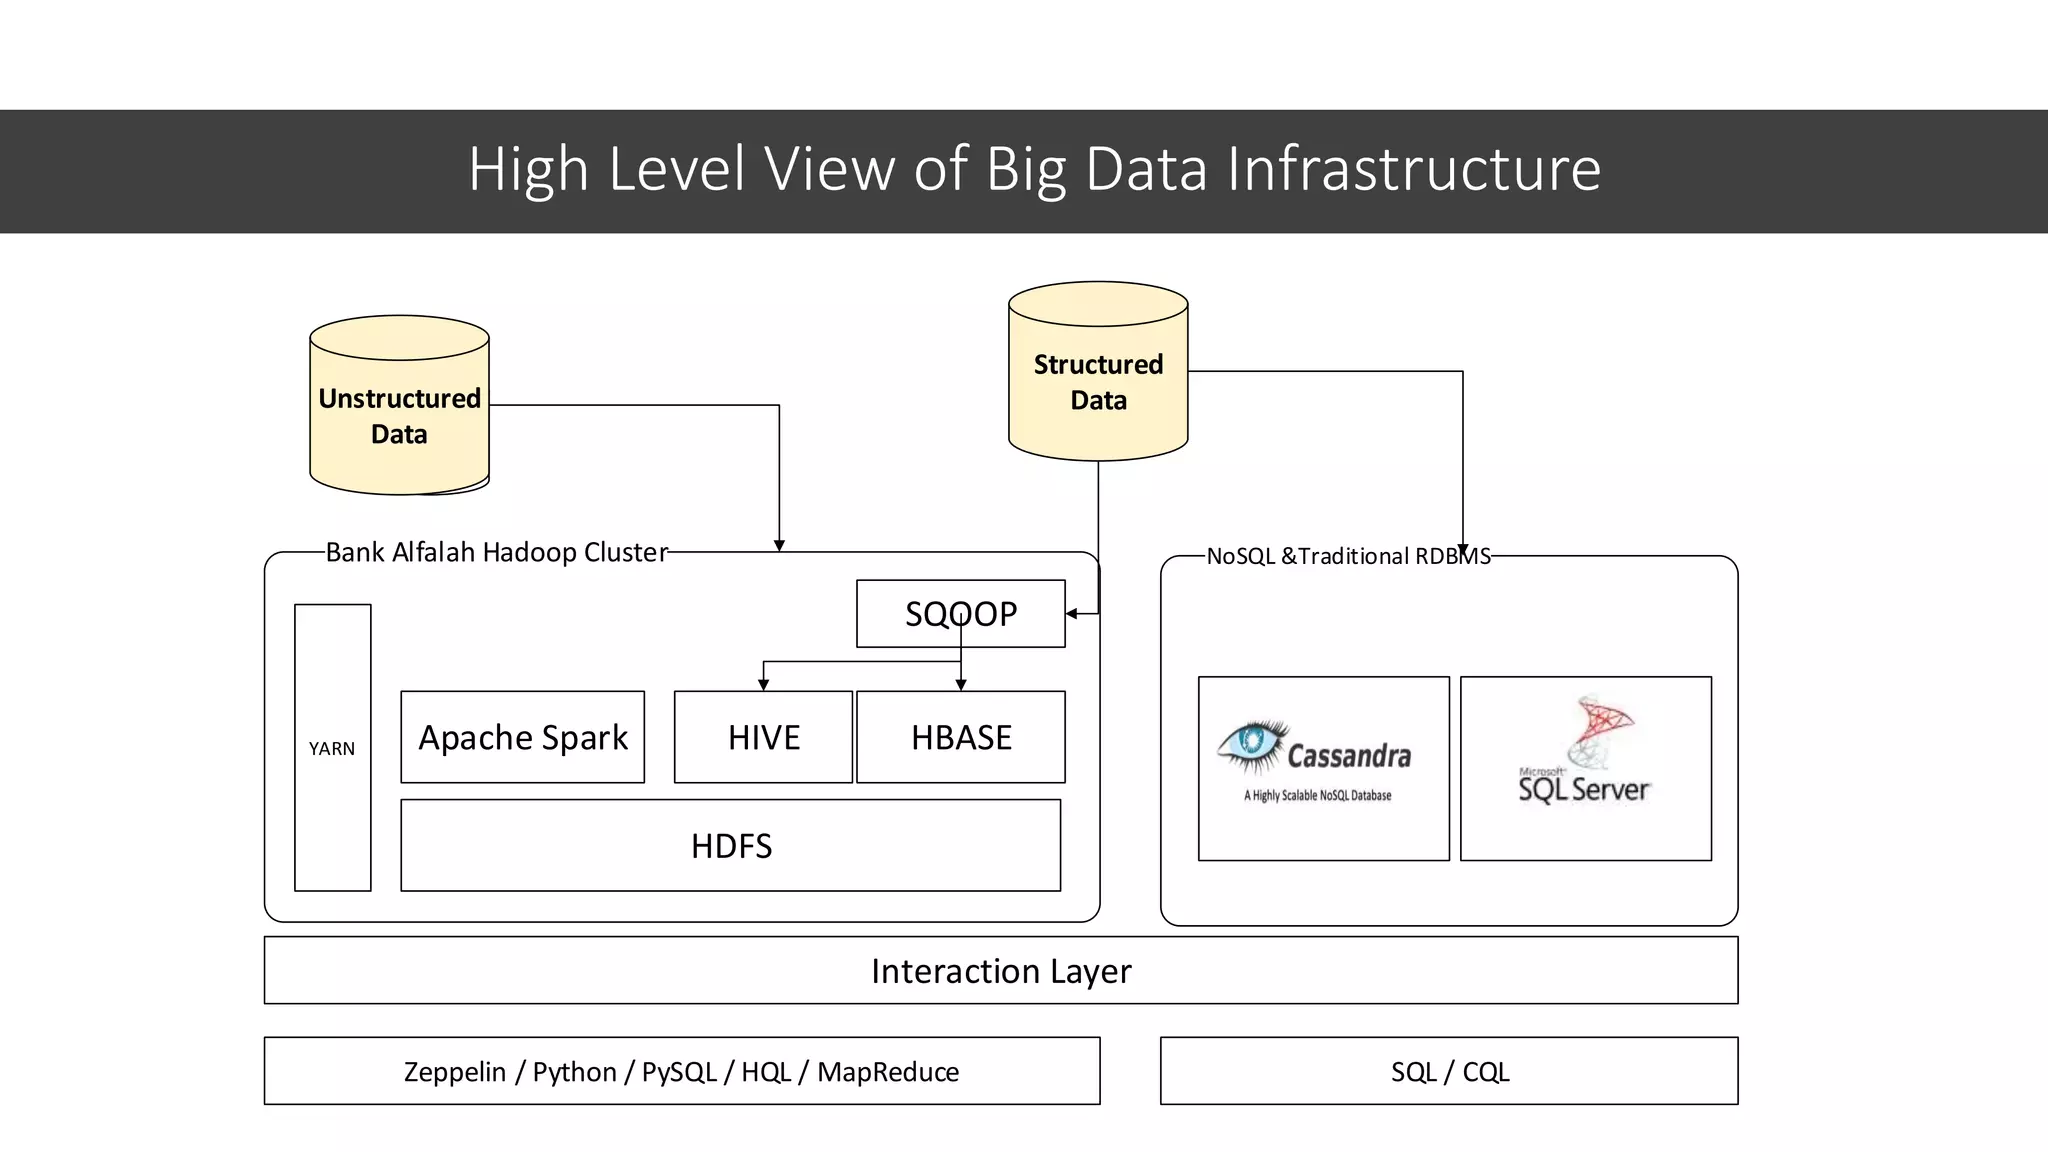
En pratique, l'architecture la plus courante aujourd'hui est d'exécuter Spark SUR un cluster Hadoop. Dans cette configuration :
- HDFS est utilisé pour le stockage de données à long terme, profitant de sa robustesse et de son faible coût.
- YARN est utilisé comme gestionnaire de ressources pour allouer la puissance de calcul aux applications Spark.
- Spark est utilisé comme moteur de traitement principal pour toutes les tâches d'analyse, de Machine Learning et de streaming.
L'article suivant résume bien les différences et les cas d'usage respectifs.
Hadoop vs. Spark: What's the Difference?
Cet article d'IBM compare directement Hadoop et Spark sur plusieurs critères importants comme la performance, le coût et la sécurité, et clarifie leur relation.
Lisez les sections intitulées "Comparing Hadoop and Spark" et "Hadoop and Spark use cases". Elles synthétisent les forces de chaque plateforme et vous aideront à comprendre quand utiliser l'une, l'autre, ou les deux ensemble.
Pour visualiser comment ces composants s'intègrent dans une architecture financière réelle, examinons le diagramme suivant.
Testez votre compréhension !
Une banque d'investissement souhaite mettre en place deux nouvelles capacités analytiques :
- Analyse de risque de portefeuille : Une analyse complexe qui doit tourner chaque nuit sur plus de 15 ans de données de marché historiques (plusieurs pétaoctets). Le coût du stockage est une préoccupation majeure.
- Aide à la décision pour les traders : Une application qui analyse les flux de news et les données de marché en temps réel pour suggérer des opportunités de trading en quelques secondes.
Quel(s) plateforme(s) recommanderiez-vous pour chaque cas d'usage, et pourquoi ?
Voir la réponse
C'est un scénario classique qui illustre la complémentarité de Hadoop et Spark.
-
Pour l'analyse de risque de portefeuille (batch) :
- Stockage : HDFS (du framework Hadoop) est la solution idéale. Il est conçu pour stocker de très grands volumes de données de manière fiable et à faible coût sur du matériel standard.
- Traitement : Bien que MapReduce puisse faire le travail, Spark serait plus performant pour ce type d'analyse par lots (batch). Une exécution sur Spark serait beaucoup plus rapide, même si la tâche ne s'exécute qu'une fois par nuit. L'architecture serait donc Spark sur HDFS.
-
Pour l'aide à la décision en temps réel :
- Traitement : Spark Streaming est indispensable ici. Sa capacité de traitement en mémoire (in-memory) est cruciale pour analyser des flux de données avec une très faible latence et fournir des résultats en quelques secondes.
- Stockage : Les données de référence (modèles, données historiques agrégées) pourraient être stockées sur HDFS, tandis que les flux en temps réel sont traités directement en mémoire par Spark.
Conclusion de la recommandation : La meilleure approche pour la banque serait de construire un cluster Hadoop unique utilisant HDFS pour le stockage et YARN pour la gestion des ressources. Sur ce même cluster, elle pourrait exécuter ses tâches batch (analyse de risque) avec Spark et ses tâches temps réel (aide à la décision) avec Spark Streaming. C'est l'essence même d'une plateforme Big Data moderne : un socle unique pour des cas d'usage variés.
Conclusion
Aujourd'hui, nous avons "ouvert le capot" des applications Big Data pour examiner les moteurs qui les animent. Comprendre le rôle de Hadoop et de Spark est fondamental pour quiconque s'intéresse à la finance axée sur les données.
Voici les points clés à retenir :
- Apache Hadoop a posé les fondations du Big Data avec un système de stockage distribué et résilient (HDFS) et un modèle de traitement par lots (MapReduce). Il reste la référence pour le stockage de masse à faible coût.
- Apache Spark représente une évolution majeure, avec un moteur de traitement en mémoire beaucoup plus rapide et polyvalent. Il excelle dans les calculs itératifs (Machine Learning) et l'analyse en temps réel (streaming).
- Hadoop et Spark ne sont pas des ennemis, mais des alliés. L'architecture la plus courante combine le stockage HDFS et la gestion de ressources YARN (de Hadoop) avec le puissant moteur de traitement Spark.
Maintenant que nous avons une vision claire des applications du Big Data et de l'infrastructure qui les supporte, nous sommes prêts à plonger dans le monde passionnant du Machine Learning.
Dans la prochaine leçon, nous commencerons le module 4 en définissant formellement l'Intelligence Artificielle et le Machine Learning. Nous distinguerons les trois grands paradigmes d'apprentissage : supervisé, non supervisé et par renforcement, qui sont au cœur de nombreuses innovations financières actuelles.