أهلاً بك في درسنا الثالث!
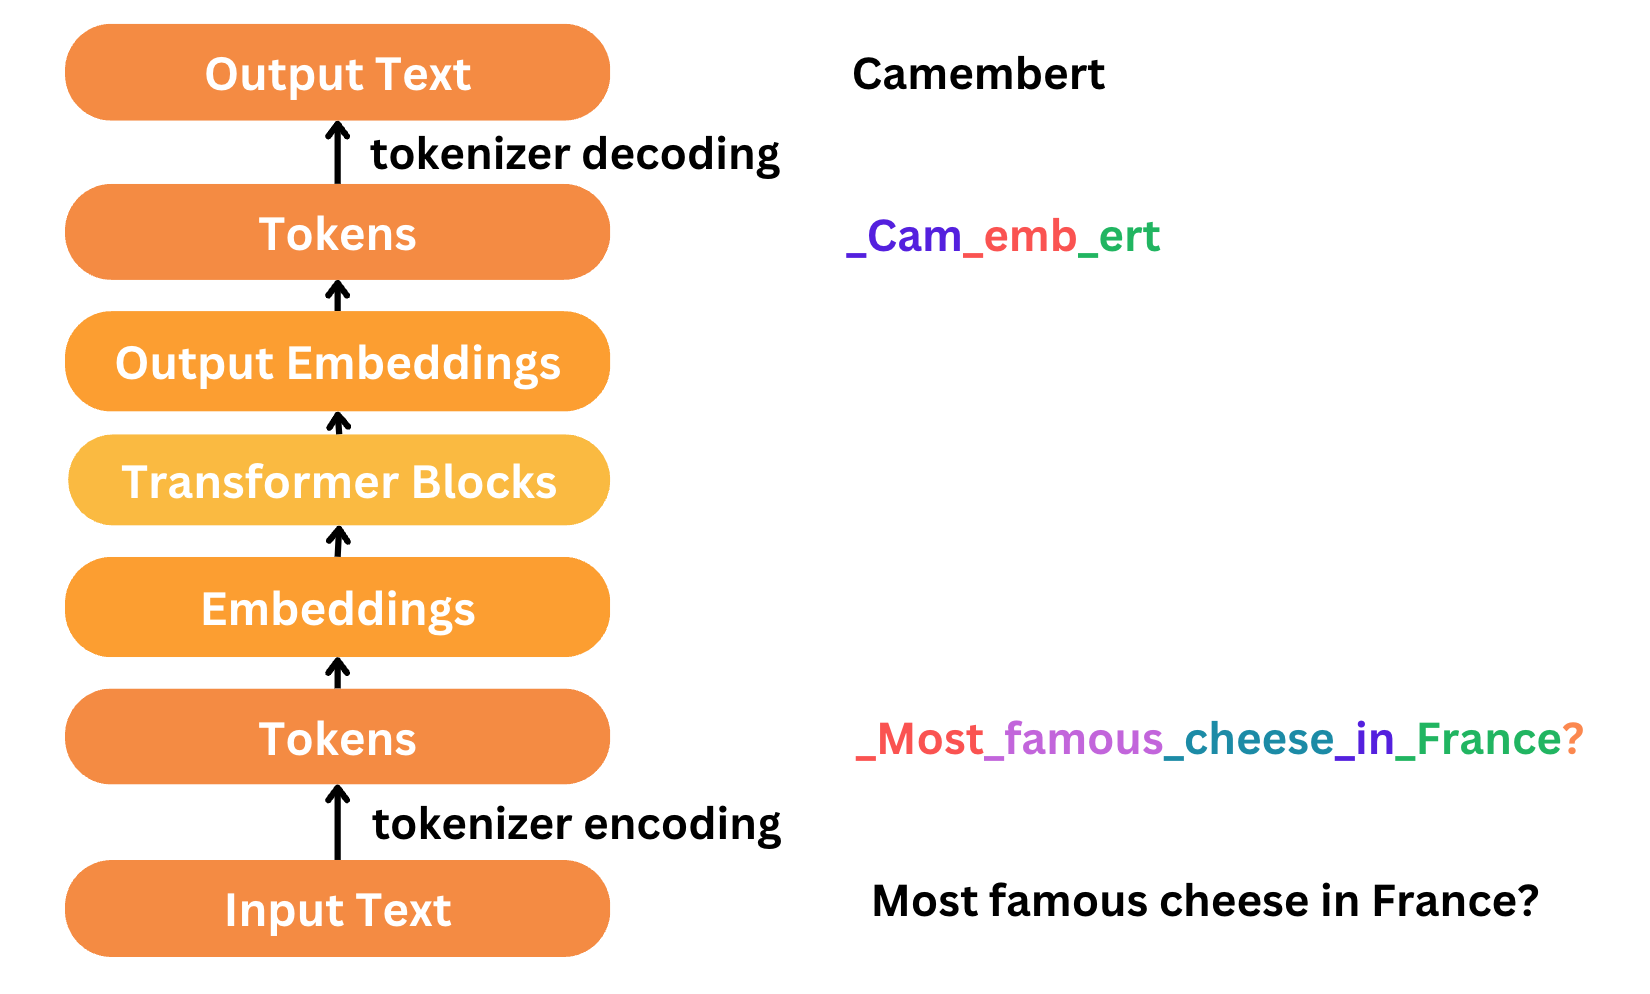
في الدرس السابق، استكشفنا الصورة الكبيرة لكيفية عمل نماذج اللغة الكبيرة (LLMs)، ورأينا أنها عملية من خمس خطوات تبدأ بالترميز (Tokenization) وتنتهي بتوليد النص.
اليوم، سنقوم بالتركيز على الخطوة الأولى والأساسية في هذه الرحلة: فهم آلية تحويل النص إلى رموز (Tokenization) وأهميتها. هذه العملية هي حجر الزاوية الذي يمكن الآلة من فهم لغتنا البشرية. سنكتشف ما هي "الرموز" (Tokens) بالضبط، ولماذا لا تكون دائمًا كلمات كاملة، وكيف تؤثر هذه العملية بشكل مباشر على أداء النموذج وتكلفة استخدامه.
1. ما هو الترميز (Tokenization)؟
ببساطة، الترميز (Tokenization) هو عملية تقسيم النص إلى وحدات أصغر تسمى الرموز (Tokens). هذه هي الخطوة الأولى والضرورية لترجمة لغتنا البشرية إلى لغة يمكن للكمبيوتر فهمها، وهي لغة الأرقام.
لا تستطيع نماذج الذكاء الاصطناعي معالجة جملة "الذكاء الاصطناعي مذهل" كنص خام. بدلاً من ذلك، يجب عليها أولاً تفكيكها إلى أجزاء يمكن التحكم فيها.

من المهم أن نميز بين المصطلحين:
- الترميز (Tokenization): هي العملية أو الخوارزمية التي تقوم بتقسيم النص.
- الرمز (Token): هو الناتج أو الوحدة الفردية التي تنتج عن هذه العملية.
للحصول على تعريف دقيق وموجز، اقرأ الفقرات القليلة الأولى من هذا المقال الذي يوضح الفرق بين "الترميز" و"الرمز".
اقرأ المقدمة وقسم "الترميز مقابل الرمز المميز" (Tokenization vs. Token). سيساعدك هذا على ترسيخ الفهم الأساسي للمفهومين.
الآن، قد تعتقد أن الرمز (Token) هو مجرد كلمة. هذا صحيح أحياناً، ولكنه ليس كذلك دائمًا. دعنا نكتشف المزيد.
2. الرمز ليس دائمًا كلمة
في بدايات معالجة اللغات الطبيعية، كانت أبسط طريقة للترميز هي تقسيم الجملة عند كل مسافة. لكن هذه الطريقة لها مشاكل، فكلمة مثل "مكتبة،" ستُعتبر وحدة واحدة مع الفاصلة الملتصقة بها، مما يربك النموذج.
نماذج اللغة الحديثة تستخدم طرقاً أكثر ذكاءً. غالبًا ما يكون الرمز جزءًا من كلمة، يُعرف بـ الكلمة الفرعية (Subword).
شاهد المقطع التالي الذي يشرح هذه الفكرة بشكل ممتاز، ويوضح أن نماذج اللغة تتعامل مع هذه الوحدات الأصغر وليس بالضرورة مع الكلمات الكاملة.
اذا كنت من مستخدمي الذكاء الإصطناعي - بتطبيق عملي حتفهم 👌Tokens in ChatGPT
يقدم هذا الفيديو من قناة Infotech4you شرحاً واضحاً لمفهوم الرموز وكيف أنها ليست مرادفة للكلمات.
شاهد المقطع من الدقيقة 00:49 إلى 02:28. ركز على الفكرة الأساسية: النموذج لا يتعامل مع النص كما نكتبه، بل يقسمه إلى وحدات أصغر تسمى "tokens" لفهمها.
لماذا هذا التقسيم إلى كلمات فرعية مفيد جداً؟
- معالجة الكلمات النادرة: إذا واجه النموذج كلمة لم يرها من قبل، مثل "التكنولوجيا الحيوية"، يمكنه تفكيكها إلى أجزاء مألوفة مثل
["التكنو"]،["لوجيا"]،["الحيوية"]وفهمها من خلال مكوناتها. - كفاءة المفردات: بدلاً من أن يحتاج النموذج إلى مفردات تحتوي على كل كلمة ممكنة في اللغة (ملايين الكلمات)، يمكنه استخدام مفردات أصغر بكثير من الكلمات الفرعية الشائعة لتكوين أي كلمة.
3. الترميز في الممارسة العملية
لنرى كيف تبدو هذه العملية بشكل عملي. توفر العديد من الشركات التي تطور نماذج اللغة أدوات تتيح لك رؤية كيف يتم ترميز نص معين.
في المقطع التالي، يستخدم مقدم الفيديو أداة OpenAI لعرض عملية الترميز بشكل حي. هذا سيعطيك فهماً ملموساً للمفاهيم التي ناقشناها.
اذا كنت من مستخدمي الذكاء الإصطناعي - بتطبيق عملي حتفهم 👌Tokens in ChatGPT
يستعرض هذا الجزء من الفيديو تطبيقاً عملياً للترميز باستخدام أداة OpenAI.
شاهد المقطع من الدقيقة 04:22 إلى 07:40. أثناء المشاهدة، لاحظ النقاط التالية: كيف أن جملة قصيرة تتكون من عدد معين من الحروف والكلمات، ولكن من عدد مختلف من الرموز. كل رمز ملون له رقم معرّف فريد (ID). هذه الأرقام هي ما يتعامل معها النموذج فعلياً. لاحظ كيف أن الحرف الكبير (Capital) والصغير (Small) يمكن أن يؤدي إلى رموز وأرقام معرفة مختلفة تمامًا.
كما رأيت، العملية تحول النص إلى سلسلة من الأرقام (IDs). هذه السلسلة من الأرقام هي المدخل الحقيقي للنموذج، وليست الكلمات نفسها.
4. ما أهمية كل هذا؟
قد يبدو الترميز تفصيلاً تقنياً، لكن فهمه ضروري لأنه يؤثر بشكل مباشر على ثلاثة جوانب رئيسية:
-
فهم المعنى: طريقة تقسيم الكلمات تؤثر على كيفية فهم النموذج للعلاقات بينها. خوارزميات الترميز المتقدمة مثل ترميز أزواج البايت (Byte-Pair Encoding - BPE)، تتعلم من النص كيفية دمج الحروف الأكثر تكرارًا لتكوين كلمات فرعية ذات معنى. هذا يسمح للنموذج بالتعامل مع لغات معقدة بفعالية.
-
حدود السياق (Context Window): كل نموذج لغوي له حد أقصى من الرموز التي يمكنه معالجتها في المرة الواحدة (إدخال + إخراج). على سبيل المثال، إذا كان حد النموذج هو 4096 رمزًا، فلا يمكنك إعطاؤه مستندًا طويلاً لتحليله دفعة واحدة. عليك أن تكون على دراية بعدد الرموز في طلبك.
-
التكلفة: معظم واجهات برمجة التطبيقات (APIs) لنماذج اللغة الكبيرة تفرض رسومًا بناءً على عدد الرموز التي تستخدمها. فهم كيفية عمل الترميز يساعدك على كتابة طلبات (prompts) أكثر كفاءة وفعالية من حيث التكلفة.
اختبر فهمك!
تخيل أن لديك الجملة التالية: "البرمجة ممتعة وغير متوقعة".
إذا استخدمنا أداة ترميز تعتمد على الكلمات الفرعية، أي من الخيارين التاليين هو الأرجح لترميز كلمة "وغير"؟
أ) ["وغير"] (رمز واحد)
ب) ["و"]، ["غير"] (رمزان)
ولماذا تعتقد ذلك؟
أظهر الإجابة
الخيار (ب) ["و"]، ["غير"] هو الأكثر ترجيحًا.
السبب: "و" و "غير" هما وحدتان لغويتان شائعتان جدًا وتظهران في آلاف السياقات المختلفة. من خلال فصلهما، يمكن للنموذج إعادة استخدام هذين الرمزين لبناء عدد لا يحصى من الكلمات والعبارات الأخرى ("و لكن"، "غير صحيح"، "و جميل"، إلخ). هذا أكثر كفاءة من وجود رمز واحد لكلمة "وغير" التي قد تكون أقل تكرارًا.
ملخص وأهم النقاط
لقد تعمقنا اليوم في الخطوة الأولى الحاسمة في رحلة البيانات داخل النموذج اللغوي.
- الترميز (Tokenization) هو عملية تحويل النص إلى وحدات صغيرة (رموز) ممثلة بأرقام، وهي اللغة التي يفهمها الكمبيوتر.
- الرمز (Token) ليس دائمًا كلمة كاملة، بل غالبًا ما يكون كلمة فرعية (Subword)، مما يسمح للنموذج بمعالجة الكلمات النادرة بكفاءة.
- كل رمز له رقم معرّف فريد (ID)، وهذه الأرقام هي ما يستخدمه النموذج فعليًا في حساباته.
- فهم الترميز مهم لأنه يؤثر على فهم المعنى، حدود السياق للنموذج، وتكلفة الاستخدام.
ما التالي؟
الآن بعد أن عرفنا كيف يتم تحويل النص إلى قائمة من الأرقام التعريفية (IDs)، قد تتساءل: كيف يعرف النموذج أن الرمز رقم 583 (مثلاً لكلمة "ملك") قريب في المعنى من الرمز رقم 799 (مثلاً لكلمة "ملكة")؟
هذا هو موضوع درسنا القادم، حيث سنتناول الخطوة الثانية في العملية: تضمين الكلمات (Embeddings). سنكتشف كيف يتم تحويل هذه الأرقام التعريفية البسيطة إلى تمثيلات رقمية غنية بالمعنى، مما يمنح النموذج قدرته المذهلة على فهم العلاقات الدلالية بين الكلمات.