أهلاً بك مجدداً!
في الدرس السابق، قمنا ببناء دالة retrieve_memories التي سمحت لوكيلنا باسترجاع المعلومات من ذاكرته طويلة المدى. كانت خطوة مهمة، لكن طريقة البحث التي استخدمناها كانت تعتمد على المطابقة التامة لنوع الذاكرة (WHERE type = ?). هذا الأسلوب، المعروف بالبحث بالكلمات المفتاحية، له حدوده. فماذا لو أراد الوكيل أن يتذكر "ما قلته عن تفضيلاتي في البرمجة؟" بدلاً من البحث عن نوع ذاكرة محدد اسمه "تفضيل المستخدم"؟
اليوم، سننتقل إلى مستوى أكثر ذكاءً في استرجاع المعلومات. هدفنا هو فهم مبدأ البحث الدلالي (Semantic Search). هذه التقنية هي التي تسمح للأنظمة الحديثة بفهم القصد من وراء كلماتك، والعثور على المعلومات الأكثر صلة بناءً على المعنى وليس فقط على تطابق الكلمات.
1. قصور البحث التقليدي (المعجمي)
البحث التقليدي، أو "المعجمي" (Lexical Search)، يعتمد على مطابقة الكلمات الموجودة في استعلام البحث مع الكلمات الموجودة في المستندات. إذا كنت تبحث عن "سيارة سريعة"، فإنه يبحث عن المستندات التي تحتوي على كلمتي "سيارة" و"سريعة".
لكن هذا النهج يواجه صعوبات كثيرة:
- المرادفات: قد يحتوي مستند على "مركبة خاطفة" بدلاً من "سيارة سريعة". البحث التقليدي قد لا يجده.
- السياق: جملة "أحتاج فنجان قهوة، أين الكوب؟" وجملة "أين أقيم كأس العالم؟" تشتركان في كلمة "كأس" (cup)، لكن معناهما مختلف تماماً.
- الصياغة: قد تبحث عن "فيلم عن دمية تشعر بالغيرة من لعبة فضاء جديدة"، لكن وصف الفيلم في قاعدة البيانات هو "دمية راعي بقر تشعر بالتهديد عندما تصبح لعبة فضاء جديدة هي المفضلة لدى مالكها". الكلمات مختلفة، لكن المعنى واحد.
للحصول على فهم أعمق لهذا الفرق، شاهد هذين المقطعين القصيرين.
يقارن هذا الفيديو من قناة 'Redis' بين البحث التقليدي والبحث الدلالي باستخدام مثال فيلم 'Toy Story' الذي ذكرناه. إنه يوضح المشكلة بشكل ممتاز.
شاهد أول 56 ثانية من الفيديو. ركز على كيفية فشل البحث التقليدي في العثور على الفيلم الصحيح بسبب اختلاف الكلمات، وكيف ينجح البحث الدلالي في ذلك.
يستعرض هذا الفيديو من قناة 'Cohere' أيضاً مثالاً آخر يوضح كيف يمكن أن يخطئ البحث بالكلمات المفتاحية ويختار الجملة الخطأ فقط لأنها تحتوي على كلمات مشتركة أكثر.
شاهد من الدقيقة 0:36 إلى 2:19. لاحظ كيف يختار البحث المعجمي جملة 'أين في العالم كوب قهوتي الأخير؟' كأفضل نتيجة لسؤال 'أين كان كأس العالم الأخير؟' بسبب عدد الكلمات المتطابقة.
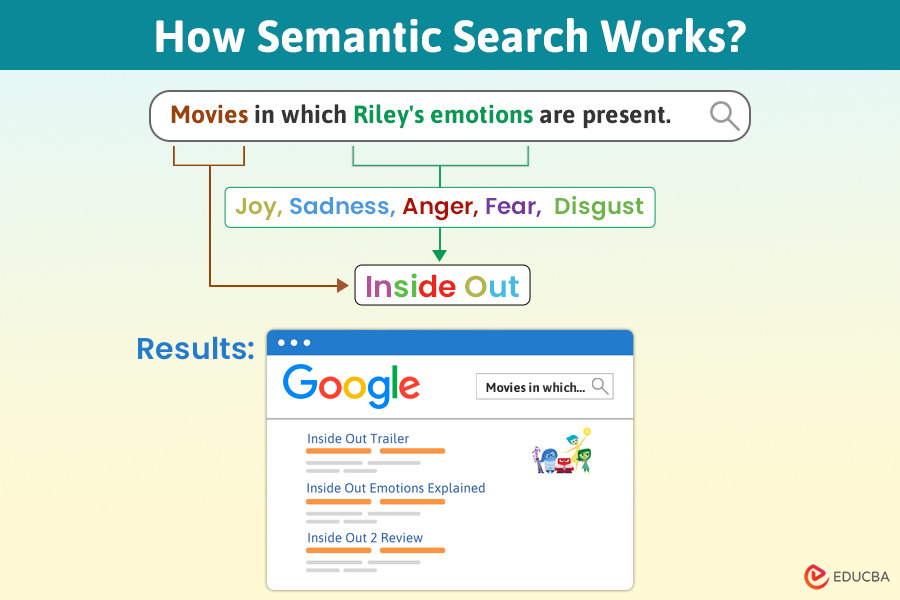
2. جوهر البحث الدلالي: من الكلمات إلى الأرقام
إذن، كيف "يفهم" البحث الدلالي المعنى؟ السر يكمن في فكرة ثورية تسمى التضمينات (Embeddings).
التضمين هو عملية تحويل قطعة من النص (كلمة، جملة، أو فقرة كاملة) إلى قائمة من الأرقام تسمى المتجه (Vector). هذه الأرقام ليست عشوائية؛ بل هي تمثيل رياضي لمعنى النص.
الفكرة الأساسية هي:
النصوص التي لها معانٍ متقاربة سيكون لها متجهات رقمية متقاربة.
تخيل خريطة ضخمة "لفضاء المعنى". في هذه الخريطة، ستجد جملة "كيف حال الطقس اليوم؟" قريبة جداً من جملة "هل الجو مشمس بالخارج؟"، ولكنهما ستكونان بعيدتين جداً عن جملة "ما هي عاصمة فرنسا؟".

لتعميق فهمك لهذه النقطة المحورية، اقرأ المقال التالي.
يشرح هذا المقال من 'Cohere' - وهي شركة رائدة في هذا المجال - كيفية عمل البحث الدلالي بالتفصيل. سنركز على الأجزاء التي تشرح مفهوم التضمينات.
اقرأ المقدمة تحت عنوان 'What is Not Semantic Search؟' ثم انتقل إلى القسم التالي 'How to Search Using Text Embeddings?'. ركز على فهم كيف يتم تمثيل الجمل كنقاط في فضاء، وكيف تكون الجمل المتشابهة في المعنى متقاربة في هذا الفضاء.
3. إيجاد أقرب معنى: قياس التشابه (Similarity)
بعد أن حولنا كل النصوص (ذكريات الوكيل وسؤال المستخدم) إلى متجهات رقمية، أصبحت مهمة البحث مسألة رياضية: "أي متجه من متجهات الذاكرة هو الأقرب إلى متجه السؤال؟"
نحن لا نستخدم المسطرة لقياس هذه "المسافة"، بل نستخدم مقاييس رياضية خاصة تسمى مقاييس التشابه (Similarity Metrics). أشهرها هو تشابه جيب التمام (Cosine Similarity).
لا داعي للقلق بشأن معادلته الرياضية الآن. كل ما تحتاج لمعرفته هو أنه يعطيك درجة بين 0 و 1:
- الدرجة 1: تعني أن النصين متطابقان تماماً في المعنى.
- درجة قريبة من 1 (مثل 0.9): تعني أن النصين متشابهان جداً في المعنى.
- درجة قريبة من 0: تعني أن النصين مختلفان تماماً في المعنى.
إذن، عملية البحث الدلالي تقوم بحساب درجة التشابه بين متجه السؤال وكل متجه من متجهات الذاكرة، ثم تُرجع النصوص الأصلية التي حصلت على أعلى الدرجات.
يعود هذا الفيديو من 'Cohere' ليوضح هذه الفكرة بشكل مرئي. ستشاهد كيف يتم تحديد الجواب الأقرب بناءً على قربه في فضاء التضمينات.
شاهد من الدقيقة 4:11 إلى 5:20. ركز على كيف يقع متجه السؤال بالقرب من متجه الإجابة الصحيحة، وكيف يمكن قياس هذا القرب باستخدام 'التشابه'.
اختبر فهمك!
لنفترض أن ذاكرة وكيلنا تحتوي على ثلاث جمل تم تحويلها إلى متجهات:
- "درجة حرارة اليوم مرتفعة جداً."
- "جدول أعمالي مزدحم هذا الأسبوع."
- "أنا أستمتع بالسباحة في الطقس الحار."
إذا استقبل الوكيل استعلامًا من المستخدم يقول: "ما هي الأنشطة الممتعة في الصيف؟"، وقام بتحويله إلى متجه. أي جملة من الذاكرة ستحصل على أعلى درجة تشابه مع متجه الاستعلام، ولماذا؟
Show answer
الجملة رقم 3 ("أنا أستمتع بالسباحة في الطقس الحار.") ستحصل على أعلى درجة تشابه على الأرجح.
السبب: على الرغم من أن الجملة رقم 1 تذكر "الطقس الحار"، إلا أن الجملة رقم 3 تربط بشكل مباشر بين "الطقس الحار" و"نشاط ممتع" (السباحة)، وهو ما يتوافق دلالياً بشكل أقوى مع سؤال المستخدم عن "الأنشطة الممتعة في الصيف". البحث الدلالي يتجاوز مجرد وجود كلمة "حار" ليفهم العلاقة بين المفاهيم. الجملة رقم 2 هي الأقل صلة على الإطلاق.
خلاصة الدرس
لقد قطعنا شوطاً كبيراً في فهم آلية متقدمة وذكية لاسترجاع المعلومات. هذه هي أهم النقاط التي تعلمناها اليوم:
- البحث الدلالي مقابل المعجمي: البحث الدلالي يبحث بناءً على المعنى والسياق، بينما البحث المعجمي (التقليدي) يعتمد على مطابقة الكلمات المفتاحية.
- التضمينات (Embeddings): هي حجر الزاوية في البحث الدلالي. إنها تحول النص إلى تمثيل رقمي (متجه) يلتقط معناه.
- فضاء المعنى: النصوص ذات المعاني المتقاربة تكون متقاربة في هذا الفضاء الرقمي.
- قياس التشابه (Similarity): نستخدم مقاييس رياضية مثل تشابه جيب التمام لتحديد مدى "قرب" متجه السؤال من متجهات الذاكرة، مما يسمح لنا بالعثور على المعلومة الأكثر صلة.
ماذا بعد؟
الآن، أصبح وكيلنا يمتلك القدرة (نظرياً) على البحث في ذاكرته بذكاء وفهم المعنى. لكن هذا يحل نصف المشكلة فقط. بعد أن يسترجع الوكيل المعلومة الأكثر صلة (مثلاً: "المستخدم يفضل الشرح باللغة العربية")، كيف يستخدم هذه المعلومة فعلياً لصياغة إجابته التالية؟
في الدرس القادم، سنتعرف على تقنية رائعة تسمى الجيل المعزز بالاسترجاع (Retrieval-Augmented Generation - RAG). هذه التقنية تجمع بين قوة البحث الدلالي الذي تعلمناه اليوم، وقدرة نماذج اللغة الكبيرة على توليد النصوص، لإنتاج إجابات أكثر دقة وذكاءً وتخصيصاً.