أهلاً بك مجددًا في رحلتنا لبناء وكلاء الذكاء الاصطناعي.
في الدرس السابق، استكشفنا قوة البحث الدلالي (Semantic Search). تعلمنا كيف يمكن لوكيلنا أن يتجاوز مطابقة الكلمات المفتاحية للعثور على المعلومات الأكثر صلة بالمعنى الحقيقي لسؤال المستخدم. لقد أصبح وكيلنا الآن قادرًا على "فهم" النية واسترجاع الذكريات الصحيحة من قاعدة بياناته.
لكن، هذا يطرح سؤالًا منطقيًا: بعد أن يسترجع الوكيل قطعة المعلومات ذات الصلة، ماذا يفعل بها بالضبط؟ كيف تتحول هذه المعلومة المسترجعة إلى إجابة ذكية ومفيدة للمستخدم؟
هذا هو محور درسنا اليوم. هدفنا هو شرح تقنية "الجيل المعزز بالاسترجاع" (Retrieval-Augmented Generation - RAG) على مستوى المفاهيم. هذه التقنية هي الجسر الذي يربط بين قدرة الوكيل على البحث وقدرته على التفكير والتوليد، مما يمنحه قوة هائلة للإجابة على الأسئلة بدقة ووعي بالسياق.
1. لماذا نحتاج إلى RAG؟ حدود نماذج اللغة الكبيرة
قبل أن نتعمق في RAG، دعنا نفهم المشكلة التي تحلها. نماذج اللغة الكبيرة (LLMs) مثل GPT-4 هي أدوات قوية جدًا، لكنها تشبه شخصًا عبقريًا قرأ كل محتويات الإنترنت... حتى عام 2023. هذا يعني أنها تواجه ثلاث مشكلات رئيسية:
- المعرفة القديمة (Outdated Knowledge): لا تعرف أي شيء حدث بعد تاريخ تدريبها. إذا سألتها عن الفائز بكأس العالم 2026، فلن تعرف الإجابة.
- نقص المعرفة الخاصة (Lack of Private Knowledge): لا تعرف أي شيء عن بياناتك الشخصية أو مستندات شركتك الداخلية. هي لا تستطيع الإجابة على سؤال مثل "ما هي ملخصات اجتماعاتنا الأسبوع الماضي؟".
- الهلوسة (Hallucination): عندما لا تعرف الإجابة، قد تحاول "تأليف" إجابة تبدو مقنعة لكنها خاطئة تمامًا.
لفهم هذه المشكلة بشكل عملي، شاهد المقدمة القصيرة لهذا الفيديو من IBM.
What is Retrieval-Augmented Generation (RAG)?
يستخدم هذا الفيديو مثالاً بسيطًا وممتازًا حول عدد أقمار كوكب زحل لتوضيح مشكلة المعرفة القديمة وانعدام المصادر في نماذج اللغة.
شاهد المقطع من البداية حتى الدقيقة 2:59. ركز على المشكلتين الأساسيتين اللتين تم طرحهما: الإجابة القديمة (out of date) وعدم وجود مصدر (no source).
تقنية RAG هي الحل الأنيق لهذه المشكلات. إنها تسمح للنموذج اللغوي بإجراء "امتحان كتاب مفتوح" (open-book exam) بدلاً من الاعتماد فقط على ذاكرته الداخلية (امتحان كتاب مغلق).
2. ما هو الجيل المعزز بالاسترجاع (RAG)؟
ببساطة، RAG هي عملية من خطوتين:
- استرجاع (Retrieve): أولاً، ابحث عن المعلومات ذات الصلة من مصدر خارجي (مثل قاعدة بيانات الذاكرة الخاصة بوكيلنا، أو ملفات PDF، أو حتى نتائج بحث مباشرة من الإنترنت).
- توليد (Generate): ثانيًا، قدّم هذه المعلومات المسترجعة مع السؤال الأصلي إلى نموذج اللغة الكبير (LLM) ليستخدمها كأساس لتوليد إجابة دقيقة ومستندة إلى مصدر.
دعنا نفكك الاسم لفهمه بشكل أفضل:
- Retrieval (الاسترجاع): هذا هو بالضبط ما تعلمناه في الدرس السابق! استخدام البحث الدلالي للعثور على المستندات أو الذكريات ذات الصلة.
- Augmented (المعزّز): نحن نعزز أو ندعم سؤال المستخدم الأصلي بالمعلومات التي استرجعناها.
- Generation (التوليد): يقوم الـ LLM بتوليد الإجابة النهائية بناءً على هذا السؤال المعزز.
لفهم أعمق للتعريف الرسمي والفوائد، اقرأ المقدمة والفوائد من هذا المقال.
ما المقصود بالتوليد المعزز بالاسترجاع (RAG)؟
يقدم هذا المقال من IBM تعريفًا واضحًا وموجزًا لتقنية RAG ويسرد فوائدها الرئيسية.
اقرأ قسم 'ما المقصود بالتوليد المعزز بالاسترجاع (RAG)؟' ثم تصفح العناوين الرئيسية في قسم 'ما فوائد RAG؟' (مثل: الوصول إلى البيانات الحالية، انخفاض خطر هلوسة الذكاء الاصطناعي).
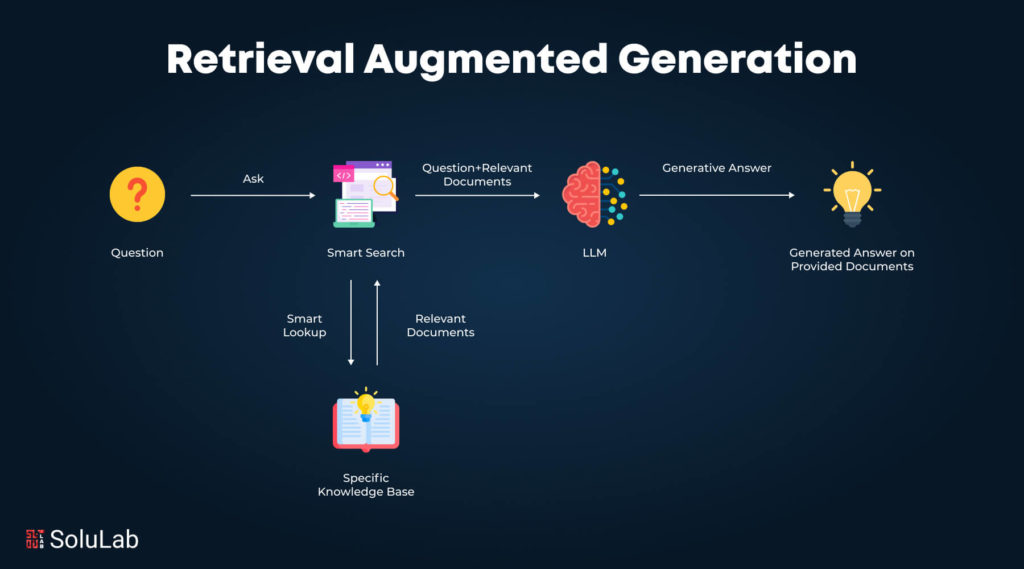
3. كيف تعمل تقنية RAG خطوة بخطوة؟
الآن بعد أن فهمنا الفكرة العامة، دعنا نتتبع سير العمل بالتفصيل. تخيل أنك تسأل وكيلك الذكي: "لخّص لي النقاط الرئيسية من اجتماع الأمس بخصوص مشروع 'ألفا'".
هذا ما يحدث خلف الكواليس:
- استلام الطلب: يستقبل الوكيل سؤالك.
- استرجاع المعلومات (Retrieval):
- يدرك الوكيل أنه بحاجة لمعلومات من مصدر خارجي.
- يقوم "المسترجِع" (Retriever) - وهو المكون الذي يستخدم البحث الدلالي - بتحويل سؤالك إلى متجه رقمي.
- يبحث هذا المتجه في "قاعدة المعرفة" (Knowledge Base) - التي قد تكون قاعدة بيانات تحتوي على محاضر الاجتماعات - عن المستندات الأكثر تشابهًا في المعنى.
- يعثر على مستند بعنوان "محضر اجتماع مشروع ألفا - 25 أكتوبر".
- تعزيز الطلب (Augmentation):
- يقوم الوكيل بصياغة "طلب معزز" (Augmented Prompt) جديد للنموذج اللغوي. يبدو هذا الطلب كالتالي:
السياق: "محضر اجتماع مشروع ألفا - 25 أكتوبر: تمت مناقشة الميزانية والمواعيد النهائية. قرر الفريق زيادة ميزانية التسويق بنسبة 15% وتأجيل موعد الإطلاق أسبوعين..."
السؤال: "بناءً على السياق أعلاه، لخّص لي النقاط الرئيسية من اجتماع الأمس بخصوص مشروع 'ألفا'."
- يقوم الوكيل بصياغة "طلب معزز" (Augmented Prompt) جديد للنموذج اللغوي. يبدو هذا الطلب كالتالي:
- توليد الإجابة (Generation):
- يستقبل الـ LLM (المكون الذي يسمى "المولّد" أو Generator) هذا الطلب المعزز.
- بفضل السياق الواضح والمحدد، يقوم بتوليد إجابة دقيقة مثل: "بالتأكيد، النقاط الرئيسية من اجتماع الأمس هي: زيادة ميزانية التسويق بنسبة 15% وتأجيل موعد إطلاق مشروع 'ألفا' لمدة أسبوعين."
لترى هذه العملية مشروحة بالصوت والصورة، شاهد هذا المقطع.
تخصيص نماذج الذكاء الاصطناعي: الفرق بين RAG و Fine-Tuning
يشرح هذا الفيديو من قناة 'إسلام يونس' الفرق بين RAG وتقنية أخرى اسمها Fine-tuning، لكنه يقدم شرحًا ممتازًا ومبسطًا لآلية عمل RAG باستخدام رسم توضيحي.
شاهد من الدقيقة 2:03 إلى 5:14. ركز على كيفية استخدام النموذج لمصادر خارجية، وكيف يتم دمج 'الأمر' (سؤالك) مع 'السياق' (المعلومة المسترجعة) لتكوين رد دقيق.
الصورة التالية تلخص العملية بأكملها، بما في ذلك مرحلة التحضير (Indexing) التي تحدث مرة واحدة، ومرحلة الاسترجاع والتوليد التي تحدث مع كل سؤال.

اختبر فهمك!
لنفترض أن لديك وكيلاً ذكياً لمساعدتك في الطهي. قاعدة المعرفة الخاصة به تحتوي على مئات الوصفات. سأله المستخدم: "أريد وصفة عشاء صحية وسريعة باستخدام الدجاج."
صف باختصار الخطوات الثلاث الرئيسية (استرجاع، تعزيز، توليد) التي سيقوم بها الوكيل باستخدام تقنية RAG للإجابة على هذا السؤال.
Show answer
- الاسترجاع (Retrieval): سيقوم الوكيل باستخدام البحث الدلالي للبحث في قاعدة بيانات الوصفات عن "عشاء صحي وسريع بالدجاج". سيجد أفضل الوصفات المطابقة للمعنى، مثل "دجاج مشوي بالليمون والأعشاب (20 دقيقة)" و"سلطة سيزر بالدجاج (15 دقيقة)".
- التعزيز (Augmentation): سيأخذ الوكيل تفاصيل هذه الوصفات ويضيفها كسياق إلى سؤال المستخدم الأصلي.
- التوليد (Generation): سيرسل الطلب المعزز إلى الـ LLM، الذي سيقوم بدوره بتوليد إجابة ودودة ومنظمة، مثل: "وجدت لك بعض الوصفات الصحية والسريعة بالدجاج! إليك واحدة سهلة: دجاج مشوي بالليمون والأعشاب. ستحتاج إلى صدور دجاج، ليمون، وزعتر. وقت التحضير حوالي 20 دقيقة. هل تود معرفة باقي التفاصيل؟"
خلاصة الدرس
اليوم، قمنا بربط المفاهيم معًا لفهم واحدة من أهم التقنيات في عالم وكلاء الذكاء الاصطناعي اليوم.
- المشكلة: نماذج اللغة الكبيرة لديها معرفة قديمة، ولا يمكنها الوصول إلى بيانات خاصة، وقد "تهلوس".
- الحل (RAG): هو نظام يتيح للنموذج اللغوي إجراء "امتحان كتاب مفتوح" عن طريق البحث في مصدر معرفة خارجي قبل الإجابة.
- الآلية: تتكون من ثلاث خطوات رئيسية: استرجاع المعلومات ذات الصلة باستخدام البحث الدلالي، ثم تعزيز سؤال المستخدم بهذه المعلومات، وأخيرًا توليد إجابة دقيقة ومستندة إلى مصدر.
- الفوائد: الحصول على إجابات محدّثة، والقدرة على استخدام بيانات خاصة، وتقليل الأخطاء، وزيادة ثقة المستخدم.
ماذا بعد؟
لقد تعلمنا الآن كيف يمكن لوكيلنا أن يتذكر المعلومات (عبر قاعدة بيانات)، وكيف يبحث فيها بذكاء (عبر البحث الدلالي)، وكيف يستخدم ما يجده للإجابة على الأسئلة (عبر RAG).
في الدرس القادم، سنتناول تحديًا آخر يتعلق بالذاكرة: كيف يتعامل الوكيل مع المحادثات الطويلة جدًا التي قد لا تتسع كلها في "نافذة السياق" المحدودة للنموذج اللغوي؟ سنتعلم كيف يمكننا تنفيذ استراتيجية لتلخيص المحادثات الطويلة للحفاظ على أهم المعلومات دون فقدان السياق.