你好。上一课我们从单个 decoder-only Transformer 块的静态结构出发,追踪了注意力和 MLP 如何保持主接口 ,并区分了块内主要权重。现在把这个“静态块”放到时间线上:一次训练更新究竟做了什么、梯度何时产生、权重何时改变,以及分布式环境中的通信到底插在何处。
本课将以一次 optimizer step为边界,先建立单卡训练迭代,再将它扩展到同步数据并行(DDP)和全分片数据并行(FSDP)。这套时间线是后续判断 5T MoE 训练的显存峰值、通信暴露时间和硬件能力缺口的共同坐标系。
训练迭代的边界:一次更新,不只是一次前向
把模型参数记为 ,其中下标 表示第 次参数更新后的版本。一次标准训练迭代接收一个批次数据,最终产生下一版本参数 。
以语言模型为例,数据加载器提供 token、标签和有效 token 掩码。对每个 rank 的局部 micro-batch,输入通常是:
模型前向产生词表 logits:
其中 是词表大小。交叉熵损失将 logits、标签和掩码归约为标量,作为反向传播的起点。
从控制流看,一个更新步至少包括:
- 准备数据与清理旧梯度:取得局部 batch,将数据送入设备;清空或覆写上一步遗留的梯度。
- 前向传播(forward):用当前参数 计算 logits 与损失 ,同时记录反向所需的信息。
- 反向传播(backward):从损失出发,应用链式法则计算各参数梯度。
- 梯度同步或分片归约:如果参数或梯度跨设备分布,确保每个参数更新使用语义正确的全局梯度。
- 优化器更新(optimizer step):由梯度及优化器状态生成 。
- 进入下一步:新数据必须使用一致的、已完成更新的参数版本。
需要区分两个常被混用的术语:
- micro-step:一次局部前向加反向,未必更新参数;
- optimizer step:真正调用优化器、改变参数版本的一次更新。
大模型通常使用梯度累积:连续执行 个 micro-step,再做一次 optimizer step。本课先按最简单情况讨论,即每次前向和反向后立即更新;之后只需把前向与反向阶段重复 次,更新阶段仍只发生一次。
前向:从 token 到损失,也是在保存“反向凭据”
前向传播不是简单地“算出一个结果”。它沿模型结构的正向顺序执行计算,并为后续梯度计算保留必要的中间信息。
对于由 个 Transformer 块构成的 decoder-only 语言模型,可以将主路径写为:
其中,第 层的计算可概括为:
前一课已经展开过块内部结构:归一化、QKV 投影、注意力、输出投影、残差、MLP 和第二条残差。这里应从训练执行视角补充两个事实。
前向阶段实际做的三件事
第一,读取并物化当前需要的权重。
在单卡或普通 DDP 中,每张设备有完整模型副本,线性层可直接读取本地权重。FSDP 则不同:设备通常只保存参数分片,执行某层之前必须先通过通信临时恢复该层完整权重。后面会详细解释。
第二,执行算子并产生激活。
例如,注意力需要 Q、K、V 与相应的上下文结果;MLP 需要中间隐层激活。它们中的一部分会被保留,因为反向传播计算参数梯度时不能只知道最终损失。
第三,构建自动微分图。
在 PyTorch eager 模式中,前向执行时 autograd 会记录“这个输出由什么算子、哪些输入和参数产生”。这不是一张抽象的训练示意图,而是反向阶段遍历依赖关系的依据。
因此,前向结束时,系统不只有一个损失标量,还持有:
- 当前参数 ;
- 前向激活及可能的重计算信息;
- 用于反向传播的计算依赖;
- 与局部数据对应的损失或未归约损失统计。
对于变长样本或 padding 较多的语言模型,损失归约的分母必须明确。若希望每个有效 token对全局损失权重相同,就不能仅因为每张卡的序列数相同而简单平均各 rank 的 loss;必须按有效 token 数进行正确加权。这一细节会直接影响分布式梯度是否等价于全局 batch 的梯度。
反向:按相反方向传播导数,并让梯度逐层“就绪”
损失计算完成后,调用:
loss.backward()
反向传播从标量损失开始,沿前向计算图的反方向执行。对于 Transformer,它大致按如下顺序回溯:
对任意参数张量 ,反向的目标是计算:
以线性层为例,若前向局部写作:
并且上游已经给出:
则反向会形成两个关键结果:
第一个结果是参数梯度,供优化器更新 ;第二个结果是输入激活的梯度,需要继续传回更早的层。残差连接的反向尤其直观:梯度会分别沿残差直通路径和子层路径累加。
这解释了为什么反向不是“再做一次前向”:
- 它以相反的层顺序运行;
- 它既要计算参数梯度,也要计算激活梯度;
- 它依赖前向保存的激活或重计算结果;
- 它在分布式训练中通常是最密集的梯度通信发起阶段。
在 PyTorch 中,当某个参数的梯度被写入 .grad 时,该参数的梯度就称为 ready。这个时刻非常重要:分布式引擎不必等所有参数的梯度都就绪后才开始通信,可以立即对已经就绪的一组梯度启动集合通信。
同步数据并行:副本独立前反向,梯度一致后再更新
设数据并行组大小为 。每个 rank 持有同一份完整参数:
全局 batch 被切成 份。若各 rank 的局部损失为 ,且每份数据具有相同权重,则全局目标可表示为:
于是每张卡先独立计算局部梯度:
之后通过 AllReduce 求和,并按 取平均:
AllReduce 结束后,每个 rank 都拥有相同的完整梯度 。
为什么同步的是梯度,而不是每一步同步参数?
普通 DDP 的常见做法是:
- 每个 rank 用不同局部数据独立前向;
- 每个 rank 独立反向,得到局部梯度;
- 对梯度 AllReduce;
- 每个 rank 用相同梯度、相同优化器规则更新本地完整参数副本。
以 SGD 为例:
所有 rank 在更新前参数相同,更新时梯度相同,学习率 相同,因此更新后仍得到相同的 。
对 Adam 一类优化器,情况也一样,只是每个参数还维护一阶与二阶矩状态:
只要所有 rank 的初始参数、优化器状态和同步后的梯度一致,各自独立执行 Adam 更新后,参数与状态仍然一致。
因此,DDP 的正确性不依赖于“谁来统一更新参数”;关键在于每个 rank 在每一步更新前看到相同的梯度。
Stanford CS231N | Spring 2025 | Lecture 11: Large Scale Distributed Training
观看 Stanford Online 的《Stanford CS231N | Spring 2025 | Lecture 11: Large Scale Distributed Training》。这两段将同步数据并行与 FSDP 放在同一条训练迭代时间线上,有助于把“本地计算”和“集合通信”区分清楚。
先观看 数据并行流程。重点观察全局 batch 如何切分为局部 batch、每张设备何时独立完成前向与反向,以及 AllReduce 为什么必须发生在更新前。接着观看 FSDP 生命周期,重点比较完整模型副本与参数分片下,权重和梯度分别在哪个时刻需要通信。
DDP 中的通信为什么主要出现在反向阶段?
最朴素的实现会在本地反向结束后,一次性同步所有参数梯度:
forward -> backward -> AllReduce(all gradients) -> optimizer step
这在语义上正确,却往往性能很差:所有通信暴露在反向之后,设备只能等待。
更好的 DDP 执行方式是将多个参数梯度组成 bucket。当一个 bucket 中的全部梯度 ready 时,立刻异步启动该 bucket 的 AllReduce:
backward compute bucket 3  -> AllReduce(bucket 3)
backward compute bucket 2  -> AllReduce(bucket 2)
backward compute bucket 1  -> AllReduce(bucket 1)
wait for remaining collectives -> optimizer step
这形成计算与通信重叠:
- 反向正在为较早层计算梯度;
- 较晚层已完成的梯度 bucket 同时在网络上传输和归约;
- 真正拖慢 step 的,是无法被反向计算隐藏的那部分通信,即暴露通信时间。
这里的异步并不改变同步 SGD 的数学语义。它只改变通信的发起时刻;在 optimizer.step() 前,所有需要的梯度归约仍必须完成。
FSDP:通信从“同步完整梯度”扩展为“按需物化权重与归约梯度”
普通 DDP 的限制是:每张卡保存完整参数、完整梯度以及完整优化器状态。对于目标中的 5T 总参数模型,这种完整复制不可能长期成立。因此 FSDP 的核心策略是沿数据并行组分片保存模型状态。
假设某参数张量为 ,FSDP 设备 常驻保存其本地分片:
而不是完整 。这改变了一次训练迭代中通信发生的位置。
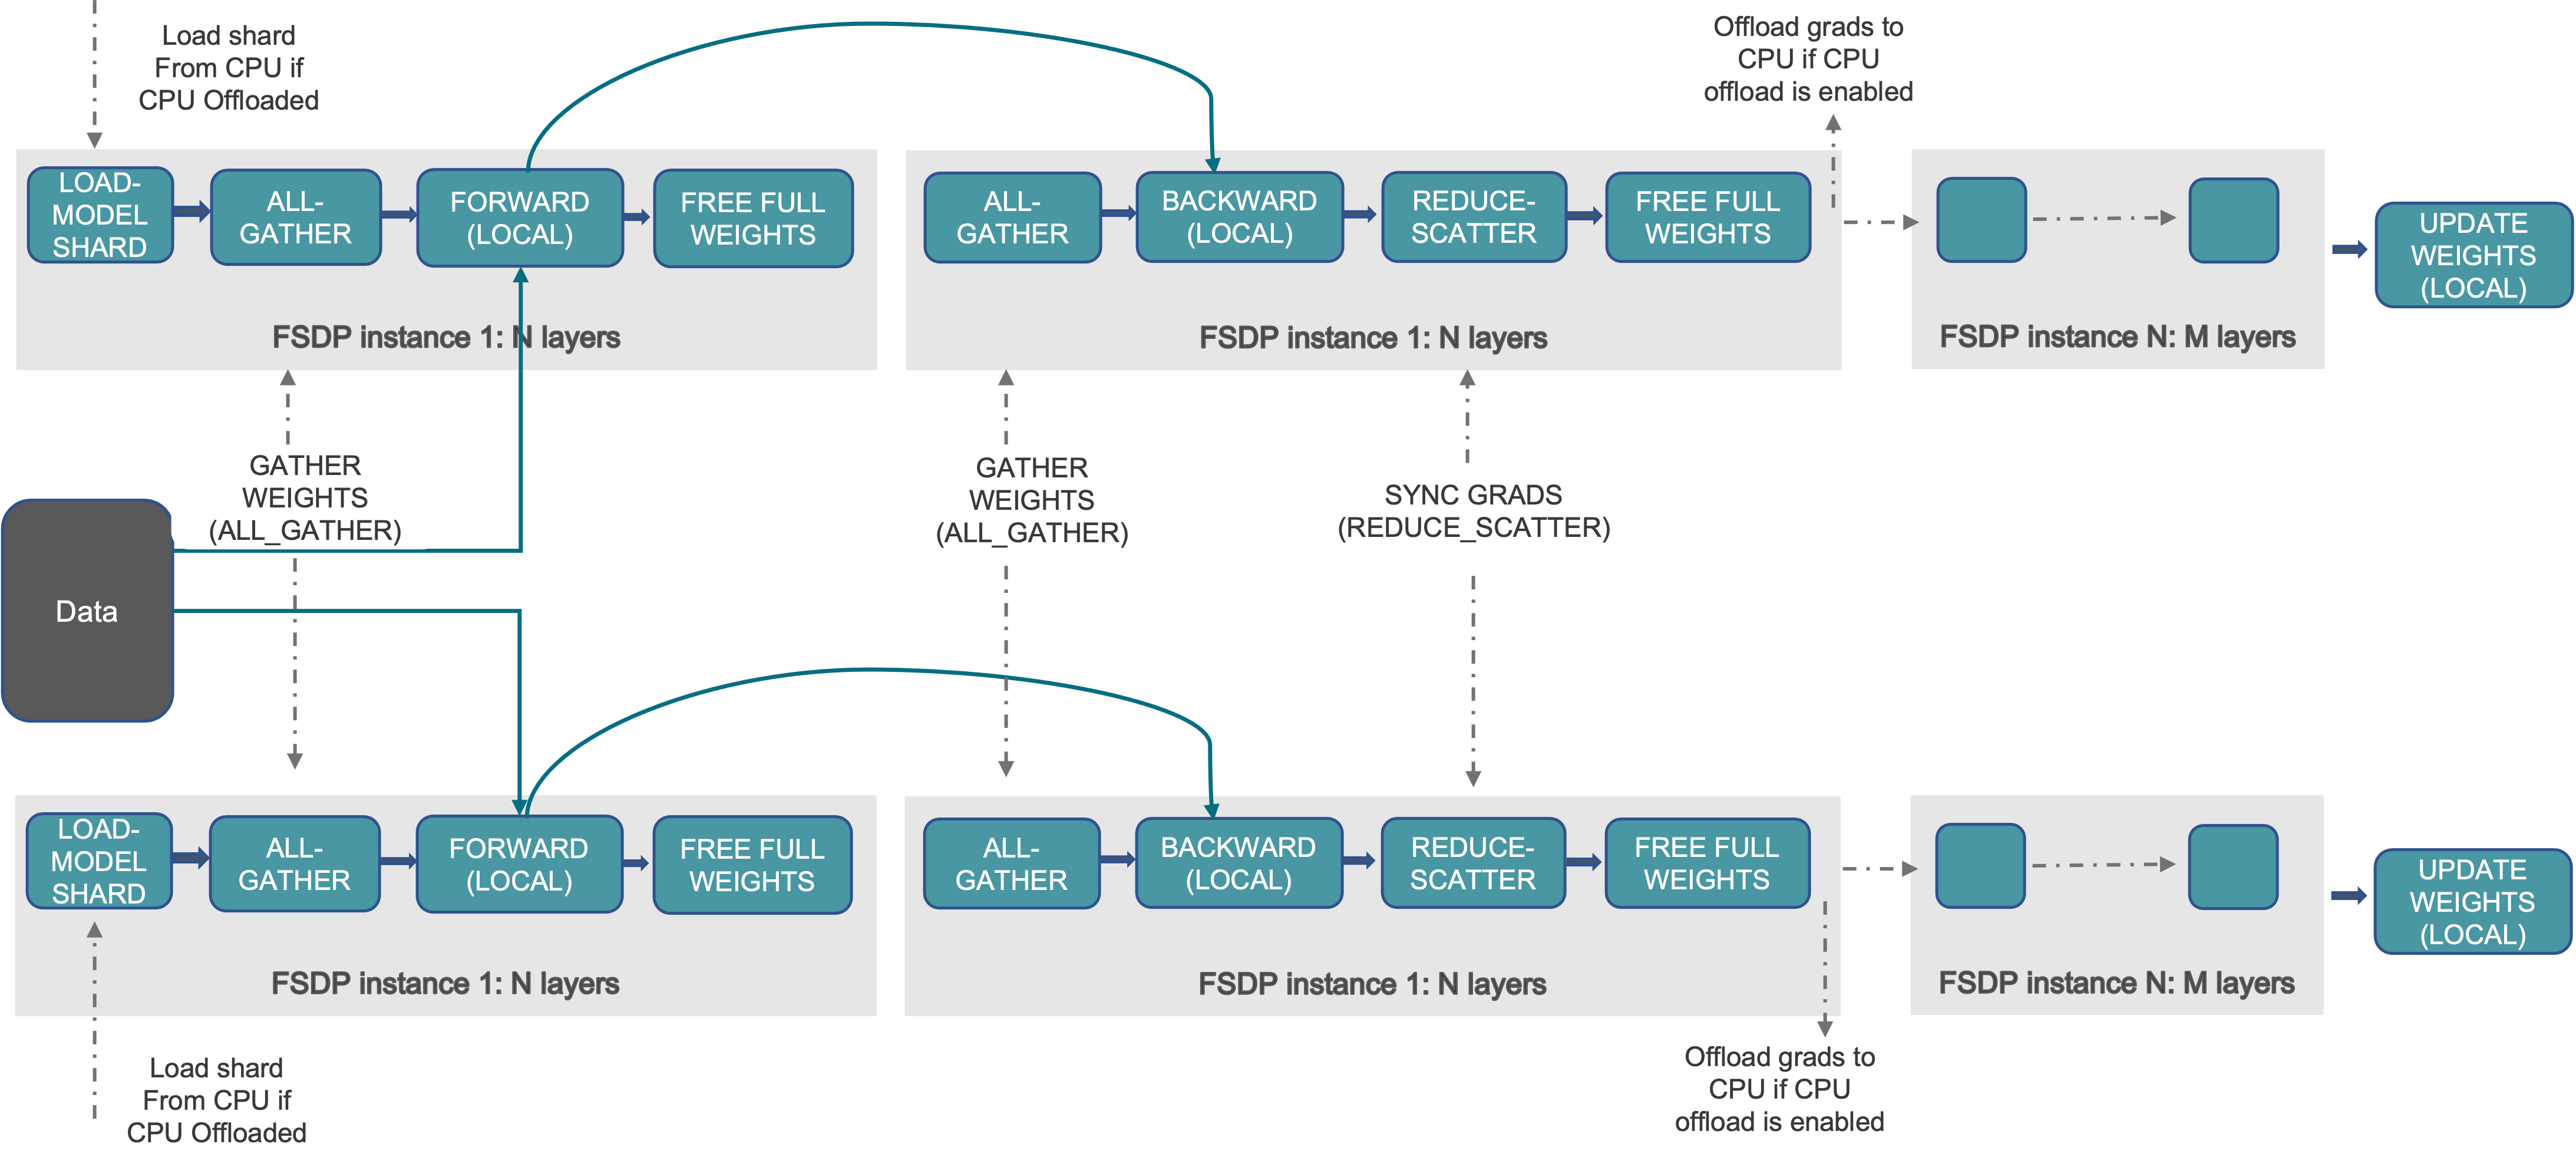
以一个 FSDP 通信组覆盖若干 Transformer 层为例,其基本生命周期是:
保存参数分片
    -> AllGather 参数分片,临时得到完整权重
    -> 前向计算
    -> 可选:释放完整权重
    -> 如已释放,则再次 AllGather
    -> 反向计算
    -> ReduceScatter 梯度
    -> 释放完整权重
    -> 更新本地参数与优化器状态分片
这里有两个必须准确区分的集合通信。
| 集合通信 | 输入状态 | 输出状态 | 在 FSDP 中的目的 |
|---|---|---|---|
| AllGather | 每张卡持有不同参数分片 | 每张卡临时获得完整参数 | 让本层前向或反向能够使用完整权重 |
| ReduceScatter | 每张卡持有本地计算得到的完整梯度贡献 | 每张卡获得归约后的梯度分片 | 同步全局梯度,同时避免复制完整梯度 |
普通 DDP 使用 AllReduce,是因为每张卡都需要完整梯度来更新完整参数副本。FSDP 使用 ReduceScatter,是因为每张卡只需更新自己持有的参数分片。
在 FSDP 中,优化器也应绑定这些参数分片及其对应的状态分片。更新的语义仍是全局同步的:某个参数分片的梯度已经在整个数据并行组上正确归约,只是没有再被复制回每一张设备。
torch.distributed.fsdp.fully_shard — PyTorch 2.13 documentation
阅读 PyTorch 的 FSDP fully_shard 文档中的高层生命周期说明。它用 hook 的视角说明:为什么 FSDP 的通信会发生在前向和反向附近,而不是像朴素 DDP 那样只在反向结束后统一出现。
阅读页面开头的项目符号列表。重点追踪 参数生命周期:参数何时以分片形式常驻、何时临时变为完整张量、何时被释放。随后阅读关于 optimizer 的项目,确认优化器为何应作用于分片参数,而不是临时物化的完整参数。
FSDP 的两个峰值时刻
FSDP 节约的是常驻状态内存,不是让完整权重永远消失。每个 FSDP 通信组在执行时仍会有临时的完整参数物化,因此要在时间线上识别两类峰值:
- 前向峰值:完整参数、前向激活和临时通信缓冲区可能同时存在。
- 反向峰值:若前向后已重分片,反向需要再次物化完整参数;同时还可能存在激活、梯度和 ReduceScatter 缓冲区。
这也是 FSDP 包装粒度会影响性能的原因:
- 通信组太大:单次 AllGather 和 ReduceScatter 数据量大,临时峰值高,且较难与计算重叠;
- 通信组太小:通信调用次数增加,小消息延迟和调度开销上升;
- 以 Transformer 层为较自然的分组单位,通常更容易在“当前层计算”时预取“下一层权重”。
本课不要求你立刻选定 FSDP 分组策略,但应先能在 trace 中辨认:这是参数 AllGather 等待,还是梯度 ReduceScatter 等待? 两者需要的硬件与软件优化方向并不完全相同。
把一次训练 step 画成可诊断的时间线
下面是一条简化后的训练时间线。它忽略流水线并行和专家并行,只保留当前最重要的依赖关系。
真实系统中,通信并不总是位于反向结束之后:
- DDP:梯度 bucket 的 AllReduce 可在反向过程中启动;
- FSDP 前向:每个通信组计算前可能有 AllGather;
- FSDP 反向:可能同时发生下一组参数的 AllGather、当前组的反向计算和已完成组梯度的 ReduceScatter;
- 数据传输:下一批数据常可与当前 step 的计算重叠;
- 优化器更新:通常较短,但对大型参数或复杂优化器仍可能显著,且必须等相应梯度归约完成。
因此,性能分析不能把 profiler 中每一段通信时间简单相加。应记录通信是否被计算隐藏。一个适合系统评审的粗粒度分解是:
其中:
- :前向、反向和优化器内核的实际计算时间;
- :没有被并行计算遮蔽、直接延长 step 的通信时间;
- :数据未就绪、CPU 调度、内存分配或设备等待造成的空闲;
- :参数及优化器状态更新的时间。
这不是一个可以直接用所有 profiler 条目相加得到的公式,而是一种避免双重计时的归因方式:已与计算重叠的通信不应再次完整计入 step 的关键路径。
对未来 ASIC 平台,最小的训练 trace 至少应能区分下列事件:
| 事件类别 | 应记录的内容 | 诊断价值 |
|---|---|---|
| 数据阶段 | batch 就绪、Host-to-Device 复制开始与结束 | 数据供给是否拖慢设备 |
| 前向计算 | 每层或每个 FSDP 通信组的计算时间 | GEMM、注意力及融合算子效率 |
| 参数通信 | AllGather 发起、结束、实际等待时间 | FSDP 参数物化与预取效果 |
| 反向计算 | 各梯度 bucket 或层的 ready 时间 | 是否存在足够重叠窗口 |
| 梯度通信 | AllReduce 或 ReduceScatter 的发起、结束、等待 | 互联带宽、延迟与分桶问题 |
| 更新阶段 | 优化器状态读写、参数更新完成时间 | 状态访存与精度策略的影响 |
| 版本边界 | 更新完成、下一 batch 开始时间 | 端到端 step 吞吐 |
对于目前“高算力、低带宽”的目标硬件,不能只问“集合通信带宽有多少”。还必须问:
- AllGather 能否在下一层真正需要参数前完成?
- ReduceScatter 是否能被更早层的反向计算隐藏?
- 通信和 GEMM 并发时,是否争用 HBM、DMA 或片上网络资源?
- 小 bucket 的启动延迟,是否抵消了更早通信所带来的重叠收益?
这些问题会在后续并行策略与 Roofline 分析中转化为定量模型。
小结
一次 Transformer 训练更新的核心因果链是:
关键要点如下:
- 前向不仅计算 logits 和损失,也保存或记录反向传播所需的信息。
- 反向按前向的逆依赖方向执行,同时生成参数梯度与激活梯度。
- 在同步 DDP 中,每个 rank 对不同数据独立完成前向和反向;AllReduce 后每个 rank 得到相同全局梯度,再独立但一致地更新完整参数副本。
- 梯度 bucket 允许 DDP 在反向过程中启动 AllReduce,用计算隐藏部分通信。
- FSDP 将参数、梯度和优化器状态分片保存;它以 AllGather 临时物化当前层权重,并以 ReduceScatter 得到已同步的梯度分片。
- 性能分析关注的是通信的关键路径暴露时间,而不是把所有通信内核时长直接累加。
下一课将把这条执行时间线连接到显存账本:分别按权重、梯度、主权重和优化器状态的精度,计算模型状态的理论内存占用。