你好。这个模块先建立超大规模训练系统所需的“模型账本”:先能精确说清一个 Transformer 块里每个张量是什么形状、每类参数在哪里,后续才可以可靠地估算 5T MoE 的显存、计算量和通信量。
本课聚焦 decoder-only Transformer 的单个块。你将用一套统一的形状记号追踪因果自注意力、MLP、残差连接与归一化;同时区分它们的主要参数。这里以常见的 Pre-LN GPT 风格块为主线,因为它也是大规模训练实现中最常见的结构之一。
先建立张量契约
令:
- :micro-batch 中的序列数
- :每条序列的 token 数,即序列长度
- :模型隐藏维度(也常写作 )
- :注意力头数
- :每个注意力头的维度
- :MLP 中间层维度
通常有:
输入 token id 的形状是:
经过 token embedding 查表后得到:
decoder-only 模型还必须区分 token 的位置。若使用可学习的位置 embedding,则位置 embedding 的形状为:
它会沿 batch 维广播,与 token embedding 相加:
现代模型也常使用 RoPE 一类位置编码;无论位置机制不同,进入每个 Transformer 块的隐藏状态形状仍是:
这就是整个块最重要的接口契约。注意力、MLP、残差和归一化最终都必须维护这一外部形状,才能逐层堆叠。
矩阵方向约定:下文把激活写成行向量形式,如 ,因此权重写为“输入维度 输出维度”。PyTorch 的
nn.Linear在存储权重时使用“输出维度 输入维度”,两者只是转置约定不同,参数量完全一致。
一个 Pre-LN decoder 块的骨架
一个典型的 decoder-only Pre-LN 块可以概括为:
其中:
- :块输入,形状为
- :经过注意力残差后的中间状态,形状仍为
- :块输出,形状仍为
这里的关键不是公式的简洁,而是两条不可违反的工程约束:
- 残差相加的两侧形状必须完全相同。
- 注意力和 MLP 虽然内部会改变张量布局或中间维度,但输出必须投影回 。
这也是为什么注意力有输出投影,而 MLP 有“升维后再降维”的第二个线性层。
因果多头自注意力:从 到
注意力子层接收归一化后的输入:
1. 一次投影生成 Q、K、V
标准实现通常使用一个融合的 QKV 线性层:
其中:
所以融合投影的输出形状为:
沿最后一维切开后:
这一步有一个很实用的系统含义:虽然概念上有三次投影,但训练引擎通常把它实现为一次更大的 GEMM。对于 ASIC 算子库而言,融合 QKV 投影通常比三个独立小 GEMM 更有价值。
2. 分成多个注意力头
将隐藏维拆成 个头,每个头宽度为 :
同样地:
最后一次转置很重要:它将 head 维前置,使每个 head 的注意力计算能并行处理。
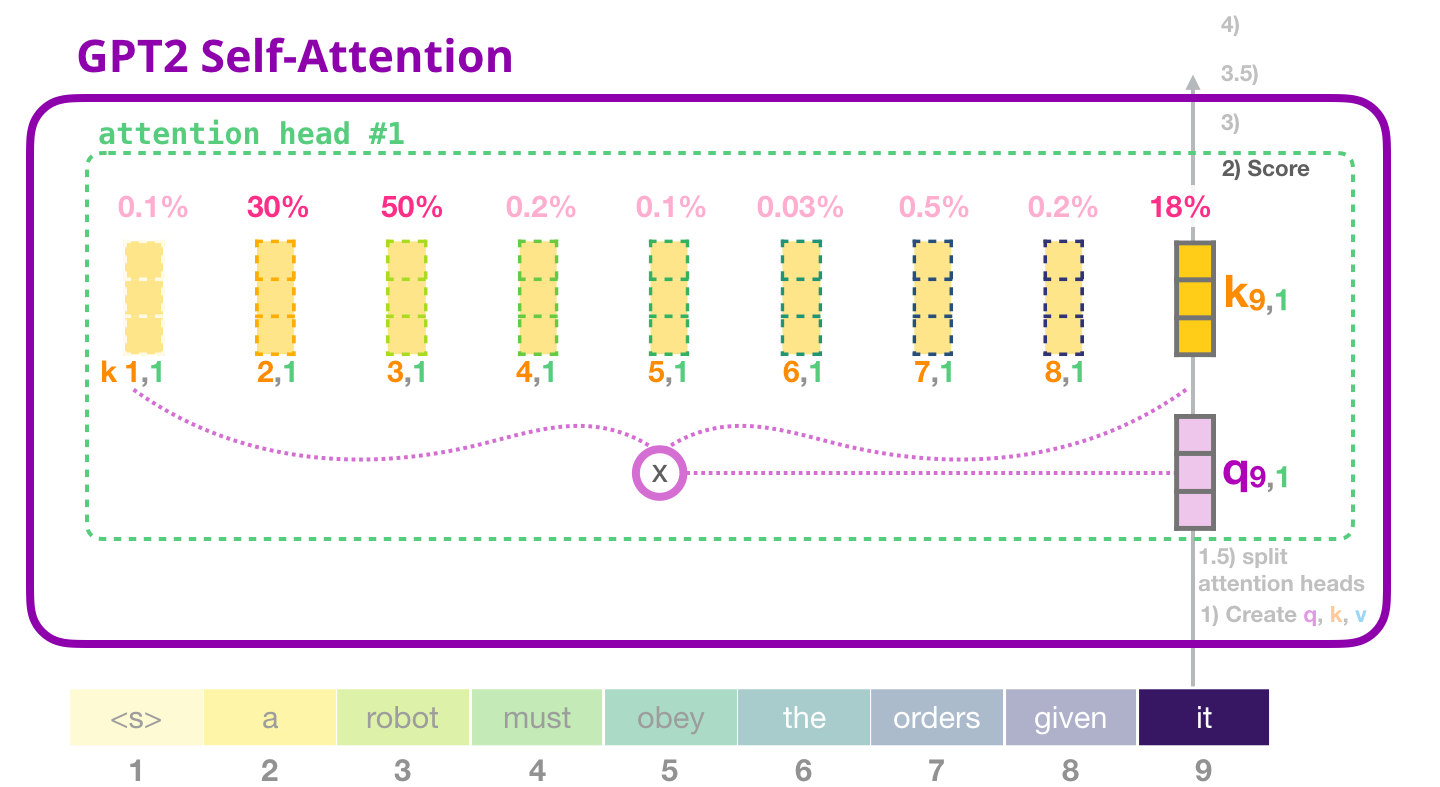
3. QK 打分与因果掩码
每个 head 的注意力分数为:
形状变化是:
其中最后两个 的含义不同:
- 倒数第二维:query 位置
- 最后一维:key 位置
所以 表示:第 条序列、第 个头中,位置 的 token 对位置 的 token 打出的相关性分数。
对于 decoder-only 模型,位置 不能访问未来位置 。因此在 softmax 前施加下三角因果掩码:
softmax 在最后一维,即 key 位置维度上执行。因此对任何固定的 ,都有:
图中的百分比正是某个 query 位置对各可见 key 位置的 softmax 权重。图里最后 token 的 query 会对先前 token 和自身的 key 评分;未来 token 不存在于它可见的集合中。
4. 用权重混合 Value
注意力权重作用于 value:
这里每个 token 得到的是一组 value 向量的加权和。换句话说,Q 和 K 决定“看谁”,V 提供“取什么内容”。
然后将所有 heads 拼接:
最后通过输出投影:
其中:
因此:
它终于可以与原来的 做残差相加。
Multi Head Attention in Transformer Neural Networks with Code!
观看 CodeEmporium 的《Multi Head Attention in Transformer Neural Networks with Code!》。它把 QKV 融合投影、reshape、因果掩码、attention-weighted value 和输出投影串成一段可对应 PyTorch 实现的张量轨迹。
从 QKV 投影 开始,注意输入的 batch、序列和隐藏维如何变成拼接的 QKV。接着看 分头与打分,重点核对为什么分头后会出现 (B,N_h,T,d_h) 与 (B,N_h,T,T)。 继续观看 因果掩码,确认 mask 必须在 softmax 前施加,以及被遮蔽位置为何不能影响输出。最后看 合并与投影,将每头输出、拼接和最终线性投影对应到本课的形状链路。
注意力的主要参数
忽略 bias 时,标准多头注意力的核心权重为:
| 参数 | 逻辑形状 | 参数量 |
|---|---|---|
| 融合 QKV 投影 | ||
| 输出投影 | ||
| 合计 | — |
若保留 bias,额外参数为:
注意:即使分成许多 attention head,若 固定,标准多头注意力的总投影参数量仍约为 。head 数主要改变内部张量组织、每头维度和计算划分,而不是这一组大矩阵的总大小。
MLP:逐 token 的非线性变换
注意力让一个 token 融合历史上下文;接下来的 MLP 则对每个位置的表示做同构的非线性变换。它不会在 token 维度上互相混合,因此给定输入:
标准 GPT-2 风格 MLP 为:
其中:
形状追踪如下:
经典 GPT 配置常取:
激活函数 在 GPT-2 中常为 GELU。许多较新的模型采用 gated MLP,例如 SwiGLU;其“门控分支”会改变参数常数,但其工程接口不变:输入仍为 ,输出必须回到 。
标准两层 MLP 的主要参数量为:
若 ,则:
这意味着在标准 dense Transformer 中,MLP 的权重通常约为注意力权重的两倍:
这件事直接连接到后续的 MoE:MoE 通常不是替换注意力,而是将此处的 dense MLP 替换或扩展为“路由器选择少数专家 MLP”。因此,先掌握 dense MLP 的输入、输出和参数账本,是理解专家参数、激活参数和 All-to-All token 分发的前提。
阅读 Jay Alammar 的《The Illustrated GPT-2》相关部分,将视觉化的单 token 叙述与本课的批量张量表达对应起来。它尤其适合巩固“QKV 如何产生、多个头如何合并、MLP 如何扩张和投影回来”这条主线。
在 “GPT-2 Masked Self-Attention” 的 “GPT-2 Self-attention: 1- Creating queries, keys, and values” 小节中,阅读 QKV 投影说明。将文中的单个 token 向量推广为本课的 (B,T,D) 张量。 接着在 “GPT-2 Self-attention: 3.5- Merge attention heads” 和 “GPT-2 Self-attention: 4- Projecting” 中阅读 head 合并与投影,关注为什么拼接后还需要一个 (D,D) 输出投影。 最后阅读 “GPT-2 Fully-Connected Neural Network: Layer #1” 至 “Layer #2 - Projecting to model dimension” 中的 两层 MLP。重点确认 MLP 先扩张隐藏维,再投影回模型维度,才能接回残差路径。
残差连接与归一化:为什么形状始终回到
残差连接
注意力输出回到模型维度后:
MLP 输出同样回到模型维度后:
从张量角度看,残差连接只是逐元素相加;但从优化角度看,它提供了信息和梯度的直接路径。一个块可以学习对表示做较小的增量修正,而不是每层都完全重建表示。
在框架设计中,残差也给出了一条明确的接口验收条件:任何自定义注意力、融合算子、MoE 子层或重计算实现,都必须返回与残差输入相同的 dtype、device 和 形状。
LayerNorm 与 RMSNorm
LayerNorm 对每个 token 的隐藏维 独立进行归一化;它不混合不同样本,也不混合不同 token 位置。
对一个 token 向量 ,LayerNorm 可写为:
其中 与 沿隐藏维计算,且:
所以 LayerNorm 不改变形状:
每个 LayerNorm 有 个可学习参数:缩放参数 和偏置参数 。一个块内有两个 LayerNorm,因此共计:
现代大语言模型常用 RMSNorm。它通常只保留缩放参数,且不减均值;但它同样逐 token、沿隐藏维归一化,输入输出形状也仍然是 。
Pre-LN 与 Post-LN
本课使用的是 Pre-LN:
即先归一化,再进入注意力或 MLP 子层,最后进行残差相加。与之相对,原始 Transformer 常见的 Post-LN 形式是:
两种布局的张量形状相同,但训练动力学不同。大规模 decoder-only 模型的工程实践中,Pre-LN 或其变种更加常见,因为残差路径更直接,有助于深层网络的梯度传播稳定性。
用一个小配置完整走一遍
设一个 GPT-2 small 风格的块:
因为:
则单个块的前向形状轨迹为:
| 阶段 | 张量形状 | 关键说明 |
|---|---|---|
| 块输入 | 8 个位置、每个位置 768 维 | |
| Norm 1 输出 | 不改变形状 | |
| 融合 QKV | ||
| 切分后 Q/K/V | 各为 | 最后一维切为三份 |
| 分头后 Q/K/V | 各为 | 12 个头,每头 64 维 |
| 注意力分数 | 每个 query 位置对可见 key 位置评分 | |
| 每头上下文输出 | 权重乘以 V | |
| 合并 heads | 恢复模型维度 | |
| 注意力输出投影 | 可执行第一次残差相加 | |
| Norm 2 输出 | 不改变形状 | |
| MLP 升维 | ||
| 激活后 | GELU 不改变形状 | |
| MLP 降维 | 可执行第二次残差相加 | |
| 块输出 | 送往下一层 |
该配置下,若包含线性层 bias 和两个 LayerNorm 的仿射参数:
- QKV 投影:
- 注意力输出投影:
- 注意力小计:
- MLP:
- 两个 LayerNorm:
- 单个 Transformer 块合计:
这里没有计入 token embedding、位置编码、最终归一化和词表输出头。它们属于模型整体结构,而不是重复堆叠的块内参数。
面向后续系统建模的三个观察
第一,形状是性能模型的起点。注意力分数的形状为:
其中的 会使长上下文注意力成为关键问题。对于目标中的 上下文,不能只看权重参数量;中间张量、注意力算法和并行策略同样会决定系统能否运行。
第二,标准 dense 块中 MLP 占据更多参数和大量 GEMM 计算。这正是 MoE 选择替换 MLP 的原因:模型可以拥有大量专家参数,但每个 token 只激活其中少数专家。
第三,块内的外部接口在 MoE 前后不变。即使将 dense MLP 替换成路由器和专家网络,整体仍要满足:
变化发生在块内部:token 被路由、重排、跨设备分发给专家,再被合并回来。后续讨论专家并行和 All-to-All 时,这个接口不应丢失。
小结
本课建立了 decoder-only Transformer 块的核心张量账本:
- 块的主接口始终是 。
- QKV 融合投影把 变为 ,分头后为 。
- 注意力分数的形状是 ,decoder 通过因果掩码禁止访问未来 token。
- 多头结果合并并经输出投影后回到 ,从而可做残差相加。
- 标准 MLP 沿隐藏维执行 ,常见 。
- Pre-LN 中,两个归一化层各自保持形状不变;残差连接要求子层输出严格回到 。
- 忽略较小的 bias 和归一化参数时,标准注意力约有 参数,标准 宽度 MLP 约有 参数。
下一课将把这个静态块展开成一次训练迭代:前向、反向、优化器更新,以及这些阶段何时需要通信。