Bonjour ! Bienvenue dans cette nouvelle leçon sur la performance de nos algorithmes.
Introduction
Dans la leçon précédente, nous avons appris à évaluer l'efficacité d'un algorithme en comptant ses opérations élémentaires. Cela nous a permis d'obtenir une fonction de coût précise, comme , qui décrit le nombre exact d'opérations en fonction de la taille des données n.
Cependant, comme nous l'avons évoqué, ces formules exactes peuvent être complexes à calculer et contiennent des détails qui, en pratique, sont peu importants. Est-ce que le "+2" dans a un réel impact lorsque n devient très grand ? La réponse est non. Ce qui compte vraiment, c'est la manière dont le temps d'exécution augmente lorsque la taille des données explose.
L'objectif de cette leçon est de vous apprendre à utiliser la notation Big O (grand O). C'est l'outil standard utilisé par tous les développeurs pour décrire et comparer la croissance du temps d'exécution des algorithmes. Maîtriser cette notation est fondamental pour atteindre votre but : écrire du "code clean" et, surtout, performant.
1. De la fonction de coût à la notation Big O
Imaginez que l'analyse d'un algorithme nous donne la fonction de coût suivante :
Quand n est petit, disons n=10, chaque terme a son importance :
Le coût total est de 260.
Maintenant, que se passe-t-il si n est grand, disons n=1 000 000 ?
- (deux mille milliards)
- (cinq millions)
Le terme est si énorme qu'il rend les autres termes (5n et 10) complètement négligeables. L'essentiel de la performance de l'algorithme est dicté par son terme qui croît le plus vite.
La notation Big O est une manière de formaliser cette idée en se concentrant sur l'ordre de grandeur de la croissance pour de grandes valeurs de n. On parle de complexité asymptotique.
Pour trouver la notation Big O à partir d'une fonction de coût, on applique deux règles simples :
- Garder uniquement le terme dominant : C'est le terme qui croît le plus rapidement. Dans , le terme dominant est .
- Supprimer les constantes multiplicatives : Le facteur
2dans dépend souvent de la machine ou de détails d'implémentation. Ce qui nous intéresse, c'est la nature de la croissance, ici en . On le supprime donc.
Ainsi, la fonction de coût se simplifie en . On lit "complexité en O de n au carré".
2. Comprendre les ordres de grandeur avec une histoire
Pour vous familiariser avec différentes "familles" de complexité, rien de tel qu'une petite histoire. Je vous invite à lire le texte suivant qui, à travers une analogie avec des cadenas, illustre brillamment comment des approches différentes peuvent avoir des performances radicalement opposées.
Calculez la complexité algorithmique
L'article "Calculez la complexité algorithmique" d'OpenClassrooms utilise une excellente analogie pour introduire les concepts de complexité exponentielle, linéaire et constante. C'est une introduction très intuitive à la notation Big O.
Lisez le début de l'article, depuis l'introduction jusqu'à la section "La complexité en temps constant" incluse. Concentrez-vous sur les trois stratégies pour ouvrir le cadenas et la notation Big O qui leur est associée.
Ce que cette histoire nous apprend :
- La méthode "brute-force" (tester toutes les combinaisons) est de complexité exponentielle, . Ajouter un seul chiffre au cadenas multiplie le temps par 10. C'est une très mauvaise stratégie, qui devient très vite irréalisable.
- La méthode "intelligente" de Bill (trouver les chiffres un par un) est de complexité linéaire, . Si on double le nombre de chiffres, on double approximativement le temps. C'est beaucoup plus raisonnable.
- La méthode "radicale" de Jack (casser le cadenas) est de complexité constante, . Le temps nécessaire ne dépend absolument pas du nombre de chiffres. C'est l'idéal en termes d'efficacité.
L'article mentionne aussi la complexité spatiale, qui mesure l'espace mémoire utilisé par un algorithme. C'est un concept similaire, mais pour le reste de ce module, nous nous concentrerons sur la complexité temporelle (le temps d'exécution).
3. Les grandes familles de complexité
Maintenant que vous avez une intuition, systématisons les choses. Il existe plusieurs grandes "classes" de complexité Big O. Nous allons les passer en revue, de la plus efficace à la moins efficace.
L'article ci-dessous détaille chacune de ces complexités. Nous allons résumer les points clés, mais n'hésitez pas à le consulter pour plus de détails et des exemples concrets.
Notations Grand O (Big O) : Guide des complexités algorithmique
L'article "Notations Grand O (Big O) : Guide des complexités algorithmique" fournit un excellent catalogue des principales classes de complexité, avec des explications et des exemples pour chacune.
Parcourez les sections de "Complexité O(1)" à "Complexité O(2ⁿ)". Pour chaque section, essayez de comprendre l'idée principale : comment le temps d'exécution évolue-t-il par rapport à la taille de l'entrée n ? Les exemples de code sont en Python, concentrez-vous sur la logique de l'algorithme plutôt que sur la syntaxe.
Voici un résumé des complexités les plus courantes, avec des exemples en pseudo-code.
| Notation Big O | Nom | Description | Exemple simple |
|---|---|---|---|
| Constant | Le temps d'exécution est toujours le même, peu importe la taille de l'entrée n. |
Accéder à un élément d'un tableau par son index : valeur <- MonTableau[5] |
|
| Logarithmique | Le temps d'exécution augmente très lentement. L'algorithme divise le problème par une constante à chaque étape. | Recherche dichotomique dans un tableau trié (nous l'étudierons bientôt). | |
| Linéaire | Le temps d'exécution est proportionnel à la taille de l'entrée. Si n double, le temps double. |
Parcourir tous les éléments d'un tableau avec une seule boucle. | |
| Linéarithmique | Un peu plus lent que linéaire. Souvent trouvé dans les algorithmes de tri efficaces qui "divisent pour régner". | Tri fusion ou tri rapide (nous les verrons plus tard). | |
| Quadratique | Le temps d'exécution est proportionnel au carré de n. Si n double, le temps est multiplié par 4. |
Parcourir un tableau avec deux boucles imbriquées. | |
| Exponentiel | Le temps d'exécution double à chaque nouvel élément ajouté. Devient très vite inutilisable. | Calcul naïf de la suite de Fibonacci de manière récursive. | |
| Factoriel | La pire des complexités. Le temps d'exécution explose de manière astronomique. | Résoudre le problème du voyageur de commerce en testant tous les chemins. |
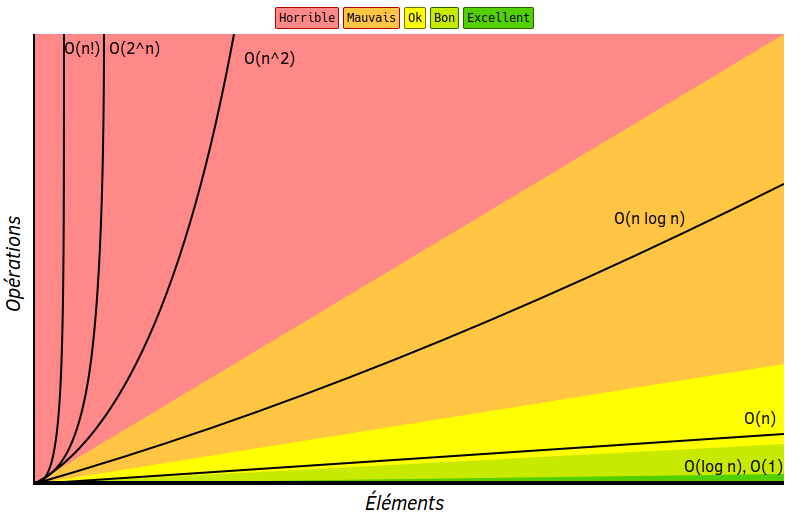
Pour visualiser à quel point ces croissances sont différentes, regardez le graphique suivant. Il montre clairement pourquoi on préfère un algorithme en à un algorithme en quand on traite beaucoup de données.
4. Application pratique
Revenons à l'exercice de l'article d'OpenClassrooms pour consolider notre compréhension. Il analyse trois algorithmes.
Calculez la complexité algorithmique
Pour mettre en pratique ce que nous venons d'apprendre, analysons ensemble les exercices proposés dans l'article d'OpenClassrooms.
Lisez la section "À vous de jouer" et la "Vérification de votre travail". Essayez de comprendre pourquoi chaque algorithme a la complexité Big O qui lui est attribuée.
Analysons rapidement les solutions :
-
Algorithme
déplacement: Il ne contient aucune boucle qui dépende de la taille d'une donnée d'entréen. Il exécute juste une série de conditions. Son temps d'exécution est donc constant. Complexité : . -
Algorithme
ramasser: Il contient une boucleTant Que. Dans le pire des cas, cette boucle s'exécutemax_déplacementfois, qui est défini comme30n. Le coût est donc proportionnel àn. En appliquant nos règles, on ignore la constante30. Complexité : . -
Algorithme
tri: Il contient deux bouclesPourimbriquées, chacune allant jusqu'àtaille - 1(que l'on noten). Le corps de la boucle interne est donc exécuté environ fois. Complexité : .
C'est exactement ce que nous avons appris à faire dans la leçon précédente, mais maintenant nous avons un langage simple et standardisé pour exprimer le résultat !
Conclusion
Félicitations ! Vous venez d'acquérir l'un des outils les plus importants de l'arsenal d'un programmeur.
Points clés à retenir :
- La notation Big O décrit la croissance du temps d'exécution d'un algorithme lorsque la taille des données (
n) augmente. - Elle nous permet de nous concentrer sur l'essentiel en ignorant les constantes et les termes de plus bas niveau. On passe de à .
- Il existe une hiérarchie de complexités, des plus efficaces (vertes) aux moins efficaces (rouges) : < < < < < < .
- Connaître la complexité Big O d'un algorithme nous aide à prédire sa performance et à choisir la meilleure solution pour un problème donné.
Et après ?
Maintenant que vous comprenez le langage de la complexité, nous allons l'appliquer. Dans la prochaine leçon, nous allons analyser et classer les algorithmes que nous avons déjà étudiés ou que nous allons bientôt étudier (comme la recherche linéaire, la recherche dichotomique et les tris simples) en utilisant leur notation Big O. Cela rendra leurs différences de performance concrètes et vous aidera à comprendre pourquoi on choisit un algorithme plutôt qu'un autre.