Bonjour ! Dans la leçon précédente, nous avons appris à associer des algorithmes spécifiques (recherche, tris simples) à leur notation Big O correspondante. C'est une première étape cruciale. Mais à quoi sert vraiment cette notation ?
Aujourd'hui, nous allons répondre à cette question. L'objectif est de classer les algorithmes par ordre d'efficacité en se basant sur leur complexité Big O. C'est le cœur de l'analyse de complexité : utiliser ce langage pour comparer des solutions et faire des choix éclairés, une compétence essentielle pour atteindre votre but d'écrire du "code clean" et performant.
1. L'efficacité, une question d'approche
Pour un même problème, il existe souvent plusieurs algorithmes capables de le résoudre. Mais sont-ils tous équivalents ? Loin de là. L'efficacité d'un algorithme peut varier de manière spectaculaire en fonction de la stratégie qu'il emploie.
Pour bien sentir cette différence, commençons par une petite histoire qui illustre parfaitement comment une simple différence d'approche peut transformer un problème impossible en un jeu d'enfant.
Calculez la complexité algorithmique - OpenClassrooms
L'article "Calculez la complexité algorithmique" d'OpenClassrooms utilise une excellente analogie avec des cadenas pour introduire intuitivement les grandes familles de complexité. C'est une introduction parfaite à notre sujet du jour.
Lisez les trois premières parties de l'article : "La complexité exponentielle", "La complexité linéaire" et "La complexité en temps constant". Concentrez-vous sur la manière dont les trois stratégies pour ouvrir le cadenas correspondent à trois temps de résolution radicalement différents.
Cette histoire met en évidence trois grandes catégories :
- L'approche "brute force" (tester toutes les combinaisons) est exponentielle. Ajouter un seul chiffre rend le problème beaucoup, beaucoup plus long à résoudre.
- L'approche "intelligente" (écouter le "clic") est linéaire. Le temps de résolution augmente proportionnellement au nombre de chiffres. C'est bien meilleur.
- L'approche "radicale" (casser le cadenas) est constante. Le temps ne dépend plus du tout du nombre de chiffres. C'est la solution la plus rapide.
Cette idée de classer les stratégies est exactement ce que nous allons maintenant formaliser avec la notation Big O.
2. La hiérarchie des complexités Big O
La notation Big O nous permet de classer les algorithmes sur une échelle d'efficacité. Voici les classes de complexité les plus courantes, ordonnées de la plus efficace (la plus rapide) à la moins efficace (la plus lente) pour une grande quantité de données n.
Analysons cet ordre :
- (Constant) : Excellent. Le temps d'exécution ne dépend pas de la taille des données. Ex : Accéder à un élément d'un tableau par son index.
- (Logarithmique) : Excellent. Le temps d'exécution augmente très lentement. Doubler la taille des données n'ajoute qu'une petite quantité de travail. Ex : La recherche dichotomique.
- (Linéaire) : Bon. Le temps d'exécution est directement proportionnel à la taille des données. Ex : Parcourir tous les éléments d'un tableau (recherche linéaire).
- (Linéarithmique) : Assez bon. C'est la complexité des meilleurs algorithmes de tri que nous découvrirons bientôt (comme le tri fusion). C'est un peu plus lent que linéaire, mais reste très efficace.
- (Quadratique) : Médiocre. Le temps d'exécution croît très vite. Attention avec de grandes quantités de données ! Ex : Les tris simples (à bulles, par sélection, par insertion).
- (Exponentiel) : Très mauvais. Le temps d'exécution explose, même pour des petites valeurs de
n. Ces algorithmes deviennent très vite inutilisables en pratique. Ex : L'approche "brute force" du cadenas.
Un graphique est souvent plus parlant que des mots pour visualiser ces différences de croissance.
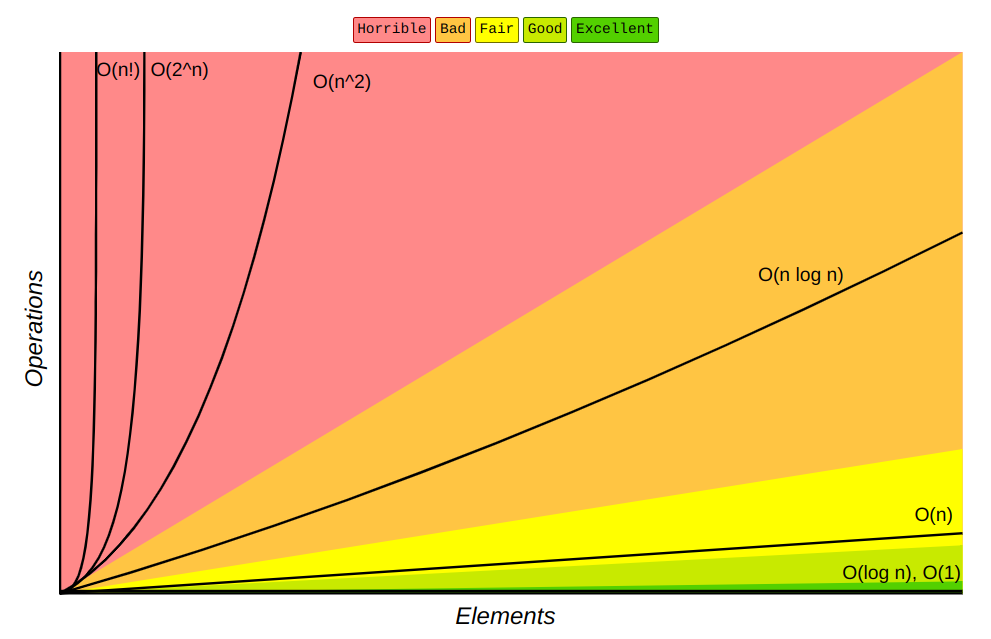
3. Quantifier l'impact : des chiffres pour comprendre
Pour rendre cette hiérarchie encore plus concrète, analysons comment le temps d'exécution évolue en chiffres. Le document suivant présente un tableau très éclairant qui compare les principales complexités.
Le document "Complexité algorithmique" de Florent Bouchez Tichadou contient un tableau parfait pour comparer l'efficacité des différentes classes de complexité. Il vous aidera à quantifier l'impact de chaque classe.
Lisez attentivement la section 3, "Comparer les complexités". Concentrez-vous sur le tableau qui présente les différentes complexités. Analysez chaque colonne : le nom, comment le temps évolue quand on double la taille de l'entrée, et surtout, la colonne "Max n" qui donne une idée de la taille maximale des données qu'un algorithme peut traiter dans un temps raisonnable.
Ce tableau est fondamental. Il nous apprend plusieurs choses :
- Un algorithme quadratique () devient impraticable autour de
n = 1 000 000(un million). - Un algorithme exponentiel () est déjà inutilisable pour
ndépassant à peine 30 ! - À l'inverse, un algorithme logarithmique () peut gérer des quantités de données astronomiques.
On distingue ainsi deux grandes familles :
- Les algorithmes polynomiaux (comme ) : leur complexité est de la forme . Ils sont considérés comme "efficaces" ou "traitables".
- Les algorithmes exponentiels (comme ) : Ils sont si lents qu'on ne peut les utiliser que pour de très petites tailles de données.
Votre objectif en tant que développeur sera presque toujours de trouver une solution polynomiale, et si possible, avec le plus petit exposant possible.
4. Exercice : Choisir le bon outil
Mettons cela en pratique. Vous travaillez sur une application de gestion de contacts. Votre base de données peut contenir jusqu'à 1 million de contacts (n = 1 000 000). Pour une nouvelle fonctionnalité, vous avez le choix entre plusieurs algorithmes existants.
Voici les algorithmes et leur complexité :
- Algorithme A : Un parcours simple de tous les contacts pour trouver ceux d'une ville donnée. Complexité : .
- Algorithme B : Un vieil algorithme de tri des contacts par nom, basé sur un tri par sélection. Complexité : .
- Algorithme C : Une fonction qui vérifie si un contact existe en utilisant son identifiant unique (qui correspond à son index dans le tableau). Complexité : .
- Algorithme D : Un algorithme avancé qui suggère des liens entre contacts en testant toutes les paires possibles de manière complexe. Complexité : .
- Algorithme E : Une fonction de recherche de contact par numéro de téléphone dans une liste déjà triée. Complexité : .
Votre tâche :
- Classez ces cinq algorithmes du plus efficace (plus rapide) au moins efficace (plus lent) pour
n = 1 000 000. - Pour chaque algorithme, indiquez s'il est "utilisable" ou "non utilisable" pour cette tâche, en vous justifiant avec ce que vous venez d'apprendre.
Cliquez ici pour voir la solution et la correction
-
Classement par ordre d'efficacité :
- Algorithme C () : Le plus rapide.
- Algorithme E () : Extrêmement rapide.
- Algorithme A () : Rapide et tout à fait acceptable.
- Algorithme B () : Très lent, probablement trop pour une bonne expérience utilisateur.
- Algorithme D () : Le plus lent, de très loin.
-
Analyse de l'utilisabilité :
- Algorithme C (utilisable) : Le temps d'exécution est instantané, quel que soit le nombre de contacts. C'est l'idéal.
- Algorithme E (utilisable) : est environ 20. C'est un nombre d'opérations minuscule. L'algorithme sera quasi instantané.
- Algorithme A (utilisable) : L'algorithme devra effectuer environ 1 million d'opérations. Sur un ordinateur moderne, c'est très rapide (quelques millisecondes).
- Algorithme B (non utilisable) : . Il s'agit de mille milliards d'opérations. Cela prendrait des heures, voire des jours. Inacceptable pour une application interactive.
- Algorithme D (non utilisable) : est un nombre si grand qu'il n'a aucun sens physique. Il faudrait plus de temps que l'âge de l'univers pour terminer le calcul. Absolument impossible.
Conclusion
Vous savez maintenant non seulement ce que signifie ou , mais aussi, et surtout, ce que cela implique en termes de performance.
Points clés à retenir :
- Les complexités Big O forment une hiérarchie claire : .
- Cette hiérarchie vous permet de comparer des algorithmes et de prédire leur comportement sur de grandes quantités de données.
- L'objectif est de toujours privilégier les algorithmes avec la plus faible complexité possible (constant, logarithmique, linéaire).
- Les algorithmes polynomiaux () sont considérés comme traitables, tandis que les algorithmes exponentiels () sont généralement impraticables.
Cette capacité à classer et à choisir des algorithmes en fonction de leur efficacité est une étape majeure vers la conception de programmes robustes et rapides.
Et après ?
Nous avons vu l'échelle des complexités et comment elle se traduit en termes de performance. Dans la prochaine leçon, nous nous pencherons plus en détail sur l'impact concret de la taille des données sur le temps d'exécution, en apprenant à faire des estimations simples mais puissantes.