Bonjour et bienvenue dans cette nouvelle leçon !
Introduction
Nous entamons aujourd'hui un nouveau module passionnant : "Algorithmes de Recherche et Tri". Après avoir maîtrisé les briques fondamentales de l'algorithmique (variables, conditions, boucles, tableaux, fonctions), nous allons maintenant les assembler pour construire des solutions à des problèmes parmi les plus courants en informatique. Savoir rechercher une donnée ou organiser un ensemble d'informations est au cœur de presque toutes les applications que vous utiliserez ou créerez.
Dans la leçon précédente, nous avons conclu notre exploration de la récursivité en analysant le risque de stack overflow. Vous avez appris qu'une conception rigoureuse est essentielle pour écrire des algorithmes robustes.
Aujourd'hui, nous allons aborder le premier de ces problèmes fondamentaux : la recherche. L'objectif est de mettre en œuvre l'algorithme le plus simple et le plus intuitif pour trouver un élément dans un tableau : la recherche linéaire. C'est le point de départ de tout notre parcours sur les algorithmes de recherche.
1. Le Problème de la Recherche
Imaginez que vous avez une étagère remplie de livres, mais qu'ils ne sont pas classés par ordre alphabétique. Si vous cherchez un livre en particulier, quelle est votre stratégie ? La seule méthode fiable est de commencer par le premier livre à gauche, de vérifier si c'est celui que vous cherchez, et si ce n'est pas le cas, de passer au suivant, et ainsi de suite, jusqu'à ce que vous trouviez votre livre ou que vous ayez inspecté toute l'étagère.
En algorithmique, c'est exactement le même problème. Étant donné un tableau (notre étagère de livres), comment retrouver la position (l'index) d'un élément spécifique (notre livre) ?
2. Le Principe de la Recherche Linéaire
L'approche que nous venons de décrire est précisément ce qu'on appelle la recherche linéaire (ou recherche séquentielle). C'est une méthode qui fonctionne sur n'importe quel tableau, qu'il soit trié ou non.
Le principe est simple :
- On commence au premier élément du tableau (à l'index 0).
- On compare cet élément à la valeur que l'on recherche.
- Si c'est la bonne valeur, la recherche est terminée ! On a trouvé l'élément et sa position.
- Si ce n'est pas la bonne valeur, on passe à l'élément suivant (index 1, puis 2, etc.).
- On répète ce processus jusqu'à ce qu'on trouve l'élément ou qu'on ait parcouru tout le tableau.
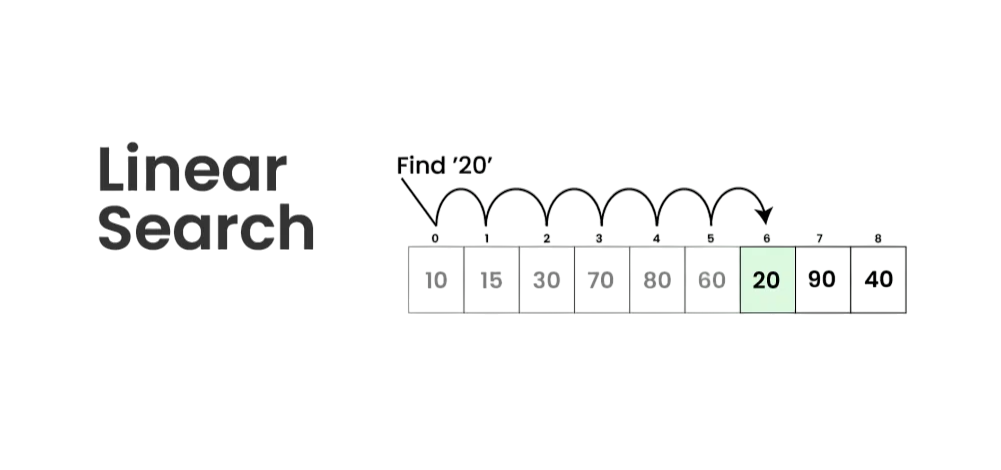
L'image suivante illustre parfaitement ce parcours séquentiel. Pour trouver la valeur 20, l'algorithme examine chaque case l'une après l'autre.
3. Algorithme de la Recherche Linéaire en Pseudo-code
Maintenant, traduisons cette logique en pseudo-code. Notre fonction prendra en entrée un tableau et la valeur à chercher, et devra retourner l'index de la valeur si elle est trouvée, ou une valeur spéciale (comme -1) pour indiquer qu'elle n'est pas dans le tableau.
Fonction Recherche_Lineaire(Tableau T, ValeurCherchee V) : Entier
DEBUT
    // On parcourt le tableau du début à la fin.
    POUR i ALLANT DE 0 A Longueur(T) - 1 FAIRE
        // À chaque étape, on compare l'élément actuel avec la valeur cherchée.
        SI T[i] = V ALORS
            // On a trouvé ! On retourne immédiatement l'index actuel.
            RETOURNER i
        FIN SI
    FIN POUR

    // Si la boucle se termine, cela veut dire qu'on a tout vérifié sans rien trouver.
    // On retourne -1 pour signaler l'échec de la recherche.
    RETOURNER -1
FIN
L'organigramme ci-dessous représente ce flux logique. Il vous aidera à visualiser les étapes et les décisions prises par l'algorithme.

Traçage Manuel
Pour bien vous approprier la logique, traçons l'exécution de cet algorithme, une compétence que nous avons déjà pratiquée.
Soit le tableau Notes = [12, 19, 10, 8, 15].
Cas 1 : On cherche la valeur 10
i = 0.Notes[0]est 12.12 ≠ 10. On continue.i = 1.Notes[1]est 19.19 ≠ 10. On continue.i = 2.Notes[2]est 10.10 = 10. Trouvé ! La fonctionRETOURNER 2. La boucle s'arrête.
Cas 2 : On cherche la valeur 14
i = 0.Notes[0]est 12.12 ≠ 14. On continue.i = 1.Notes[1]est 19.19 ≠ 14. On continue.i = 2.Notes[2]est 10.10 ≠ 14. On continue.i = 3.Notes[3]est 8.8 ≠ 14. On continue.i = 4.Notes[4]est 15.15 ≠ 14. On continue.- La boucle
POURest terminée. La ligneRETOURNER -1est exécutée. La valeur n'a pas été trouvée.
4. Explorer d'Autres Implémentations
Notre version avec une boucle POUR et un RETOURNER au milieu est très courante. Cependant, il existe d'autres manières d'écrire cette logique, par exemple avec une boucle TANT QUE. Explorer ces alternatives renforcera votre compréhension de la logique algorithmique.
Recherche dans un tableau non trié
Le document suivant, tiré du cours de R. Di Scala, présente plusieurs variantes de l'algorithme de recherche séquentielle en pseudo-code. C'est un excellent moyen de voir comment un même problème peut être résolu avec de légères variations dans la structure de contrôle.
Lisez la section "3.1 Recherche dans un tableau non trié". Observez les différentes versions proposées, notamment celles utilisant une boucle Tantque. Comparez-les à notre version avec la boucle Pour. Notez que l'indexation commence à 1 dans cet exemple, mais le principe reste identique.
5. Une Première Idée de l'Efficacité
La recherche linéaire est simple, mais est-elle efficace ?
- Dans le meilleur des cas, l'élément que l'on cherche est le tout premier du tableau. Il nous faut alors 1 seule comparaison.
- Dans le pire des cas, l'élément est le tout dernier, ou bien il n'est pas du tout dans le tableau. Si le tableau contient
néléments, il nous faudra fairencomparaisons.
Cela signifie que le temps d'exécution maximal de l'algorithme est directement proportionnel à la taille du tableau. Si un tableau de 1000 éléments prend 1 milliseconde à parcourir dans le pire des cas, un tableau de 2000 éléments prendra environ 2 millisecondes. On parle de croissance linéaire. C'est une notion que nous approfondirons dans un futur module, mais il est déjà important d'en avoir l'intuition.
6. Exercice d'Application
Il est temps de mettre en pratique ce que vous venez d'apprendre. Votre objectif est d'écrire un algorithme complet basé sur la recherche linéaire.
Problème : Vous organisez un événement et vous avez une liste d'invités. Vous devez créer un algorithme qui vérifie si une personne qui se présente à l'entrée est bien sur la liste.
Tâche : Écrivez une fonction en pseudo-code nommée Verifier_Invite.
- Entrées : Un tableau de chaînes de caractères
Liste_Inviteset une chaîne de caractèresNom_Personne. - Sortie :
VRAIsiNom_Personneest dansListe_Invites, etFAUXsinon.
Prenez quelques minutes pour y réfléchir et écrire votre solution.
Solution :
Fonction Verifier_Invite(Tableau de chaînes Liste_Invites, Chaîne Nom_Personne) : Booléen
DEBUT
    POUR chaque Nom DANS Liste_Invites FAIRE
        SI Nom = Nom_Personne ALORS
            RETOURNER VRAI
        FIN SI
    FIN POUR

    // Si la boucle se termine, le nom n'a pas été trouvé.
    RETOURNER FAUX
FIN
Cette solution est très proche de notre algorithme Recherche_Lineaire, mais elle retourne un booléen au lieu d'un index, ce qui correspond parfaitement à la question posée.
Conclusion
Félicitations ! Vous avez implémenté votre premier algorithme de recherche. C'est une étape majeure.
Points clés à retenir :
- La recherche linéaire (ou séquentielle) est une méthode pour trouver un élément dans un tableau en l'examinant du début à la fin.
- Elle est simple à mettre en œuvre et fonctionne sur des tableaux non triés.
- Son principe est de parcourir le tableau avec une boucle et de comparer chaque élément avec la valeur cible.
- Dans le pire des cas, son temps d'exécution est linéaire, c'est-à-dire proportionnel à la taille du tableau.
Et après ?
La recherche linéaire est fiable, mais devoir inspecter chaque élément un par un peut être très lent sur de grands ensembles de données. Ne pourrions-nous pas faire mieux ? Et si notre étagère de livres était triée par ordre alphabétique ? Vous n'auriez certainement pas besoin de tout regarder. Dans la prochaine leçon, nous explorerons justement pourquoi le tri préalable des données est la clé pour débloquer des algorithmes de recherche beaucoup plus rapides.