Bonjour ! J'espère que vous êtes prêt(e) pour une nouvelle leçon qui va révéler une astuce fondamentale en algorithmique.
Introduction
Dans notre leçon précédente, nous avons exploré la recherche linéaire, une méthode simple et universelle pour trouver un élément dans un tableau. Sa grande force est qu'elle fonctionne sur n'importe quel tableau, trié ou non. Son défaut, comme nous l'avons entrevu, est qu'elle peut être lente sur de grands ensembles de données car elle doit potentiellement vérifier chaque élément un par un.
Aujourd'hui, nous allons nous concentrer sur la condition essentielle qui permet de débloquer une méthode de recherche beaucoup plus puissante : la recherche dichotomique. L'objectif de cette leçon n'est pas encore d'apprendre à implémenter cet algorithme, mais de comprendre en profondeur pourquoi un tableau doit absolument être trié pour pouvoir l'utiliser. C'est en maîtrisant ce "pourquoi" que vous construirez la logique nécessaire pour écrire du code efficace, ce qui est au cœur de votre objectif.
1. L'idée clé : Exploiter l'ordre
Imaginez à nouveau votre étagère de livres. Dans la leçon précédente, ils étaient en désordre. Maintenant, imaginez qu'ils sont parfaitement classés par ordre alphabétique. Si vous cherchez le livre "Le Seigneur des Anneaux", allez-vous commencer par le premier livre (qui pourrait être "Alice au Pays des Merveilles") et les vérifier un par un ?
Probablement pas. Vous allez intuitivement ouvrir la bibliothèque vers le milieu, regarder un titre (par exemple, "Moby Dick"), et vous dire : "L est avant M, donc mon livre doit être dans la première moitié de l'étagère". D'un seul coup, vous venez d'éliminer la moitié de la recherche !
C'est exactement le principe de la recherche dichotomique (du grec dikho-tomia, "couper en deux"). Au lieu de parcourir les éléments un par un, on va directement au milieu du tableau et on compare l'élément qui s'y trouve avec celui que l'on cherche.
Cette comparaison nous donne trois possibilités :
- C'est l'élément que l'on cherche ! Parfait, la recherche est terminée.
- L'élément du milieu est plus grand que notre cible. Puisque le tableau est trié, nous avons la certitude que notre cible ne peut se trouver que dans la première moitié du tableau.
- L'élément du milieu est plus petit que notre cible. De la même manière, nous savons que notre cible ne peut être que dans la seconde moitié.
Ce pouvoir d'éliminer la moitié de l'espace de recherche à chaque étape est la clé de son efficacité. Mais, comme vous le voyez, cette déduction logique repose entièrement sur une seule et unique condition : le tableau doit être trié.
2. Le principe en action : une trace manuelle
Pour bien comprendre comment l'ordre est exploité, suivons un exemple pas à pas. L'article suivant illustre ce processus. Nous allons nous concentrer sur son raisonnement.
L'article "Algo Dichotomie" de Infoforall explique très clairement le principe de la recherche dichotomique. Nous allons nous baser sur son exemple pour notre analyse.
Pour le moment, lisez la section 2, "Principe de la recherche dichotomique". Concentrez-vous sur l'exemple où l'on cherche la valeur 40 dans le tableau. Suivez les étapes de raisonnement qui permettent d'éliminer une partie du tableau à chaque fois. Ne vous préoccupez pas encore du code Python.
Analysons ensemble la logique décrite dans la ressource :
Soit le tableau trié T = [06, 08, 09, 13, 18, 37, 37, 59, 60, 60, 61, 68, 70, 80, 80, 83, 83, 89, 91, 96].
Nous cherchons la valeur 40.
-
Étape 1 : L'espace de recherche est tout le tableau (indices 0 à 19).
- L'indice du milieu est
(0 + 19) // 2 = 9. L'élémentT[9]est60. - On compare notre cible (
40) à l'élément du milieu (60). - Constat :
40 < 60. - Déduction logique (permise par le tri) : Si
40existe dans le tableau, il se trouve forcément avant l'indice 9. Tous les éléments de l'indice 9 à 19 sont inutiles. - On réduit notre espace de recherche aux indices 0 à 8.
- L'indice du milieu est
-
Étape 2 : L'espace de recherche est maintenant
[06, 08, ..., 60](indices 0 à 8).- Le nouvel indice du milieu est
(0 + 8) // 2 = 4. L'élémentT[4]est18. - On compare
40à18. - Constat :
40 > 18. - Déduction logique : Si
40existe, il est forcément après l'indice 4 dans notre espace de recherche actuel. - On réduit notre espace de recherche aux indices 5 à 8.
- Le nouvel indice du milieu est
-
Étape 3 : L'espace de recherche est
[37, 37, 59, 60](indices 5 à 8).- Milieu :
(5 + 8) // 2 = 6.T[6]est37. 40 > 37. On continue la recherche dans la partie droite, aux indices 7 à 8.
- Milieu :
-
Étape 4 : L'espace de recherche est
[59, 60](indices 7 à 8).- Milieu :
(7 + 8) // 2 = 7.T[7]est59. 40 < 59. On devrait chercher dans la partie gauche. L'espace de recherche devient les indices 7 à 6.
- Milieu :
À ce stade, l'indice de début (7) est devenu plus grand que l'indice de fin (6). Cela signifie que l'espace de recherche est vide. Nous pouvons conclure que 40 n'est pas dans le tableau.
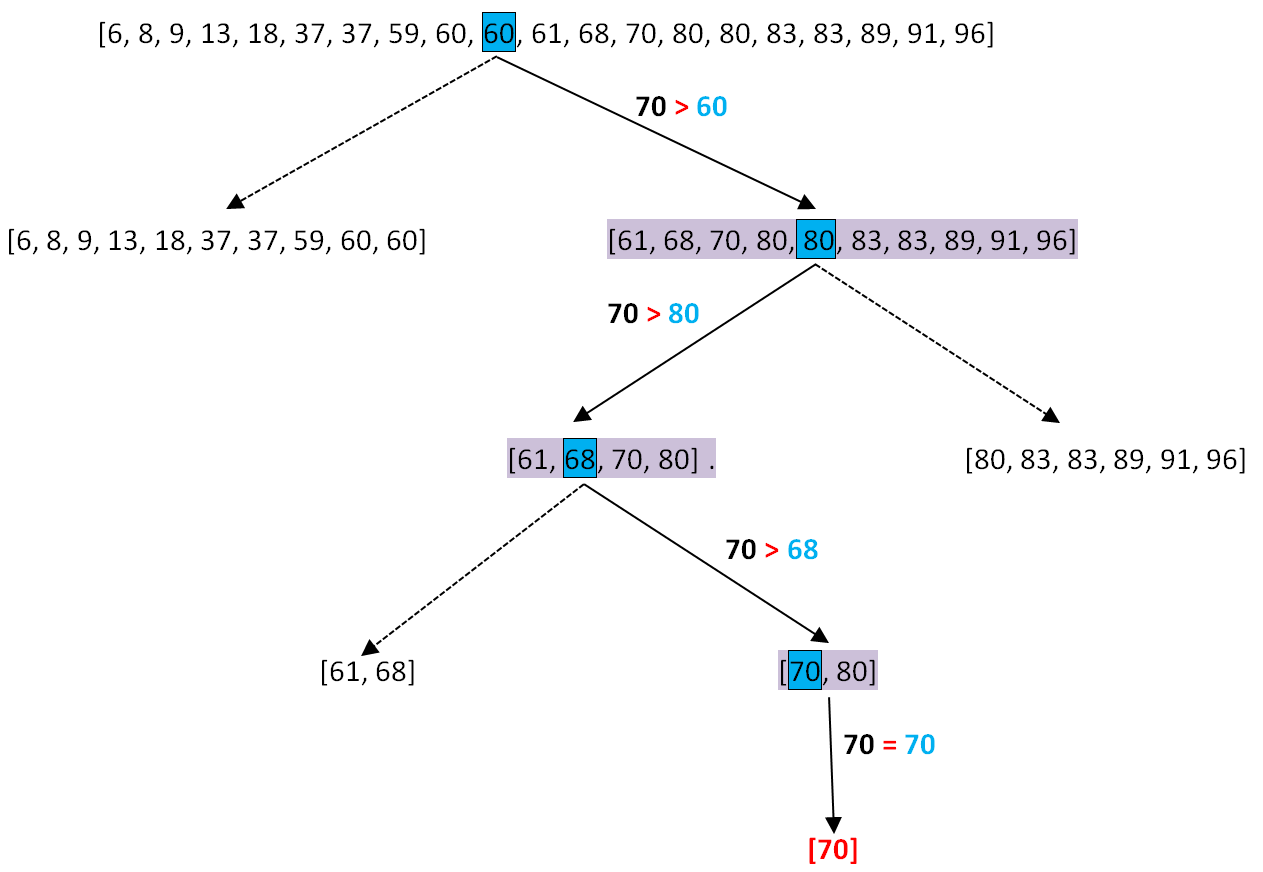
L'image suivante illustre ce même processus pour la recherche de la valeur 70.
3. Et si le tableau n'est pas trié ?
Maintenant, faisons une expérience de pensée pour bien ancrer le concept. Prenons les mêmes nombres, mais dans le désordre :T_desordre = [59, 08, 91, 13, 60, 37, 80, 89, 06, 96, 18, 68, 70, 37, 61, 83, 83, 80, 91, 13]
Nous cherchons toujours la valeur 40.
- Étape 1 : On prend l'élément du milieu, à l'indice 9.
T_desordre[9]est96.- On compare
40à96. Constat :40 < 96. - Question : Pouvons-nous éliminer la deuxième moitié du tableau ?
- Réponse : Absolument pas. Le nombre
80, par exemple, qui est plus grand que40, se trouve bien avant l'indice 9. Le nombre13, plus petit, se trouve après. L'ordre n'existant pas, la position de96ne nous donne aucune information sur le reste du tableau.
- On compare
La comparaison 40 < 96 est inutile. La seule conclusion possible est que l'élément à l'indice 9 n'est pas le bon. Il nous reste donc 19 autres cases à vérifier... ce qui nous ramène à la nécessité d'une recherche linéaire.
La lecture suivante résume parfaitement cette idée.
Recherche dichotomique - Informatique au lycée Mounier ANGERS
L'article "Recherche dichotomique" du Lycée Mounier énonce cette condition très directement.
Lisez l'introduction (jusqu'à "Peut-on faire mieux ? Oui, à condition que le tableau soit trié !") et la section "Spécification". Notez comment la précondition "T est trié par ordre croissant" est explicitement mise en avant comme une règle non négociable de l'algorithme.
4. Le compromis : trier d'abord, chercher ensuite
La recherche dichotomique est bien plus rapide que la recherche linéaire (nous le quantifierons dans un futur module), mais elle impose cette contrainte forte : le tableau doit être trié.
Que faire si nos données ne sont pas triées au départ ?
- On peut utiliser une recherche linéaire, plus lente mais qui fonctionne tout de suite.
- On peut d'abord trier le tableau, puis utiliser la recherche dichotomique.
Le tri est une opération qui a un coût. Elle prend du temps. Est-ce que cela vaut la peine de trier ?
- Si vous ne devez faire qu'une seule recherche : Il est souvent plus rapide de faire une simple recherche linéaire que de prendre le temps de trier tout le tableau pour ensuite y faire une unique recherche dichotomique.
- Si vous devez faire de très nombreuses recherches dans le même tableau : L'investissement en temps pour trier le tableau une bonne fois pour toutes au début est largement rentabilisé. Chaque recherche suivante sera quasi instantanée comparée à une recherche linéaire.
C'est un choix de conception important : le "meilleur" algorithme dépend du contexte d'utilisation.
Conclusion
Aujourd'hui, nous avons disséqué la logique fondamentale qui sous-tend la recherche dichotomique.
Points clés à retenir :
- La recherche dichotomique fonctionne sur le principe de "diviser pour régner", en coupant l'espace de recherche en deux à chaque étape.
- Ce mécanisme n'est possible que si le tableau est trié. L'ordre des éléments permet de déduire logiquement dans quelle moitié du tableau la recherche doit se poursuivre.
- Sur un tableau non trié, la recherche dichotomique est inapplicable, car la valeur d'un élément ne donne aucune information sur ses voisins. On est alors contraint d'utiliser une recherche linéaire.
- L'utilisation de la recherche dichotomique sur des données initialement non triées implique un compromis : le coût initial du tri doit être justifié par un grand nombre de recherches ultérieures.
Et après ?
Maintenant que vous avez parfaitement compris pourquoi le tri est une précondition, nous sommes prêts pour l'étape suivante. Dans la prochaine leçon, nous allons formaliser cette logique et implémenter l'algorithme de recherche dichotomique en pseudo-code. Vous verrez comment traduire les idées de "début", "fin" et "milieu" en variables et en instructions concrètes.