Bonjour ! J'espère que vous êtes prêt(e) à ajouter un troisième algorithme de tri à votre boîte à outils.
Introduction
Dans les leçons précédentes, nous avons exploré deux stratégies de tri distinctes :
- Le tri par sélection, qui trouve le plus petit élément du reste du tableau et le place au bon endroit.
- Le tri à bulles, qui compare et échange les éléments voisins pour faire "remonter" les plus grands.
Aujourd'hui, nous allons aborder le tri par insertion (insertion sort). Cette méthode est très intuitive, car elle imite la façon dont beaucoup d'entre nous trient des cartes à jouer. L'idée est de construire progressivement une partie triée du tableau en y insérant un par un les éléments restants.
L'objectif de cette leçon est de vous permettre de comprendre, d'implémenter en pseudo-code et de tracer l'exécution de cet algorithme fondamental.
1. Le principe du tri par insertion
Imaginez que vous tenez quelques cartes triées dans votre main gauche. Vous piochez une nouvelle carte avec votre main droite. Que faites-vous ? Vous parcourez votre main gauche depuis la droite jusqu'à trouver l'endroit où insérer la nouvelle carte, en décalant les autres au passage.
Le tri par insertion applique exactement cette logique à un tableau. L'algorithme divise conceptuellement le tableau en deux parties :
- Une partie triée, qui grandit à chaque étape (au début, elle ne contient que le premier élément).
- Une partie non triée, qui contient les éléments restants à traiter.
À chaque étape, l'algorithme prend le premier élément de la partie non triée et l'insère à sa position correcte dans la partie déjà triée.
Pour bien saisir cette analogie, je vous propose de lire la courte description suivante.
Le document "Tri par insertion" de Jean-Philippe Préaux utilise l'analogie du jeu de cartes pour expliquer le principe de manière très claire et concise.
Lisez la section 2.1 "Principe". Concentrez-vous sur la description des deux "tas" (trié et non trié) et de l'opération d'insertion.
2. Tracer l'exécution de l'algorithme
Visualisons maintenant ce processus sur un tableau. On commence par considérer que le premier élément T[0] est une partie triée à lui tout seul. Ensuite, on prend le deuxième élément T[1] et on l'insère par rapport à T[0]. Puis on prend T[2] et on l'insère dans la partie maintenant triée T[0..1], et ainsi de suite.
L'insertion ne se fait pas par un simple échange. Pour faire de la place à l'élément qu'on insère, il faut décaler vers la droite tous les éléments de la partie triée qui sont plus grands que lui.
L'image ci-dessous illustre ce mécanisme de décalage pour insérer la valeur '5' dans une partie déjà triée.

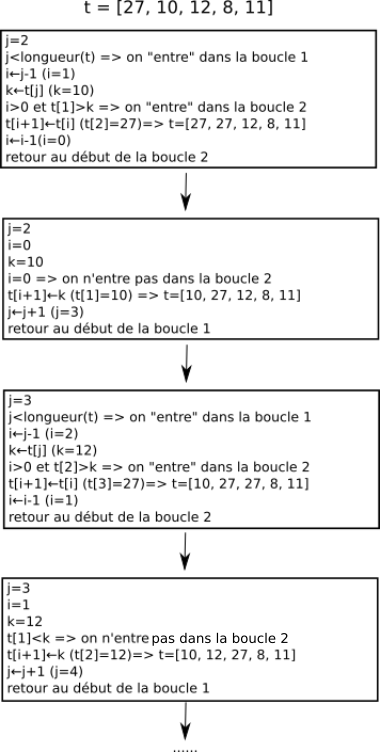
Pour suivre l'exécution complète de l'algorithme, on peut utiliser un tableau de suivi qui montre l'état du tableau après chaque insertion. C'est ce qu'on appelle tracer l'algorithme.
L'image suivante est un exemple de trace détaillée pour les premières étapes du tri d'un tableau.
3. Formalisation en pseudo-code
Maintenant que nous avons une vision claire du processus, traduisons-le en pseudo-code. Nous utiliserons une boucle principale pour parcourir les éléments à insérer, et une boucle imbriquée pour trouver la bonne position et effectuer les décalages.
Reprenons le document de Jean-Philippe Préaux, qui propose un pseudo-code très clair pour l'algorithme.
Lisez la section 2.3 "Tri par insertion - Algorithme". Analysez attentivement le pseudo-code de la fonction TriParInsertion(T).
Analysons ensemble ce pseudo-code :
FONCTION TriParInsertion(T)
    N ← longueur(T)

    // Boucle externe : parcourt les éléments à insérer
    POUR i VARIANT DE 1 À N-1 FAIRE
        x ← T[i]        // L'élément à insérer
        k ← i           // L'indice où insérer (initialement)

        // Boucle interne : décale les éléments plus grands
        TANT QUE k > 0 ET T[k-1] > x FAIRE
            T[k] ← T[k-1] // Décalage vers la droite
            k ← k - 1
        FIN TANT QUE

        T[k] ← x        // Insère l'élément à sa place
    FIN POUR
FIN FONCTION
Décortiquons ce code :
POUR i VARIANT DE 1 À N-1 FAIRE: C'est notre boucle principale. Elle commence à1car on considère queT[0]est déjà une "partie triée". La variableidésigne l'indice du premier élément de la partie non triée.x ← T[i]: On sauvegarde la valeur à insérer. C'est crucial car la caseT[i]sera peut-être écrasée pendant le décalage.k ← i:ksera notre "curseur" qui cherche la bonne position pourx. Il commence à la position actuelle dex.TANT QUE k > 0 ET T[k-1] > x FAIRE: C'est le cœur de l'algorithme.k > 0: sécurité pour ne pas sortir du tableau par la gauche.T[k-1] > x: on vérifie si l'élément juste à gauche dans la partie triée est plus grand que notre élémentx.- Tant que cette condition est vraie, on effectue le décalage
T[k] ← T[k-1], puis on recule notre curseurk ← k - 1pour continuer la comparaison vers la gauche.
T[k] ← x: Lorsque la boucleTANT QUEse termine, c'est queT[k-1]est plus petit ou égal àx(ou qu'on a atteint le début du tableau). L'indicekest donc la "case vide" oùxdoit être placé.
4. À vous de jouer !
Comme vous préférez la pratique, voici un exercice pour vous approprier l'algorithme. Prenez une feuille et un crayon, et tracez le tri du tableau suivant.
Exercice :
Triez le tableau T = [8, 4, 6, 2, 5] en utilisant l'algorithme du tri par insertion.
Pour chaque étape de la boucle POUR (chaque valeur de i), montrez l'état du tableau après l'insertion. Décrivez brièvement les décalages effectués par la boucle TANT QUE.
Cliquez ici pour voir la solution détaillée.
Tableau initial : [8, 4, 6, 2, 5] (N = 5)
-
Étape 1 (i = 1) :
x ← T[1], doncx = 4. La partie triée est[8].TANT QUE:T[0](8) >x(4). On décale :T[1] ← T[0]. Le tableau devient[8, 8, 6, 2, 5].- La boucle s'arrête (on est au début du tableau). On insère
xenT[0]. - Tableau après insertion :
[4, 8, 6, 2, 5]
-
Étape 2 (i = 2) :
x ← T[2], doncx = 6. La partie triée est[4, 8].TANT QUE:T[1](8) >x(6). On décale :T[2] ← T[1]. Le tableau devient[4, 8, 8, 2, 5].- La boucle s'arrête car
T[0](4) n'est pas plus grand quex(6). On insèrexenT[1]. - Tableau après insertion :
[4, 6, 8, 2, 5]
-
Étape 3 (i = 3) :
x ← T[3], doncx = 2. La partie triée est[4, 6, 8].TANT QUE:T[2](8) >x(2). On décale. Tableau:[4, 6, 8, 8, 5].TANT QUE:T[1](6) >x(2). On décale. Tableau:[4, 6, 6, 8, 5].TANT QUE:T[0](4) >x(2). On décale. Tableau:[4, 4, 6, 8, 5].- La boucle s'arrête. On insère
xenT[0]. - Tableau après insertion :
[2, 4, 6, 8, 5]
-
Étape 4 (i = 4) :
x ← T[4], doncx = 5. La partie triée est[2, 4, 6, 8].TANT QUE:T[3](8) >x(5). On décale. Tableau :[2, 4, 6, 8, 8].TANT QUE:T[2](6) >x(5). On décale. Tableau :[2, 4, 6, 6, 8].- La boucle s'arrête car
T[1](4) n'est pas plus grand quex(5). On insèrexenT[2]. - Tableau après insertion :
[2, 4, 5, 6, 8]
Tableau final : [2, 4, 5, 6, 8]
Conclusion
Excellent travail ! Vous maîtrisez maintenant le tri par insertion, un algorithme à la fois simple et efficace pour des listes de petite taille. Son approche est fondamentalement différente de celles des tris par sélection et à bulles.
Points clés à retenir :
- Le tri par insertion construit une partie triée au début du tableau.
- Il prend les éléments un par un et les insère à leur place dans cette partie triée.
- L'insertion se fait en décalant vers la droite les éléments plus grands pour libérer une place.
- Il est particulièrement performant si le tableau est déjà "presque trié".
Et après ?
Vous avez maintenant étudié trois algorithmes de tri : sélection, bulles et insertion. Ils résolvent le même problème, mais avec des stratégies très différentes. Une question naturelle se pose alors : lequel est le meilleur ? Lequel est le plus rapide ?
La prochaine leçon, qui conclut ce module, répondra à cette question. Nous allons comparer intuitivement l'efficacité de ces trois algorithmes de tri, ainsi que celle des algorithmes de recherche que nous avons vus. Cela jettera les bases d'un concept crucial en informatique : l'analyse de la complexité.