Bonjour ! Dans les leçons précédentes, nous avons assemblé une belle collection d'outils : deux algorithmes de recherche (linéaire et dichotomique) et trois algorithmes de tri (sélection, bulles et insertion). Maintenant, la question qui se pose est : lequel choisir ?
Introduction
Cette leçon est la conclusion de notre module sur la recherche et le tri. Son objectif est de vous apprendre à comparer intuitivement l'efficacité de ces algorithmes. Nous allons chercher à répondre à des questions comme : "Quel algorithme est le plus rapide ?" ou "Dans quelle situation un algorithme est-il meilleur qu'un autre ?".
Comprendre ces compromis est une étape fondamentale pour atteindre votre objectif de "bien maîtriser l'algorithme pour faire un code clean". Un code "clean" n'est pas seulement lisible, il est aussi efficace. Choisir le bon algorithme pour la tâche à accomplir est l'une des compétences les plus importantes d'un bon développeur.
Nous allons diviser cette comparaison en deux parties : d'abord les algorithmes de recherche, puis les algorithmes de tri.
1. Comparaison des Algorithmes de Recherche
Rappelons rapidement les deux stratégies :
- Recherche linéaire : On parcourt le tableau élément par élément, du début à la fin.
- Recherche dichotomique : On examine l'élément du milieu. Si ce n'est pas celui qu'on cherche, on élimine la moitié du tableau où l'élément ne peut pas se trouver, et on recommence sur la moitié restante.
Le compromis fondamental : rapidité vs. prérequis
La différence la plus importante entre ces deux algorithmes n'est pas seulement leur vitesse, mais la condition requise pour que la recherche dichotomique fonctionne : le tableau doit être trié.
Pensez à chercher un mot dans un dictionnaire. Vous utilisez naturellement une méthode dichotomique : vous ouvrez le dictionnaire au milieu, vous regardez si votre mot se situe avant ou après la page actuelle, et vous ne gardez que la moitié pertinente. C'est extrêmement rapide car les mots sont triés par ordre alphabétique. Imaginez maintenant que les mots du dictionnaire soient dans un ordre aléatoire. Votre seule option serait de lire chaque mot, page par page, depuis le début. Ce serait une recherche linéaire, et ce serait terriblement long.
Pour analyser cette différence de "vitesse" plus en détail, nous allons nous appuyer sur une ressource qui compare expérimentalement ces deux approches.
Recherche dichotomique - Informatique au lycée Mounier ANGERS
Le document "Recherche dichotomique" du site Info Mounier offre une excellente analyse comparative, avec des mesures de temps concrètes.
Lisez les sections intitulées "Recherche dichotomique" (la partie avant "Algorithme de recherche dichotomique"), "Coût de l'algorithme", et la sous-section "Efficacité de la recherche dichotomique". Concentrez-vous sur la différence de performance décrite et l'exemple frappant du nombre d'étapes nécessaires pour un tableau d'un million d'éléments.
Visualiser la différence
Comme le montre la ressource que vous venez de lire, la différence de performance est spectaculaire.
- Pour la recherche linéaire, si on double la taille du tableau, on double le temps de recherche dans le pire des cas. La relation est directe, ou linéaire.
- Pour la recherche dichotomique, si on double la taille du tableau, on ajoute seulement une étape de plus. Le temps de recherche augmente très, très lentement. On parle de coût logarithmique.
Le graphique suivant illustre parfaitement cette différence. Il montre le nombre de comparaisons nécessaires (l'opération principale) en fonction du nombre d'éléments dans le tableau.

Alors, quand faut-il trier ?
C'est la question clé. Le document que vous avez lu y répond très bien.
Recherche dichotomique - Informatique au lycée Mounier ANGERS
Relisons la conclusion de la comparaison pour bien synthétiser le compromis.
Lisez les sections "Recherche séquentielle vs. dichotomique" et "Bilan". Concentrez-vous sur l'analyse coût/bénéfice : quand est-il intéressant de payer le prix du tri ?
En résumé :
- Si vous ne devez faire qu'une seule recherche dans un tableau non trié, la recherche linéaire est plus rapide que de trier le tableau PUIS d'y faire une recherche dichotomique.
- Si vous devez faire de nombreuses recherches dans le même tableau, il devient très rentable de le trier une seule fois au début, puis de profiter de la vitesse quasi-instantanée de la recherche dichotomique pour toutes les recherches suivantes.
2. Comparaison des Algorithmes de Tri Simple
Passons maintenant à nos trois algorithmes de tri :
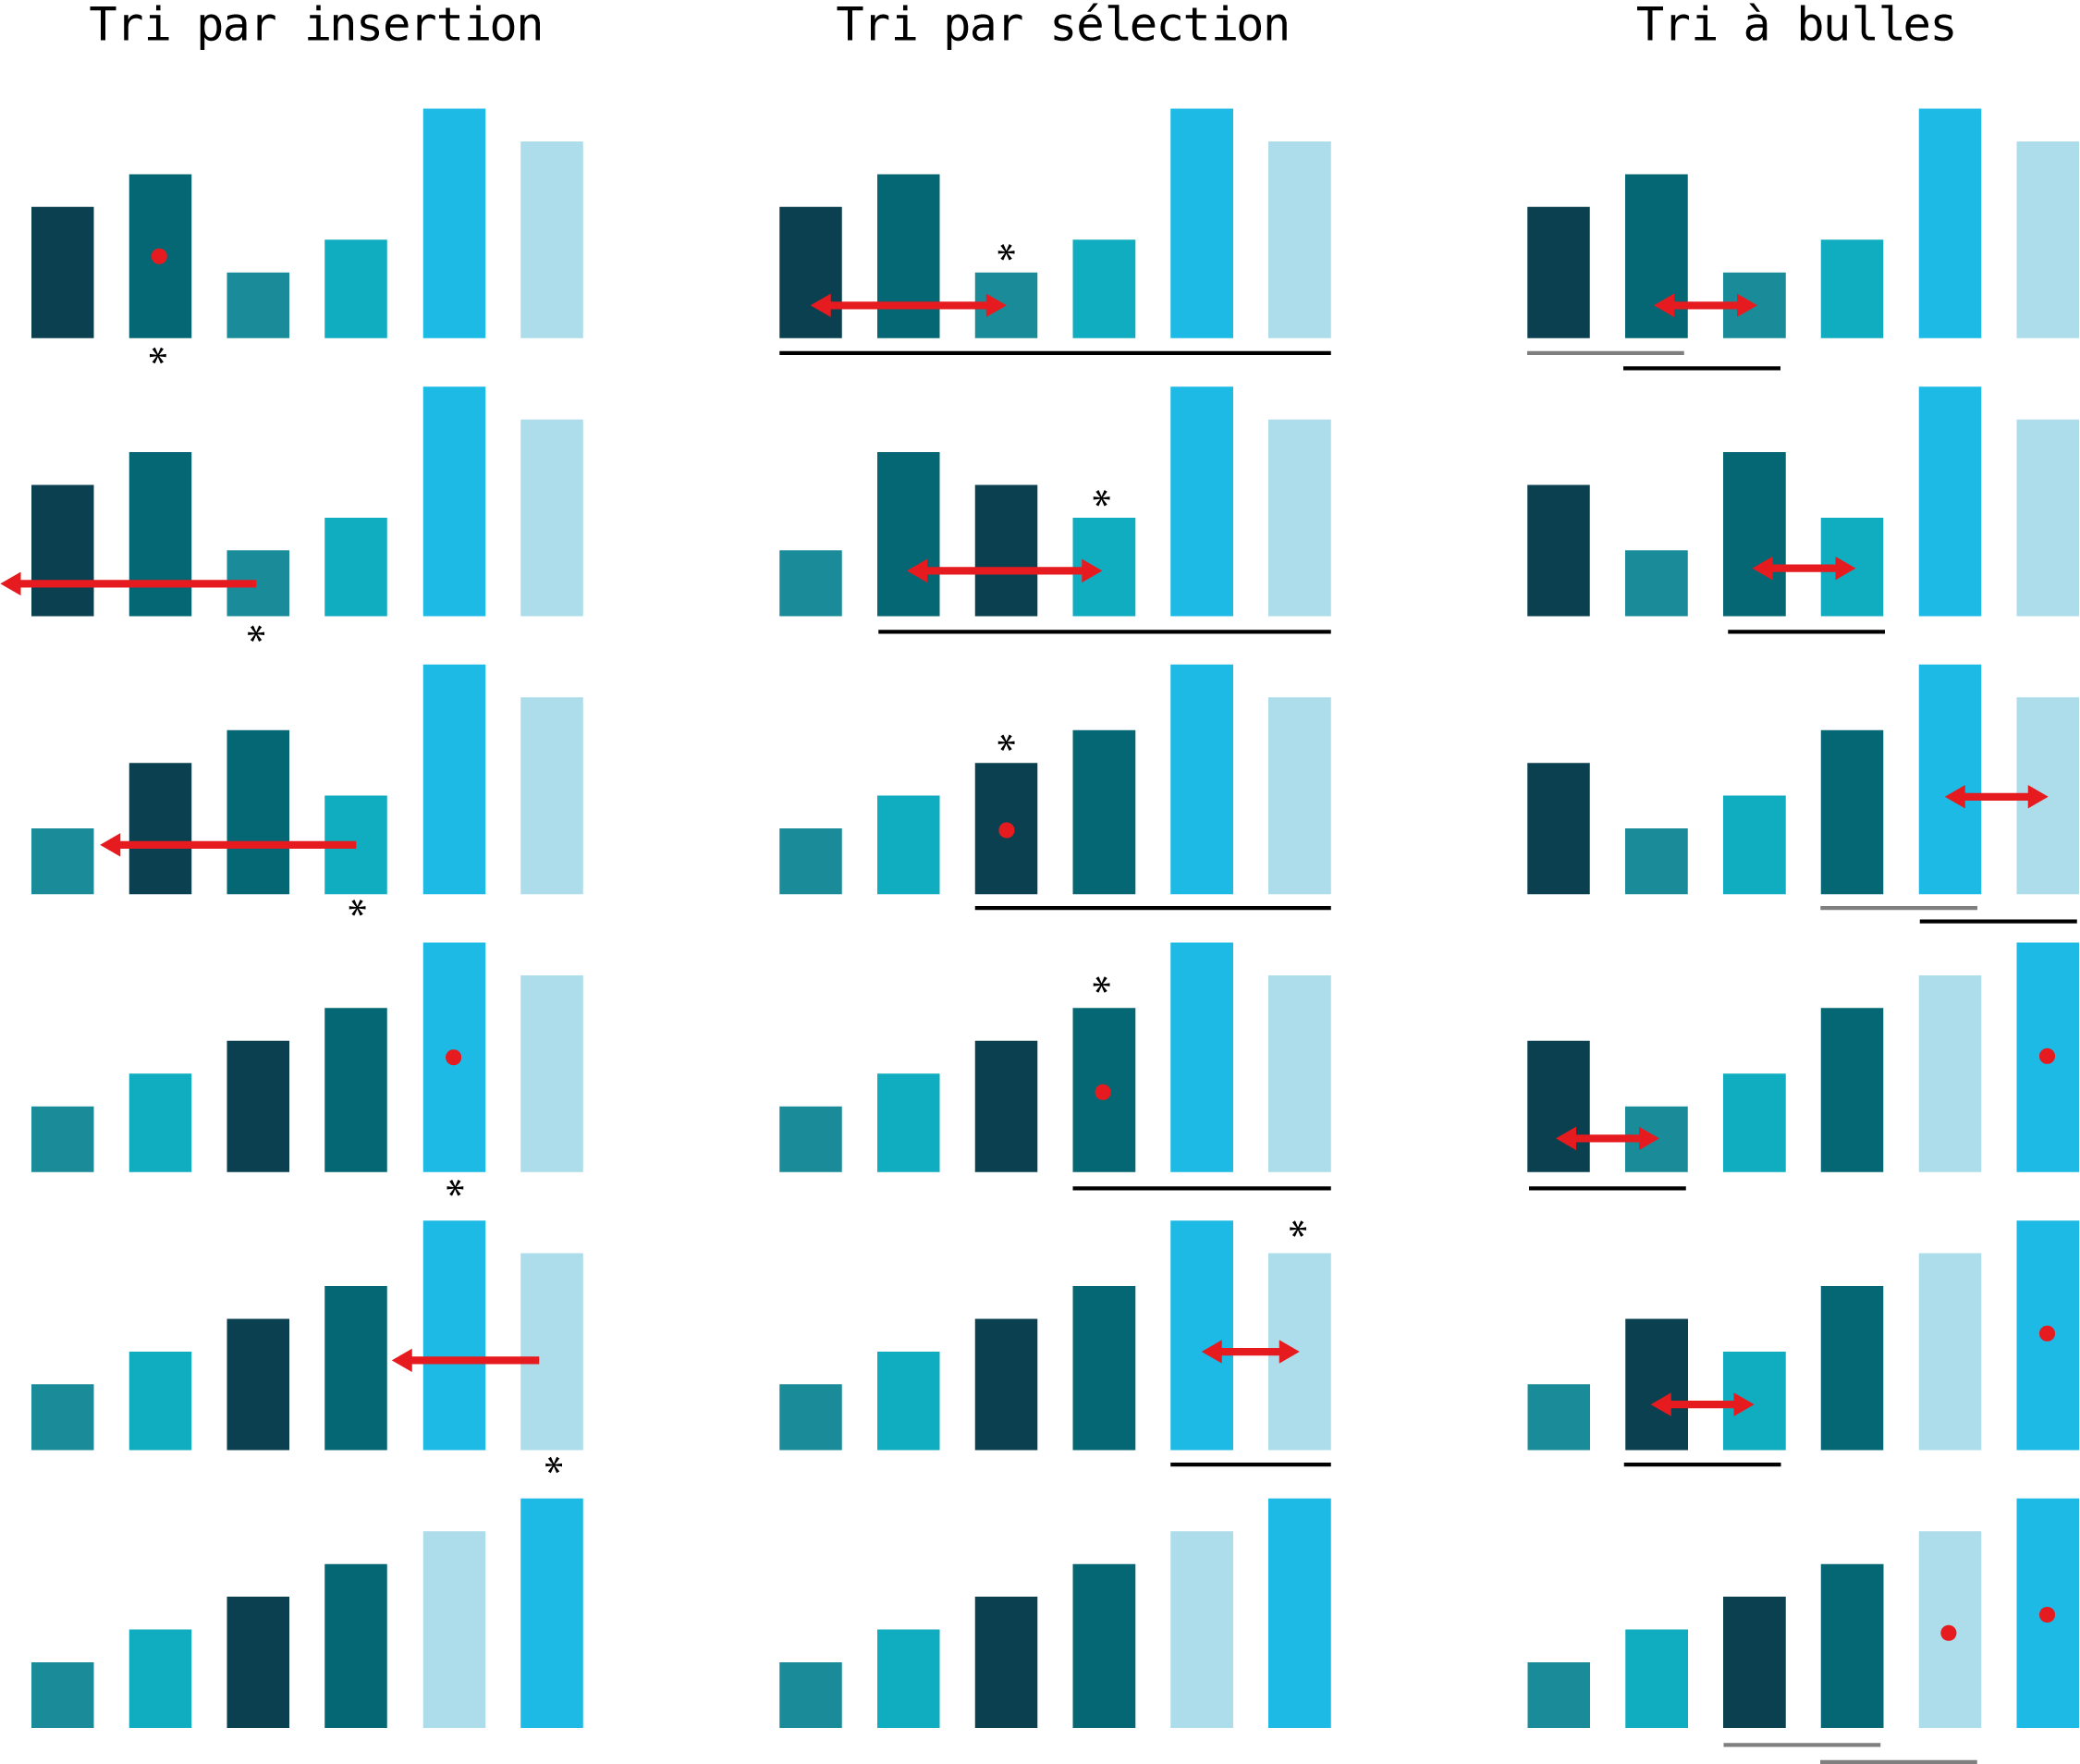
- Tri par sélection : On cherche le plus petit élément restant et on l'échange avec l'élément à la position courante.
- Tri à bulles : On compare les paires d'éléments adjacents et on les échange si nécessaire, faisant "remonter" les plus grands.
- Tri par insertion : On construit une partie triée et on y insère un par un les éléments restants.
Ces trois algorithmes sont dits "simples", mais ils sont considérés comme lents pour de grands ensembles de données. Cependant, ils ne sont pas tous égaux. Pour les comparer, on se base principalement sur deux types d'opérations :
- Le nombre de comparaisons (ex:
si T[j] > T[j+1]). - Le nombre d'échanges ou de déplacements d'éléments.
Le "meilleur" algorithme dépend parfois de ce qui est le plus coûteux. Comparer deux nombres est très rapide, mais déplacer de gros objets en mémoire peut être plus lent.
La ressource suivante propose une excellente approche pratique pour comparer ces trois tris.
2. Trie, cherche et trouve - Apprendre
L'article "Trie, cherche et trouve" du site Apprendre.modulo-info.ch explique non seulement le fonctionnement de chaque tri, mais propose aussi un exercice pratique pour en comparer l'efficacité.
En guise de rappel, parcourez rapidement les descriptions des trois algorithmes dans les sections "2.2. Tri par insertion", "2.3. Tri par sélection" et "2.4. Tri à bulles".
Visualiser les stratégies
Pour bien comparer, il est utile de revoir visuellement comment chaque algorithme procède. L'image ci-dessous, tirée de la ressource, montre l'exécution des trois tris sur le même petit tableau.
Exercice pratique : Comptons les opérations !
Comme vous appréciez la pratique, mettons la main à la pâte. En vous basant sur l'image ci-dessus (Étapes des algorithmes de tri), essayez de répondre à la question posée dans la ressource suivante.
2. Trie, cherche et trouve - Apprendre
Maintenant, nous allons faire l'exercice proposé dans la ressource. Cela va nous permettre de quantifier l'effort de chaque algorithme pour un exemple concret.
Lisez d'abord la section commençant par "La figure ci-dessus détaille les étapes...". Ensuite, lisez l'"Exercice 4 – Opérations" et essayez de compter vous-même les comparaisons et les déplacements pour chaque tri. Enfin, lisez la solution pour vérifier vos comptes et comprendre l'analyse.
L'analyse de la solution est très éclairante :
- Tri par sélection : Le plus de comparaisons, mais le moins de déplacements. C'est un avantage si les éléments à déplacer sont "lourds".
- Tri par insertion et à bulles : Moins de comparaisons (dans ce cas précis), mais plus de déplacements.
Impact des données initiales
Un point crucial, mentionné dans la ressource, est que la performance dépend fortement de l'état initial du tableau.
- Cas quasi-trié : Si le tableau est déjà presque en ordre, le tri par insertion est extrêmement rapide. Il ne fait que vérifier que tout est en ordre sans faire beaucoup de déplacements. Le tri à bulles (avec une optimisation pour s'arrêter s'il n'y a pas eu d'échange pendant un passage) est aussi très efficace. Le tri par sélection, lui, ne profite pas de cet état et effectuera toujours le même grand nombre de comparaisons.
- Cas inversé : Si le tableau est trié à l'envers, c'est le pire cas pour le tri par insertion et le tri à bulles, qui devront effectuer un maximum de déplacements.
2. Trie, cherche et trouve - Apprendre
Pour finir, lisons la section qui résume pourquoi la comparaison d'algorithmes est si importante.
Lisez la section "2.5. Comparaison d’algorithmes". Elle synthétise bien l'idée qu'il n'y a pas un seul "meilleur" algorithme dans l'absolu, mais plutôt un algorithme "plus approprié" selon la situation.
Conclusion
Félicitations ! Vous avez complété ce module sur les algorithmes de recherche et de tri. Vous êtes maintenant capable non seulement de les implémenter, mais aussi de raisonner sur leur efficacité relative.
Points clés à retenir :
- L'efficacité d'un algorithme se mesure souvent par le nombre d'opérations qu'il exécute (comparaisons, échanges).
- La recherche dichotomique est exponentiellement plus rapide que la recherche linéaire, mais elle exige un tableau trié. Le choix dépend du nombre de recherches à effectuer.
- Parmi les tris simples, le tri par sélection minimise les échanges, tandis que le tri par insertion est excellent pour les données déjà presque triées.
- Le "meilleur" algorithme dépend toujours du contexte : la taille des données, leur état initial, et le coût relatif des opérations.
Et après ?
Notre comparaison est restée "intuitive". Nous avons compté des opérations sur un petit exemple et observé des graphiques. Mais comment décrire cette efficacité de manière plus formelle et universelle ?
C'est précisément l'objet du prochain module, "Analyse de la Complexité Algorithmique". Nous allons y découvrir la notation Big O (comme les O(n) et O(log n) que vous avez vus sur le graphique). C'est un outil mathématique puissant qui permet de classer les algorithmes et de prédire comment leur temps d'exécution évoluera avec la taille des données. C'est une compétence essentielle pour concevoir des logiciels performants et robustes.