Bonjour ! Dans la leçon précédente, nous avons établi un pont crucial entre un outil d'analyse de code en ligne de commande, ESLint, et un modèle d'IA. Vous avez appris à capturer la sortie brute du linter et à la transmettre comme entrée à un LLM. C'est une étape fondamentale, mais comme vous l'avez sans doute constaté, la réponse de l'IA était probablement générique et peu exploitable.
Aujourd'hui, nous passons de la simple connexion à la véritable orchestration. L'objectif est de transformer le LLM en un assistant expert. Pour cela, nous allons nous plonger dans l'art et la science du prompt engineering. Vous apprendrez à rédiger des instructions si précises et contextuelles que l'IA ne se contentera plus de paraphraser le rapport du linter, mais le transformera en un résumé clair, pertinent et directement actionnable pour un développeur. C'est la compétence qui distingue un gadget IA d'un outil de productivité professionnel.
1. L'Anatomie d'une Instruction de Haute Qualité
La règle d'or avec les modèles de langage est simple : la qualité de la sortie dépend directement de la qualité de l'entrée. Un prompt vague donnera une réponse vague. Pour notre cas d'usage — la revue de code automatisée —, nous avons besoin de rigueur et de précision.
L'infographie suivante résume parfaitement les quatre piliers d'un prompt efficace pour une revue de code par IA. Nous allons les explorer en détail.
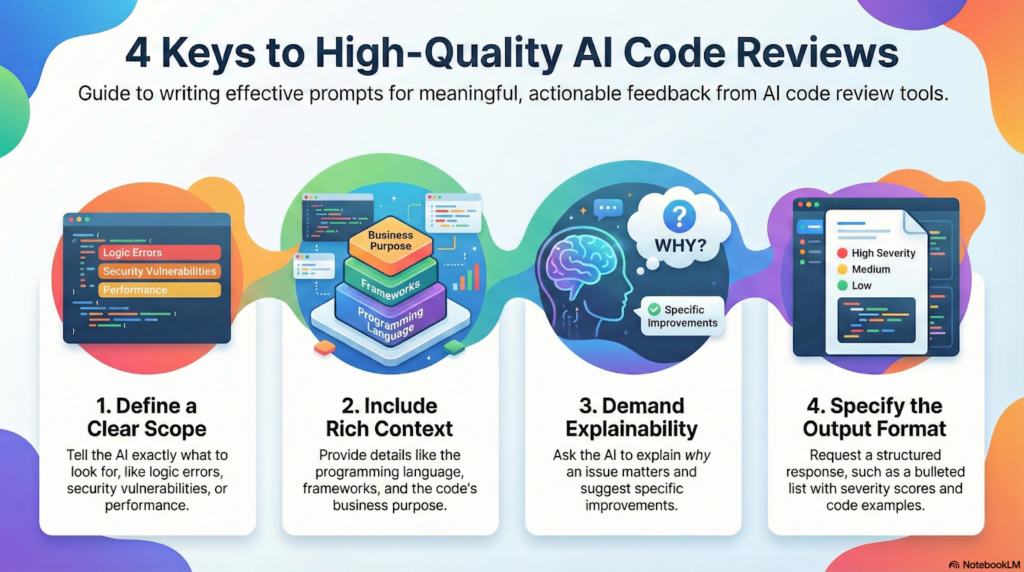
Ces quatre clés sont notre feuille de route pour la leçon d'aujourd'hui.
2. Le Prompt Engineering en Pratique : Devenir le Metteur en Scène de l'IA
Nous allons maintenant construire un nouveau prompt, beaucoup plus sophistiqué, en appliquant ces principes. Pour cela, nous allons nous appuyer sur des techniques éprouvées.
La ressource suivante, un guide de "hacks" de prompting, sera notre principale référence. Elle est en français et regorge de techniques que nous allons immédiatement mettre en pratique.
50+ Hacks Prompt IA 2026 : Guide ChatGPT, Claude, Gemini
Ce guide est une mine d'or de techniques de prompting. Nous allons nous concentrer sur celles qui sont les plus pertinentes pour notre objectif.
Commencez par lire les définitions de Prompt / Prompting et Prompt Engineering pour bien saisir les concepts. Ensuite, lisez la FAQ sur la "Formule 3C" qui donne une structure de base pour tout bon prompt. Enfin, lisez la FAQ sur les 5 techniques avancées, car nous allons en implémenter plusieurs.
Armés de ces connaissances, mettons à jour le prompt de notre nœud Google Gemini.
Clé n°1 : Définir un périmètre clair et un contexte riche
Un LLM ne sait rien de votre monde. Nous devons tout lui expliquer : son rôle, la nature des données que nous lui envoyons et l'objectif final.
- Le jeu de rôle (Role Play - Hack #2) : Nous allons demander à l'IA d'incarner un expert. Cela active dans le modèle des schémas sémantiques associés à l'expertise, améliorant radicalement la pertinence de la réponse.
- La Formule 3C (Contexte, Conversion, Conséquence) :
- Contexte : Le rapport vient d'ESLint, un linter JavaScript. L'objectif est d'aider un développeur.
- Conversion (Action) : Analyser, résumer, identifier les problèmes critiques, et suggérer des corrections.
- Conséquence (Objectif) : Permettre au développeur de corriger le code rapidement et de comprendre ses erreurs.
Dans n8n, une bonne pratique consiste à séparer le rôle (qui est une instruction système globale) de la tâche elle-même. Les nœuds d'IA modernes, comme celui de Google Gemini, permettent souvent de spécifier un message "Système".
Basic LLM Chain node documentation
La documentation de n8n explique bien les différents types de messages que l'on peut envoyer à un modèle de chat.
Lisez la section sur le message Système. Vous verrez qu'il est conçu pour "guider le modèle dans ce qu'il doit faire", comme définir un ton ou une personnalité. C'est l'endroit idéal pour notre instruction de "Role Play".
Clé n°2 : Exiger des explications
Pour éviter les "hallucinations" et s'assurer que l'IA raisonne correctement, nous pouvons lui demander d'expliciter sa pensée. C'est la technique du Chain-of-Thought (ou "pensée étape par étape").
- Le raisonnement explicite (Explainer Role Hack - Hack #8) : Nous allons instruire l'IA de réfléchir avant de répondre. Cela la force à suivre un processus logique, ce qui réduit les erreurs et augmente la fiabilité.
Clé n°3 & 4 : Spécifier le format de sortie
Une réponse en vrac est inutile. Nous voulons une sortie structurée, facile à lire et directement exploitable.
- Le résumé pour décideur (Executive Summary Hack - Hack #9) : Cette technique, venue du monde du conseil, force l'IA à être concise et orientée vers l'action.
- Format Markdown : Nous demanderons un formatage spécifique (titres, listes à puces, blocs de code) pour une lisibilité maximale.
3. Application dans votre workflow n8n
Il est temps de mettre tout cela en pratique. Retournez à votre workflow n8n et ouvrez le nœud Google Gemini. Nous allons complètement réécrire son contenu.
-
Configurer le message Système :
Dans le nœud Gemini, ajoutez un "Chat Message".- Sélectionnez le type
System. - Dans le champ
Message, collez le texte suivant. C'est ici que nous définissons le rôle de l'IA.
Tu es un expert en ingénierie logicielle et un développeur senior avec plus de 10 ans d'expérience, spécialisé dans la qualité du code JavaScript. Ton objectif est d'aider les développeurs à écrire du code propre, maintenable et performant en analysant les rapports d'outils d'analyse statique comme ESLint. Tu es pédagogue, précis et orienté vers l'action. - Sélectionnez le type
-
Configurer le message Utilisateur (le prompt principal) :
C'est ici que nous allons combiner la Formule 3C, le Chain-of-Thought et la demande de formatage. Remplacez le contenu de votre champPromptactuel par celui-ci :[CONTEXTE] Je suis un développeur travaillant sur un projet JavaScript. J'ai exécuté l'outil de linter ESLint sur mon code et j'ai obtenu le rapport ci-dessous. Rapport ESLint brut : --- {{ $node["Execute Command1"].json.stdout }} --- [ACTION / CONVERSION] Analyse ce rapport. D'abord, raisonne étape par étape sur la nature et la gravité des erreurs listées. Ensuite, rédige un résumé actionnable pour moi. [FORMAT DE SORTIE / CONSÉQUENCE] Ton résumé doit être structuré exactement comme suit, en utilisant le formatage Markdown : # Revue de Code Automatisée ## ✅ Évaluation Globale (Donne une évaluation qualitative très courte : "Quelques points à corriger", "Attention, problèmes critiques détectés", etc.) ## 🎯 Problèmes Identifiés (Liste chaque problème sous forme de puce. Pour chaque puce, indique : la règle ESLint violée, une explication CLAIRE de pourquoi c'est un problème, et le numéro de ligne concerné. Classe-les du plus critique au moins critique.) - **[Règle ESLint]** : (Ton explication ici) - Ligne X. - **[Règle ESLint]** : (Ton explication ici) - Ligne Y. ## 💡 Suggestions de Correction (Fournis des suggestions concrètes pour chaque problème, si possible avec un petit extrait de code corrigé.) Ne mentionne pas le fait que tu es une IA. Agis comme un pair développeur expérimenté.Rappel : Vérifiez que
Execute Command1est bien le nom de votre nœud qui exécute ESLint. -
Exécutez et comparez !
Lancez à nouveau le workflow complet. Observez la sortie du nœud Gemini. Comparez-la avec celle de la leçon précédente. La différence devrait être spectaculaire : vous devriez obtenir un rapport structuré, clair, et véritablement utile.
4. Au-delà du Prompt : Vers les Agents IA
Vous venez de maîtriser une interaction complexe et à haute valeur ajoutée avec un LLM. C'est une compétence fondamentale. L'étape suivante dans l'échelle de l'automatisation intelligente est de passer d'un "appel d'IA" à un "agent IA".
Un agent ne se contente pas de répondre à une instruction ; il peut utiliser des outils pour accomplir des tâches. Le prompt que nous venons de créer pourrait devenir l'instruction centrale d'un agent dont la mission est "analyser la qualité du code". Cet agent pourrait ensuite utiliser d'autres outils : un pour récupérer le code, un pour lancer le linter, un pour poster le résumé sur GitHub, etc.

Pour comprendre ce qui constitue un agent dans n8n, la vidéo suivante offre une excellente introduction.
Créer un agent IA avec n8n — Formation complète
Cette vidéo (en français) décompose les cinq "ingrédients" obligatoires pour configurer un agent IA dans n8n.
Regardez la section de présentation des composants. L'auteur explique qu'un agent a besoin d'un LLM, d'un prompt, d'outils, d'une mémoire et d'un moyen de communication. Notez que le prompt, que nous venons de perfectionner, n'est qu'un des cinq piliers d'un agent intelligent.
Cette distinction est la clé pour comprendre les modules à venir, où nous construirons des agents autonomes.
Conclusion
Dans cette leçon, vous avez fait un bond en avant significatif. Vous n'avez pas seulement amélioré un workflow ; vous avez appris à diriger une intelligence artificielle pour qu'elle accomplisse une tâche de développement logiciel avec un niveau de qualité professionnel.
Les points essentiels à retenir sont :
- Le prompt engineering est la discipline qui permet de maximiser la valeur des LLM.
- Des techniques comme le Role Play, la formule Contexte-Action-Conséquence, le Chain-of-Thought et la spécification du format de sortie sont des leviers puissants pour améliorer la qualité des réponses.
- Dans n8n, on peut utiliser le message Système pour définir le rôle de l'IA et le message Utilisateur pour la tâche spécifique.
- Un prompt sophistiqué est la première brique pour construire des agents IA encore plus capables.
Maintenant que nous savons comment analyser du code et générer une revue de qualité professionnelle en local, il est temps de passer à un cas d'usage réel et entièrement automatisé.
Dans la prochaine leçon, nous entrerons dans le module sur l'intégration CI/CD. Nous apprendrons à déclencher notre workflow n8n automatiquement à chaque fois qu'un développeur crée une pull request sur GitHub. Notre objectif final sera de poster ce résumé directement en commentaire de la PR, offrant une aide instantanée à l'équipe de développement.