Bonjour !
Dans la leçon précédente, nous avons mis en place une tâche cron pour automatiser notre script de sauvegarde. C'est un grand pas vers une administration système efficace. Mais que se passe-t-il si un matin, vous réalisez qu'aucune sauvegarde n'a été créée pendant la nuit ? Comment abordez-vous le problème ? Essayer des commandes au hasard en espérant que ça fonctionne ?
C'est là qu'intervient la compétence la plus fondamentale pour un administrateur systèmes : le dépannage. Aujourd'hui, nous allons laisser de côté l'approche "au feeling" pour adopter une méthode professionnelle.
L'objectif de cette leçon est d'appliquer une méthodologie de dépannage systématique, qui se décompose en quatre grandes étapes : identifier, isoler, résoudre et documenter. Maîtriser ce processus structuré est ce qui différencie un amateur d'un professionnel et vous permettra de résoudre les problèmes plus rapidement, plus efficacement et de manière plus fiable. C'est le début de notre module sur les méthodologies de dépannage et les pratiques d'entreprise comme ITIL, un sujet qui vous intéresse particulièrement pour votre carrière.
1. Pourquoi une méthodologie est-elle indispensable ?
Face à un problème informatique, l'instinct peut être de se jeter sur le clavier et d'essayer la première solution qui vient à l'esprit. Cette approche présente plusieurs risques :
- Perte de temps : Vous pourriez passer des heures à explorer de fausses pistes.
- Aggravation du problème : Une modification non réfléchie peut transformer un petit bug en une panne majeure.
- Non-résolution de la cause racine : Vous pourriez corriger un symptôme, mais le problème de fond reviendra.
- Incapacité à apprendre : Si vous ne savez pas exactement comment vous avez résolu le problème, vous ne pourrez ni le refaire, ni l'expliquer, ni l'empêcher de se reproduire.
Dans un environnement d'entreprise, les pannes (appelées incidents) ont un coût. Une approche structurée, souvent formalisée par des cadres de référence comme ITIL (Information Technology Infrastructure Library), est donc non-négociable.
Pour commencer, comprenons bien ce qu'est un incident dans un contexte professionnel et pourquoi sa gestion est si cruciale.
Gestion des incidents : processus, bonnes pratiques et outils
Cet article d'Atlassian, un éditeur de logiciels très utilisé en entreprise (Jira, Confluence), définit clairement la gestion des incidents dans un cadre ITIL.
Lisez les deux premières sections : "Qu'est-ce que la gestion des incidents ?" et "L'importance de la gestion des incidents". Concentrez-vous sur la définition d'un "incident" et sur les raisons pour lesquelles une gestion structurée est vitale pour une organisation.
2. Les 4 étapes clés du dépannage systématique
Le cœur de la méthodologie de dépannage peut se résumer en un cycle en quatre phases. Pour avoir une vue d'ensemble claire et dynamique de ce processus, je vous propose de regarder la vidéo suivante.
Tu veux devenir pro du dépannage informatique ? Regarde ça !
Cette vidéo de la chaîne Formip - Certification IT décompose très bien la méthode de dépannage que tout technicien ou administrateur se doit de connaître.
Regardez la vidéo en entier (environ 11 minutes). Elle est découpée en chapitres qui correspondent parfaitement aux étapes que nous étudions. Portez une attention particulière à la manière dont chaque étape s'enchaîne logiquement avec la suivante.
Analysons ces étapes en nous appuyant sur ce que vous venez de voir.
Étape 1 : Identifier le problème
C'est la phase de collecte d'informations. L'objectif est de comprendre précisément la nature du problème avant de tenter quoi que ce soit.
- Dialoguer : Parlez à l'utilisateur (ou à vous-même). Quelles sont les symptômes exacts ? Quand le problème a-t-il commencé ? Y a-t-il eu des changements récents ?
- Constater : Récupérez les messages d'erreur, consultez les fichiers de logs (comme le
backup.logde notre exercicecron). - Préserver : Avant toute modification, faites une sauvegarde si les données sont critiques.
Étape 2 : Isoler la cause
Une fois les symptômes connus, vous devez formuler et tester des hypothèses.
- Établir une théorie : "Le problème pourrait être dû à..." Commencez par les causes les plus simples et les plus probables (un câble débranché, un service arrêté, un disque plein). C'est le principe du rasoir d'Ockham : l'explication la plus simple est souvent la bonne.
- Tester la théorie : Appliquez une seule modification à la fois pour vérifier votre hypothèse. Si vous changez dix choses en même temps, vous ne saurez jamais laquelle a fonctionné.
- Chercher de l'aide : Utilisez des ressources externes (moteurs de recherche) ou internes (base de connaissances de l'entreprise, collègues).
- Itérer : Si votre théorie est fausse, annulez la modification que vous avez faite et passez à l'hypothèse suivante.
Étape 3 : Résoudre le problème
Une fois la cause racine identifiée, il est temps d'appliquer la solution.
- Établir un plan d'action : Listez les étapes nécessaires pour appliquer le correctif.
- Mettre en œuvre la solution : Appliquez le correctif.
- Escalader si besoin : Si la solution dépasse vos compétences ou vos autorisations, il faut faire remonter le problème à un niveau supérieur (un administrateur senior, un autre service). Savoir quand demander de l'aide est une compétence, pas une faiblesse.
Étape 4 : Vérifier et Documenter
Le travail n'est pas terminé une fois le correctif appliqué.
- Vérifier la résolution : Assurez-vous que le problème est bien résolu et que la solution n'a pas créé de nouveaux problèmes. Idéalement, faites la vérification avec l'utilisateur concerné.
- Mettre en place des mesures préventives : Pouvez-vous faire quelque chose pour que ce problème ne se reproduise plus ? (Ex: mettre à jour un logiciel, sensibiliser un utilisateur, automatiser une tâche de nettoyage).
- Documenter : C'est l'étape la plus souvent négligée, et pourtant la plus cruciale. Notez quel était le problème, ce que vous avez fait pour l'analyser, et comment vous l'avez résolu. Cette documentation servira de référence pour vous et vos collègues à l'avenir.
Ce processus peut être visualisé simplement avec le diagramme suivant :
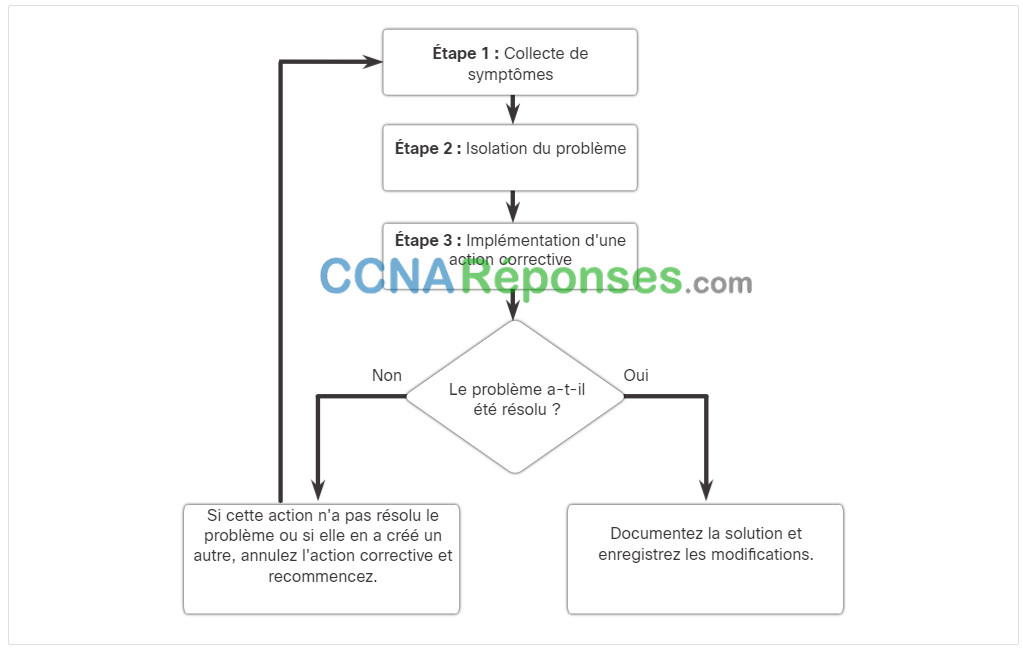
3. Application dans un cadre d'entreprise (ITIL)
La méthodologie que nous venons de voir est la base. Dans les entreprises, elle est souvent intégrée dans un processus plus formel appelé "Gestion des Incidents", inspiré par ITIL.
Ce processus formalise chaque étape pour assurer une traçabilité et une communication parfaites au sein des équipes.

Reprenons l'article d'Atlassian pour voir comment nos 4 étapes s'intègrent dans ce cadre formel.
Gestion des incidents : processus, bonnes pratiques et outils
Retournons à l'article sur la gestion des incidents pour voir sa déclinaison selon le framework ITIL.
Lisez attentivement la section "Étapes du processus de gestion des incidents informatiques". Essayez de faire le lien entre chaque étape décrite (Identifier et consigner, Catégoriser, Définir des priorités, Répondre, Clôture) et les 4 phases que nous avons vues (Identifier, Isoler, Résoudre, Documenter).
Vous remarquerez que les principes sont les mêmes, mais avec une couche de formalisme supplémentaire :
- Identifier et consigner correspond à notre étape d'identification.
- Catégoriser, Définir des priorités, et Enquête et diagnostic font partie de l'étape d'isolation.
- Résolution et récupération est notre étape de résolution.
- Clôture inclut la vérification et la documentation.
4. Mise en pratique : Un cas concret
Appliquons cette méthode à un scénario que vous connaissez bien.
Scénario : Votre script de sauvegarde, mon_backup.sh, est planifié avec cron pour s'exécuter tous les jours à 2h30. Ce matin, vous constatez qu'aucun nouveau fichier de sauvegarde n'a été créé dans le répertoire ~/sauvegardes.
Prenez quelques minutes pour réfléchir. Comment appliqueriez-vous la méthodologie en 4 étapes pour diagnostiquer ce problème ? Listez les actions concrètes pour chaque étape.
Cliquez ici pour voir un exemple de démarche de dépannage
Étape 1 : Identifier le problème
- Constat initial : Le répertoire
~/sauvegardesne contient pas l'archive attendue pour aujourd'hui. La dernière date de plusieurs jours. - Consulter les logs : Je vérifie le fichier de log que nous avons configuré :
cat ~/backup.log. Contient-il des messages ? Des erreurs ? Est-il vide ? - Vérifier les logs système de
cron:cronenregistre aussi son activité. Sur Ubuntu, je peux chercher des traces avecgrep CRON /var/log/syslog. Est-ce que mon script a bien été lancé ?
Étape 2 : Isoler la cause
Je vais tester plusieurs hypothèses, de la plus simple à la plus complexe.
- Hypothèse A : Le script lui-même a un problème.
- Test : Je lance le script manuellement :
/bin/bash ~/mon_backup.sh. Est-ce qu'il fonctionne ? Affiche-t-il une erreur (par exemple, "commande introuvable" si j'ai mal écrittar) ?
- Test : Je lance le script manuellement :
- Hypothèse B : La
crontabest incorrecte ou a été effacée.- Test : J'affiche ma
crontab:crontab -l. Est-ce que la ligne de planification est toujours là ? La syntaxe est-elle correcte (chemins absolus, etc.) ?
- Test : J'affiche ma
- Hypothèse C : Le service
cronne fonctionne pas.- Test : Je vérifie le statut du service
cron:systemctl status cron. Est-il "active (running)" ?
- Test : Je vérifie le statut du service
- Hypothèse D : Il n'y a plus d'espace disque.
- Test : Je vérifie l'espace disque disponible :
df -h. Est-ce que la partition où se trouve mon répertoirehomeest pleine (100%) ?taréchouerait silencieusement dans ce cas.
- Test : Je vérifie l'espace disque disponible :
Étape 3 : Résoudre le problème
Disons que mon test de l'hypothèse D révèle que le disque est plein.
- Plan d'action : Je dois libérer de l'espace en supprimant les plus anciennes sauvegardes.
- Mise en œuvre : Je me déplace dans
~/sauvegardeset j'utilisermpour supprimer quelques fichiers.tar.gzanciens. - Vérification immédiate : Je relance le script manuellement pour confirmer qu'il crée bien une nouvelle archive maintenant qu'il y a de la place.
Étape 4 : Vérifier et Documenter
- Vérification finale : Le script a fonctionné manuellement. La solution est donc validée. Je vais attendre demain matin pour m'assurer que l'exécution automatique par
cronfonctionne aussi. - Mesure préventive : Pour que cela ne se reproduise pas, je peux écrire un petit script qui supprime les sauvegardes de plus de 7 jours et l'ajouter à ma
crontabpour qu'il s'exécute une fois par semaine. - Documentation (dans un carnet de notes ou un wiki personnel) :
- Incident : Sauvegardes automatiques arrêtées le [Date].
- Diagnostic : Le disque était plein, empêchant la création de nouvelles archives par
tar. - Résolution : Suppression manuelle des anciennes archives.
- Prévention : Création d'un script de nettoyage
cleanup_backups.shet ajout àcronpour une exécution hebdomadaire.
Conclusion
Aujourd'hui, vous avez appris bien plus qu'une simple technique : vous avez acquis un état d'esprit. La méthodologie Identifier, Isoler, Résoudre, Documenter est le socle sur lequel repose toute carrière réussie en administration de systèmes et réseaux. Elle apporte structure, efficacité et professionnalisme à votre travail.
Points clés à retenir :
- Le dépannage n'est pas de la magie, c'est un processus logique.
- Les quatre étapes (Identifier, Isoler, Résoudre, Documenter) forment un cycle à suivre rigoureusement.
- Commencez toujours par les hypothèses les plus simples.
- Ne faites qu'un seul changement à la fois lorsque vous testez une théorie.
- La documentation n'est pas une perte de temps, c'est un investissement pour l'avenir.
- Cette méthode est la base des processus d'entreprise comme la gestion des incidents ITIL.
Maintenant que vous disposez du "plan de bataille", les prochaines leçons vous fourniront les armes. Pour bien identifier et isoler un problème, il faut savoir observer son système. Notre prochaine leçon portera donc sur les outils permettant de surveiller l'utilisation des ressources système (CPU, RAM, disque), une compétence essentielle pour la phase de diagnostic.