Bonjour,
Dans notre leçon précédente, nous avons achevé notre étude des tris par comparaison avec heapsort, un algorithme performant et efficace en mémoire, garantissant une complexité en . Nous avons également mentionné que cette complexité représente une borne inférieure, , pour tout algorithme de tri basé sur la comparaison d'éléments.
Aujourd'hui, nous allons nous affranchir de cette contrainte. L'objectif de cette leçon est d'expliquer et d'implémenter le tri par comptage (counting sort) et le tri par base (radix sort), en analysant leurs conditions d'application. Ces deux algorithmes, en exploitant des hypothèses sur la nature des données, parviennent à trier en temps linéaire, brisant ainsi la "barrière" du .
Pour y parvenir, nous devons sortir du modèle de comparaison et utiliser directement la valeur des clés, que nous supposerons être des entiers.
1. Au-delà des comparaisons : les tris en temps linéaire
Pour introduire ce changement de paradigme, je vous invite à visionner un court extrait d'une conférence du MIT. Il expose les hypothèses fondamentales qui nous permettront de concevoir des algorithmes de tri plus rapides.
Lecture 7: Counting Sort, Radix Sort, Lower Bounds for Sorting
Cette section du cours du MIT situe le contexte. Elle explique pourquoi et comment nous allons délaisser le modèle de tri par comparaison pour nous concentrer sur le tri d'entiers, en introduisant deux paramètres clés : le nombre d'éléments 'n' et l'étendue des valeurs 'k'.
Regardez le segment de 31:53 à 34:59. L'essentiel est de comprendre que nous allons maintenant travailler avec des clés qui sont des entiers dans un intervalle [0, k-1], et que nous pouvons effectuer des opérations arithmétiques sur ces clés, pas seulement des comparaisons.
2. Le tri par comptage (Counting Sort)
Le tri par comptage est le premier exemple de cette nouvelle approche. Son idée est d'une simplicité redoutable : au lieu de comparer les éléments entre eux, nous allons simplement compter le nombre d'occurrences de chaque valeur.
Principe et Mécanisme
Le tri par comptage s'applique lorsque les éléments à trier sont des entiers dans un intervalle connu [0...k-1].
L'algorithme se déroule en plusieurs étapes précises. Pour les comprendre en détail, je vous propose de vous appuyer sur un excellent document en français.
[PDF] IFT436 - Algorithmes et structures de données
Le document de cours de Manuel Lafond pour l'université de Sherbrooke détaille l'algorithme du tri comptage avec une grande clarté. Il présente d'abord une version basique, puis une version plus robuste qui gère correctement les données associées aux clés.
Lisez la section 3.6, "Le tri comptage" (pages 35-37). Portez une attention particulière à la deuxième version de l'algorithme (triComptage(T)). C'est cette version, plus subtile, qui nous intéressera. Essayez de dérouler l'algorithme à la main sur un petit exemple, comme T = [4, 1, 3, 4, 3].
Pour résumer et visualiser la version stable de l'algorithme (celle du document) :
- Comptage : On crée un tableau
Cde tailleket on compte les occurrences de chaque clé de l'entréeA.C[i]contient le nombre d'éléments égaux ài. - Positions cumulées : On modifie
Cpour queC[i]contienne le nombre d'éléments inférieurs ou égaux ài.C[i]indique maintenant la position finale dans le tableau de sortie du dernier élément de valeuri. - Placement : On parcourt le tableau d'entrée
Ade la fin vers le début. Pour chaque élémentA[j], on le place dans le tableau de sortieBà la positionC[A[j]] - 1(en indexation 0), puis on décrémenteC[A[j]].

Stabilité
La stabilité est une propriété fondamentale pour un algorithme de tri. Elle garantit que l'ordre relatif des éléments de même clé est préservé.
[PDF] IFT436 - Algorithmes et structures de données
Le même document définit formellement la stabilité. C'est un concept essentiel à maîtriser.
Lisez la courte section 3.6.2, "Stabilité d’un tri" (pages 37-38).
Pourquoi le parcours inverse (étape 3) garantit-il la stabilité ? En traitant les éléments de A de droite à gauche, on place le dernier élément d'une certaine clé en premier, à la position la plus à droite qui lui est réservée. Ensuite, l'avant-dernier élément de cette même clé sera placé juste avant, et ainsi de suite. L'ordre initial est donc bien préservé.
La vidéo suivante offre une excellente animation de ce processus.
Linear Time Sorting: Counting Sort, Radix Sort, and Bucket Sort
Cette vidéo animée décortique la version stable du tri par comptage et explique de manière très visuelle pourquoi la stabilité est obtenue.
Regardez le segment de 01:01 à 06:21. Concentrez-vous sur l'explication de la stabilité (à partir de 05:46) et sur la manière dont le parcours inverse du tableau d'entrée la garantit.
Analyse et Conditions d'Application
- Complexité temporelle : . Les étapes (initialisation, comptage, cumul, placement) sont toutes en ou .
- Complexité spatiale : (pour le tableau de sortie
Bet le tableau de comptageC). - Condition d'application principale : L'algorithme est efficace si . Si l'étendue
kdevient beaucoup plus grande quen(par exemple, ), la complexité temps et espace devient prohibitive.
3. Le tri par base (Radix Sort)
Comment trier efficacement des entiers lorsque l'étendue k est grande ? Par exemple, si nous devons trier million de nombres ( ) de 32 bits ( ). Le tri par comptage est ici impraticable.
Le tri par base résout ce problème en triant les nombres "chiffre par chiffre".
Principe et Mécanisme
L'idée est de décomposer les nombres dans une base (par exemple, base 10 pour nos chiffres décimaux, ou base 2 pour les bits) et d'appliquer un tri stable sur chaque "chiffre", en commençant par le moins significatif (LSD : Least Significant Digit).
- Considérez les nombres à trier comme des chaînes de chiffres.
- Pour allant de 1 à (du chiffre le moins significatif au plus significatif) :
- Triez le tableau en utilisant un tri stable (comme notre tri par comptage) basé sur la valeur du -ème chiffre.
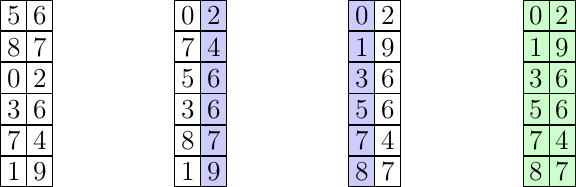
La raison pour laquelle cette approche fonctionne repose entièrement sur la stabilité du tri intermédiaire. Après avoir trié par le -ème chiffre, deux nombres ayant le même -ème chiffre conservent leur ordre relatif, qui a été établi par les tris sur les chiffres .
[PDF] IFT436 - Algorithmes et structures de données
Le document de M. Lafond explique également très bien le tri par base, en insistant sur l'importance de la stabilité.
Lisez la section 3.7, "Le tri radix" (pages 38-41). L'exemple avec les nombres binaires et la preuve informelle par invariant de boucle sont particulièrement instructifs.
Analyse et Conditions d'Application
- Complexité temporelle : Soit nombres, chiffres par nombre, et une base (chaque chiffre peut prendre valeurs). Nous effectuons passes de tri par comptage. Chaque passe a une complexité de . La complexité totale est donc .
- Choisir la base : C'est un point clé. Pour des nombres allant jusqu'à une valeur , on a . La complexité est donc . Un choix judicieux, si la mémoire le permet, est de prendre .
- Si , et que les clés sont bornées par pour une constante , alors .
- La complexité devient .
- Le tri par base permet donc de trier en temps linéaire des entiers dont la valeur est polynomiale en .
La vidéo suivante détaille cette analyse et le choix de la base.
Lecture 7: Counting Sort, Radix Sort, Lower Bounds for Sorting
Cette partie de la conférence du MIT se concentre sur le tri par base, son analyse, et la discussion sur le choix optimal de la base b pour atteindre une complexité linéaire.
Regardez le segment de 44:16 à 52:09. Concentrez-vous sur la dérivation de la complexité et la justification du choix b = Θ(n).
4. Exercice d'implémentation
Votre aisance en Python est un atout. Je vous propose de mettre en pratique ces deux algorithmes.
-
counting_sort(A, k, key_extractor)- Implémentez la version stable du tri par comptage.
Aest la liste d'objets à trier.kest la valeur maximale de la clé + 1.key_extractorest une fonction (par exemple, unelambda) qui, pour un élément deA, retourne la clé entière sur laquelle trier.
-
radix_sort(A, d, base)- Implémentez le tri par base pour une liste
Ad'entiers non-négatifs. dest le nombre de chiffres,baseest la base de numération.- À l'intérieur, vous appellerez votre
counting_sorten boucle. Pour chaque passe , lekey_extractordevra extraire le -ème chiffre d'un nombre. - Aide pour le
key_extractor: le -ème chiffre (avec pour le moins significatif) d'un nombrexen basebest(x // (base**i)) % base.
- Implémentez le tri par base pour une liste
Essayez d'abord d'écrire ces fonctions vous-même. Les pseudo-codes dans les ressources sont des guides excellents.
Conclusion
Aujourd'hui, nous avons exploré une famille d'algorithmes radicalement différente. En renonçant au modèle de comparaison et en exploitant la structure des clés entières, nous avons atteint des performances en temps linéaire, chose impossible autrement.
Points clés à retenir :
- Tri par comptage : Principe simple et efficace (), mais limité aux cas où l'étendue des clés
kest de l'ordre den. - Tri par base : Généralise le tri par comptage à des étendues de clés bien plus grandes (polynomiales en
n) en triant chiffre par chiffre. Sa complexité peut être rendue linéaire par un choix judicieux de la baseb. - Stabilité : Cette propriété n'est pas un simple détail technique. C'est la condition sine qua non du bon fonctionnement du tri par base LSD.
Prochaine étape :
Nous avons maintenant vu comment "battre" la borne . Dans la prochaine et dernière leçon de ce module, nous allons justement prouver formellement cette borne inférieure pour les tris par comparaison en utilisant le modèle de l'arbre de décision. Cela vous donnera une compréhension complète et rigoureuse du paysage des algorithmes de tri.