Bonjour,
Dans la leçon précédente, nous avons établi la définition formelle d'un tas binaire : un arbre binaire quasi-complet respectant la propriété de tas (max-tas ou min-tas), et nous avons vu son élégante implémentation à l'aide d'un simple tableau. La structure est posée.
Aujourd'hui, nous allons la rendre dynamique. L'objectif est de mettre en œuvre les opérations fondamentales d'un tas binaire pour construire le tri par tas (heapsort). Cet algorithme est un pilier de l'algorithmique, remarquable pour sa garantie de performance en et son exécution "en place" (sans mémoire additionnelle significative).
Nous décomposerons notre étude en trois étapes logiques :
- Maintenir la propriété de tas : l'opération
heapify. - Construire un tas à partir d'un ensemble de données non triées : l'opération
build-heap. - Trier les données en utilisant ces opérations : l'algorithme
heapsort.
Pour le tri en ordre croissant, il est conventionnel d'utiliser un tas-max. C'est donc cette variante que nous étudierons en détail.
1. Maintenir la propriété de tas : Heapify
Imaginez un tas-max où un seul élément, à la racine, viole la propriété de tas. C'est-à-dire que cet élément est peut-être plus petit qu'un de ses enfants. Cependant, nous supposons que les sous-arbres gauche et droit de cette racine sont, eux, des tas-max valides.
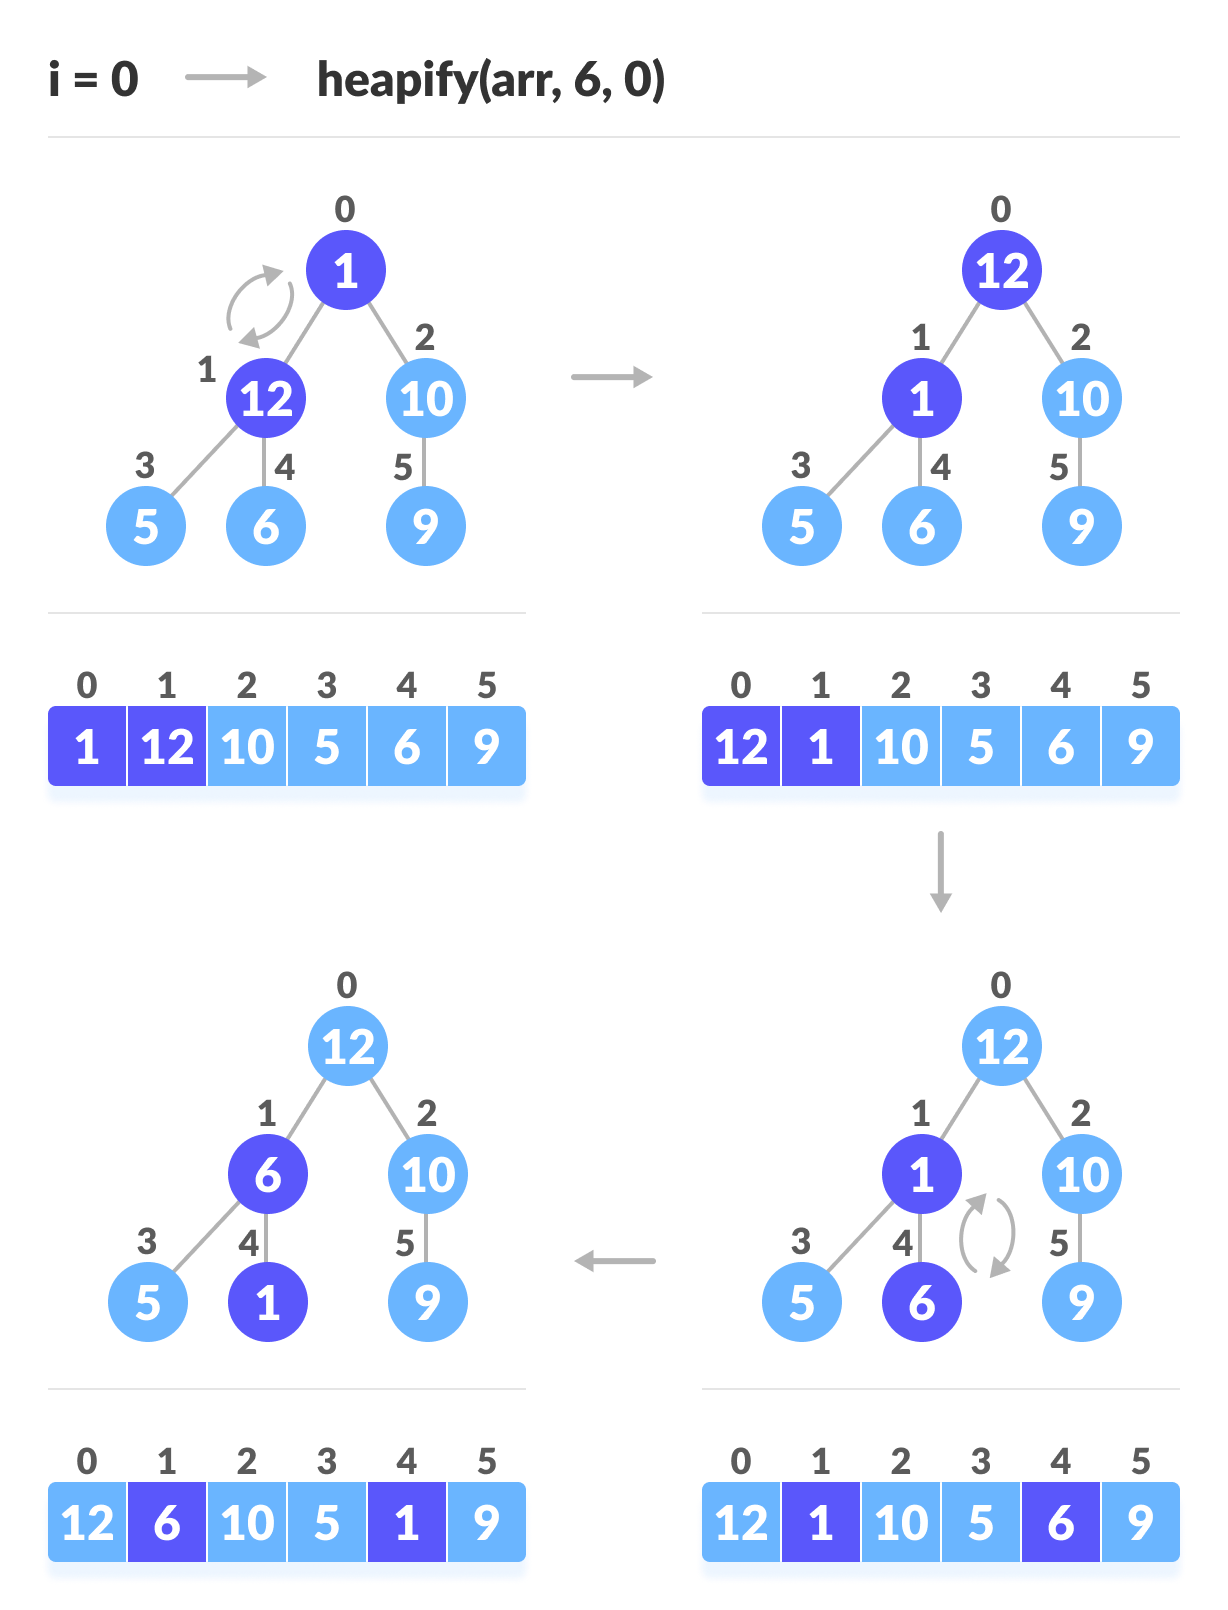
Comment restaurer la propriété pour l'ensemble de l'arbre ? L'opération qui résout ce problème est Max-Heapify. Son principe est de faire "descendre" ou "percoler" l'élément fautif dans l'arbre jusqu'à ce qu'il trouve sa place.
La procédure est la suivante, pour un nœud à l'indice i :
- On le compare à ses enfants gauche et droit.
- Si un des enfants est plus grand que le parent, on identifie le plus grand des trois (le parent, le fils gauche, le fils droit).
- Si le plus grand n'est pas le parent
i, on échangeiavec ce plus grand enfant. - Après l'échange, l'élément initialement à
ise retrouve plus bas. Il est possible qu'il viole à nouveau la propriété de tas à sa nouvelle position. On répète donc l'opération récursivement sur le sous-arbre concerné.
La vidéo suivante, du cours d'algorithmique du MIT, détaille cette procédure max-heapify avec la rigueur attendue.
Lecture 4: Heaps and Heap Sort
Cette vidéo explique l'opération max-heapify, qui est la pierre angulaire de tous les algorithmes sur les tas. L'explication est formelle et illustre la précondition essentielle : les sous-arbres des enfants doivent déjà être des tas.
Regardez le segment de 17:47 à 28:44. Il détaille la procédure max-heapify avec un exemple. Notez l'analyse de complexité : l'opération suit un chemin de la racine vers une feuille, sa complexité est donc bornée par la hauteur de l'arbre, soit O(log n).
Remarque : Le professeur utilise une indexation à partir de 1. Comme nous l'avons vu, cela change légèrement les formules de calcul d'indices (parent = i/2, gauche = 2i, droit = 2i+1), mais le principe algorithmique reste identique.
2. Construire un tas : Build-Max-Heap
Maintenant que nous savons réparer un tas, comment en construire un à partir d'un tableau désordonné ?
L'idée est d'appliquer max-heapify de manière itérative. On considère le tableau comme un arbre binaire complet et on procède "de bas en haut".
L'algorithme Build-Max-Heap est le suivant :
- On observe que tous les éléments de la seconde moitié du tableau sont des feuilles. Par définition, une feuille est un tas-max trivial de taille 1.
- On parcourt donc les nœuds qui ne sont pas des feuilles, en partant du dernier (l'indice pour une indexation à 0) et en remontant jusqu'à la racine (indice 0).
- Pour chacun de ces nœuds, on appelle
max-heapify.
L'invariant de boucle garantit que lorsque max-heapify(i) est appelé, les sous-arbres de ses enfants sont déjà des tas-max valides, ce qui satisfait la précondition de l'opération.
Analyse de complexité de Build-Max-Heap
Une analyse simple donnerait : on appelle max-heapify environ fois, et chaque appel coûte . Le total serait donc .
Cependant, une analyse plus fine, et c'est un point classique et important, montre que la complexité est en fait linéaire, soit . L'intuition est que la plupart des appels à heapify se font sur des nœuds très bas dans l'arbre (des petits tas) et coûtent donc très peu, tandis que les appels coûteux (proches de la racine) sont rares.
La vidéo suivante propose une démonstration mathématique de ce résultat. C'est une analyse que vous devez maîtriser.
Lecture 4: Heaps and Heap Sort
La preuve de la complexité linéaire de Build-Max-Heap est un résultat non trivial et très élégant. Cette vidéo vous guide à travers l'analyse formelle.
Regardez attentivement le segment de 30:00 à 45:46. Le professeur part de l'analyse simple en O(n log n) et la raffine en une analyse plus précise qui somme le travail effectué à chaque niveau de l'arbre. La conclusion de cette sommation est une complexité linéaire.
3. Le tri par tas : Heapsort
Armés de Build-Max-Heap et Max-Heapify, l'algorithme du tri par tas devient remarquablement simple.
L'algorithme Heapsort sur un tableau A de taille n se déroule comme suit :
- Phase de construction : Appeler
Build-Max-Heap(A). Le tableau est maintenant un tas-max, et l'élément le plus grand se trouve enA[0]. Coût : . - Phase de tri : Itérer de
i = n-1à1:
a. ÉchangerA[0](le maximum actuel du tas) avecA[i]. L'élément maximum est maintenant à sa place finale dans le tableau trié.
b. La taille du tas est virtuellement réduite de 1 (on ne considère plus l'élément à l'indicei).
c. Le nouvel élément enA[0]peut violer la propriété de tas-max. AppelerMax-Heapify(A, 0)sur le tas réduit pour restaurer la propriété. Coût : .
Après itérations, le tableau est entièrement trié.
Heaps, heapsort, and priority queues - Inside code
Voyons maintenant comment ces briques s'assemblent pour former l'algorithme de tri. Cette vidéo illustre très clairement le processus d'extraction successive du maximum.
Regardez de 14:10 à 17:05. La vidéo explique l'algorithme heapsort, en montrant comment on construit le tas puis on extrait répétitivement l'élément maximum pour le placer à la fin du tableau. Faites bien le lien entre l'opération extract_min (ou extract_max) et la boucle principale de heapsort.
La complexité totale de Heapsort est la somme de la construction () et des extractions ( chacune). Le terme dominant est donc celui des extractions, ce qui donne une complexité totale de .
4. Implémentation en Python
Passons de la théorie à la pratique. Votre maîtrise du Python est un atout pour concrétiser ces algorithmes. Le document suivant vous fournit une implémentation claire et fonctionnelle de Heapsort.
Pour finaliser votre compréhension, il est essentiel d'étudier une implémentation concrète. La ressource suivante de GeeksforGeeks propose un code Python pour Heapsort, facile à lire et directement transposable.
Concentrez-vous sur la section de code Python. Analysez les deux fonctions : heapify(arr, n, i) : C'est notre Max-Heapify. Repérez comment les indices des enfants (l = 2*i + 1, r = 2*i + 2) sont calculés pour un tableau indexé à 0. heapSort(arr) : Cette fonction orchestre l'algorithme. Identifiez la boucle de construction (Build-Max-Heap) puis la boucle d'extraction/tri. Je vous encourage à exécuter ce code et à le tester avec différents tableaux pour observer son fonctionnement.
Conclusion
Aujourd'hui, nous avons assemblé les pièces du puzzle pour construire un algorithme de tri des plus importants. Le tri par tas est un excellent exemple de la puissance d'une structure de données bien choisie.
Points clés à retenir :
- L'opération
heapify(coût ) est la procédure fondamentale pour maintenir la propriété de tas après une perturbation à la racine. - L'algorithme
build-heaptransforme un tableau quelconque en un tas en temps linéaire (), un résultat non-intuitif mais crucial. Heapsortutilisebuild-heapune fois, puis extrait itérativement le maximum en appelantheapifyà chaque étape, aboutissant à une complexité garantie de .- C'est un tri en place, ce qui le rend très efficace en termes d'utilisation mémoire.
Prochaine étape :
Nous avons maintenant exploré plusieurs algorithmes de tri basés sur des comparaisons (insertion, fusion, rapide, par tas). La prochaine leçon brisera ce paradigme. Nous aborderons le tri par comptage (counting sort) et le tri par base (radix sort), des algorithmes qui, sous certaines hypothèses sur les données d'entrée, peuvent trier en temps linéaire et ainsi battre la borne inférieure de des tris par comparaison.