Bonjour ! Dans la leçon précédente, vous avez appris à standardiser les caractéristiques, une étape de prétraitement cruciale pour préparer des données avec plusieurs variables pour l'entraînement de modèles. C'était la dernière pièce du puzzle avant de pouvoir exploiter pleinement la richesse de vos données.
Aujourd'hui, nous allons passer de la régression linéaire simple à un modèle beaucoup plus puissant et réaliste : la régression linéaire multiple. Ce modèle est au cœur de nombreuses applications en apprentissage automatique et en analyse de données. L'objectif de cette leçon est double : non seulement apprendre à implémenter un modèle de régression linéaire multiple avec Scikit-learn, mais aussi, et c'est tout aussi important, à interpréter correctement ses coefficients pour comprendre l'influence de chaque variable.
1. De la droite au plan : Qu'est-ce que la régression linéaire multiple ?
Vous vous souvenez de la régression linéaire simple, où nous cherchions à prédire une variable cible (comme le prix d'une maison) à partir d'une seule caractéristique (comme sa surface). Le modèle trouvait la meilleure droite pour représenter la relation.
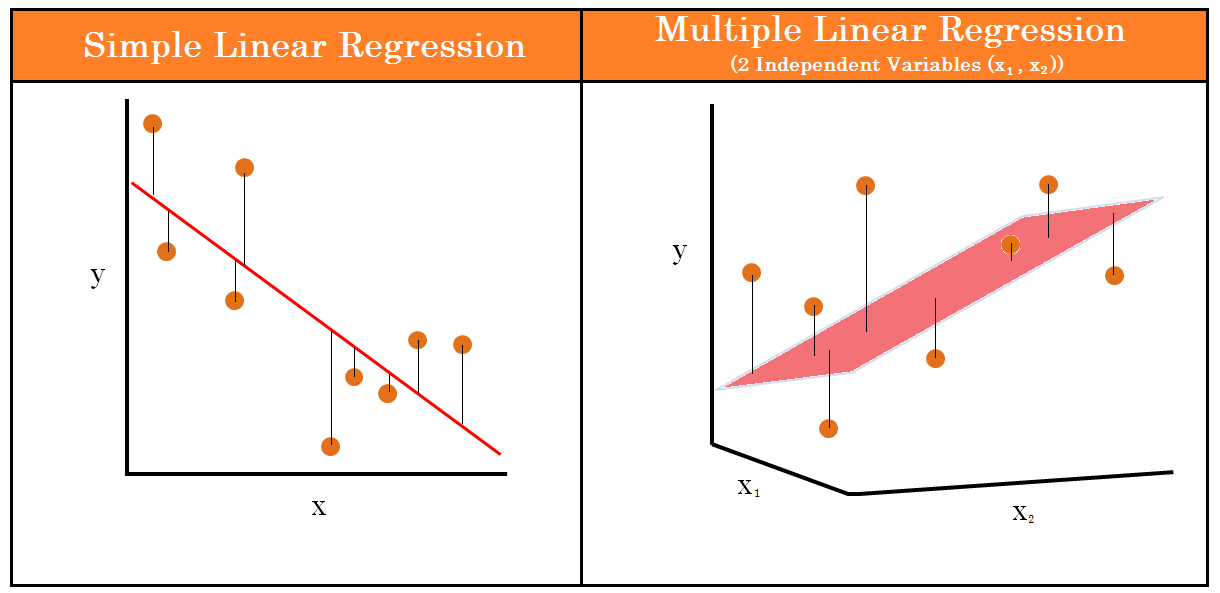
En réalité, le prix d'une maison ne dépend pas que de sa surface. Le nombre de chambres, l'âge de la maison, la distance au centre-ville sont autant de facteurs qui jouent un rôle. La régression linéaire multiple (RLM) nous permet de prendre en compte toutes ces informations simultanément.
Au lieu de chercher une droite dans un espace à deux dimensions, la RLM cherche le meilleur hyperplan dans un espace à multiples dimensions. Si nous avons deux caractéristiques, comme dans l'image ci-dessus, cet hyperplan est un simple plan en 3D.
L'équation du modèle passe de à :
Où :
- est la variable cible que nous voulons prédire.
- sont les caractéristiques (variables indépendantes).
- est l'ordonnée à l'origine (l'intercept), la valeur prédite de lorsque toutes les caractéristiques sont nulles.
- sont les coefficients du modèle. Chaque coefficient représente le "poids" ou l'importance de sa caractéristique correspondante.
- est le terme d'erreur, qui capture la variabilité que le modèle n'explique pas.

L'article suivant offre une excellente introduction au concept.
Multiple Linear Regression: Complete Guide with Formulas ...
Cet article de mbrenndoerfer explique clairement comment la régression multiple étend la régression simple et pourquoi elle est si utile.
Lisez la section d'introduction intitulée Multiple Linear Regression. Concentrez-vous sur l'idée de passer d'une ligne à un hyperplan et sur la raison pour laquelle l'utilisation de plusieurs caractéristiques permet des prédictions plus précises.
2. L'art de l'interprétation : Comprendre les coefficients
La véritable puissance de la régression linéaire multiple ne réside pas seulement dans sa capacité de prédiction, mais aussi dans son interprétabilité. Comprendre ce que signifient les coefficients est une compétence fondamentale.
Dans une régression simple, le coefficient (la pente) était facile à interpréter : "une augmentation d'une unité de X entraîne une augmentation de unités de Y". En régression multiple, l'interprétation est similaire mais avec une nuance cruciale.
Le coefficient représente l'augmentation moyenne de la variable cible pour une augmentation d'une unité de la caractéristique , en maintenant toutes les autres caractéristiques constantes.
Cette dernière partie — "en maintenant toutes les autres caractéristiques constantes" (ou ceteris paribus) — est essentielle. Elle nous permet d'isoler l'impact d'une seule variable.
Exemple concret :
Supposons que notre modèle de prix de maison nous donne l'équation suivante :
Prix = 50 000 + (75 × Surface) + (20 000 × Nb_Chambres) - (1 500 × Âge)
- Interprétation de = 75 : En maintenant le nombre de chambres et l'âge constants, chaque mètre carré supplémentaire augmente le prix prédit de la maison de 75 €.
- Interprétation de = 20 000 : Pour des maisons de même surface et de même âge, chaque chambre supplémentaire augmente le prix prédit de 20 000 €.
- Interprétation de = -1 500 : Pour des maisons de même surface et avec le même nombre de chambres, chaque année supplémentaire diminue le prix prédit de 1 500 €.
La vidéo suivante explique cette interprétation de manière très claire et détaillée.
Multiple Regression | Coefficients – Interpretation, C.I, Hypothesis Testing
Cette vidéo de Joshua Emmanuel se concentre spécifiquement sur la manière correcte d'interpréter les coefficients dans une régression multiple.
Regardez attentivement le segment de l'interprétation des coefficients. Notez bien l'importance de la phrase "holding other variables constant" (en maintenant les autres variables constantes).
Pour un rappel écrit, l'article suivant contient une section FAQ qui résume parfaitement comment interpréter les différents résultats d'un modèle de régression.
Multiple Linear Regression in Python: A Comprehensive ...
Cet article de DigitalOcean propose un guide pratique, et sa section FAQ est particulièrement utile pour la révision.
Lisez la question "How do you interpret multiple regression results in Python?". Elle synthétise l'interprétation des coefficients, de l'intercept et du R².
3. Mise en pratique avec Scikit-learn
Passons maintenant à la pratique. Nous allons construire, entraîner et interpréter un modèle de régression linéaire multiple en utilisant Python, Pandas et Scikit-learn. La vidéo suivante vous guidera à travers un exemple complet, de la préparation des données à la prédiction.
Machine Learning Tutorial Python - 3: Linear Regression Multiple Variables
Cette vidéo de la chaîne codebasics est un excellent tutoriel pour débutants qui montre l'ensemble du processus sur un cas d'étude de prédiction de prix immobiliers.
Suivez les étapes de la vidéo dans l'ordre. Introduction et analyse des données (introduction) : Comprenez le problème et l'équation du modèle. Prétraitement des données (data preprocessing) : Observez comment gérer une valeur manquante, une tâche très courante en pratique. Cela renforce vos compétences avec Pandas. Entraînement du modèle (training) : Voyez comment la méthode .fit() est utilisée avec plusieurs colonnes de caractéristiques. Le code est presque identique à celui de la régression simple ! Accès aux coefficients et à l'intercept (coefficients) : Découvrez comment extraire les paramètres appris par le modèle avec .coef_ et .intercept_. Notez que .coef_ est maintenant un tableau de valeurs. Faire des prédictions (predictions) : Apprenez à utiliser .predict() avec de nouvelles données et voyez comment la prédiction est calculée manuellement en utilisant les coefficients, ce qui solidifie votre compréhension.
Voici un résumé du code que vous avez vu dans la vidéo pour vous servir de référence :
import pandas as pd
from sklearn.linear_model import LinearRegression


# 1. Charger et préparer les données (exemple)
# df = pd.read_csv('homeprices.csv')
# ... gestion des valeurs manquantes ...


# 2. Créer l'objet modèle
model = LinearRegression()


# 3. Entraîner le modèle
# X est un DataFrame avec les colonnes 'area', 'bedrooms', 'age'
# y est une Series avec la colonne 'price'
model.fit(X, y)


# 4. Interpréter les résultats
print("Coefficients:", model.coef_)


# Le premier coefficient correspond à 'area', le deuxième à 'bedrooms', etc.

print("Intercept:", model.intercept_)


# 5. Faire une prédiction pour une nouvelle maison
# (par ex. 3000m², 4 chambres, 5 ans)
predicted_price = model.predict([[3000, 4, 5]])
print("Prix prédit:", predicted_price)
Ce flux de travail est le fondement de nombreux projets de machine learning. Le fait que l'interface de Scikit-learn (.fit(), .predict()) reste la même, que vous utilisiez une ou plusieurs caractéristiques, est ce qui la rend si puissante et facile à utiliser.
Conclusion
Aujourd'hui, vous avez fait un grand pas en avant en passant de modèles à une seule variable à des modèles qui peuvent gérer une complexité beaucoup plus grande. La régression linéaire multiple est un outil polyvalent qui offre un excellent équilibre entre performance et interprétabilité.
Points clés à retenir :
- La régression linéaire multiple modélise la relation entre une variable cible et plusieurs caractéristiques en ajustant un hyperplan.
- L'équation du modèle est .
- L'interprétation d'un coefficient est l'effet d'une augmentation d'une unité de sur , en maintenant toutes les autres caractéristiques constantes.
- Avec Scikit-learn, on utilise
LinearRegressioncomme pour la régression simple. Les coefficients pour chaque caractéristique sont stockés dans l'attributmodel.coef_.
Maintenant, que se passe-t-il si nous avons des dizaines, voire des centaines de caractéristiques ? Ou si certaines de nos caractéristiques sont fortement corrélées entre elles (par exemple, la surface d'une maison et le nombre de chambres) ? Cela peut rendre le modèle instable et sujet au surapprentissage. Dans la prochaine leçon, nous aborderons ce problème en explorant les techniques de régularisation comme la régression Ridge et Lasso, qui aident à créer des modèles plus robustes.