Bonjour ! Dans la leçon précédente, nous avons établi que pour entraîner un modèle, nous devons minimiser une fonction de coût, qui mesure à quel point les prédictions du modèle sont erronées. Nous avons défini ce quoi, mais la question essentielle demeure : comment un ordinateur trouve-t-il les valeurs de poids et de biais qui rendent ce coût minimal ?
Cette leçon est consacrée à répondre à cette question. Nous allons explorer l'un des algorithmes d'optimisation les plus fondamentaux et les plus puissants de l'apprentissage automatique : la descente de gradient (gradient descent). C'est le mécanisme qui permet au modèle d'« apprendre » en ajustant itérativement ses paramètres pour réduire l'erreur. L'objectif est de comprendre l'intuition derrière cet algorithme, son fonctionnement et son rôle central dans la minimisation de la fonction de coût.
1. L'intuition : Descendre la colline
Imaginez que vous êtes au sommet d'une colline, dans un brouillard épais, et que votre objectif est de trouver le point le plus bas de la vallée. Vous ne voyez rien à plus d'un mètre. Que feriez-vous ? L'approche la plus logique serait de sentir la pente sous vos pieds et de faire un pas dans la direction où ça descend le plus. En répétant ce processus, pas après pas, vous finirez par atteindre le fond de la vallée.
La descente de gradient fonctionne exactement sur ce principe.
- La colline est la représentation de notre fonction de coût. L'altitude en chaque point correspond à la valeur du coût pour des poids et biais donnés.
- Le point le plus bas de la vallée est le minimum de notre fonction de coût, c'est-à-dire l'ensemble des paramètres qui donne le modèle le plus performant.
- Faire un pas dans la direction de la plus forte pente est l'essence même de l'algorithme.
L'image ci-dessous illustre ce processus. On part d'une position initiale (un ensemble de poids aléatoires) et on effectue des pas successifs pour "descendre" le long de la courbe de coût jusqu'à atteindre le point de convergence, où le coût est minimal.

La vidéo suivante de la chaîne StatQuest with Josh Starmer est célèbre pour sa clarté et explique cette intuition de manière simple et accessible.
Gradient Descent, Step-by-Step
Cette vidéo explique l'idée de base de la descente de gradient avec des analogies très simples et visuelles.
Regardez d'abord la présentation du problème : l'objectif est de trouver le minimum d'une fonction. Ensuite, concentrez-vous sur le segment expliquant comment la pente (dérivée) nous indique la direction et la taille du pas à effectuer pour descendre.
2. Le rôle du Gradient
Pour appliquer cette idée, nous devons répondre à deux questions :
- Dans quelle direction descendre ?
- Quelle doit être la taille de notre pas ?
La réponse à la première question nous est donnée par le gradient. Dans vos cours de mathématiques, vous avez vu que la dérivée d'une fonction à une variable mesure sa pente en un point. Pour une fonction de plusieurs variables, comme notre fonction de coût qui dépend des poids et du biais , le concept équivalent est le gradient.
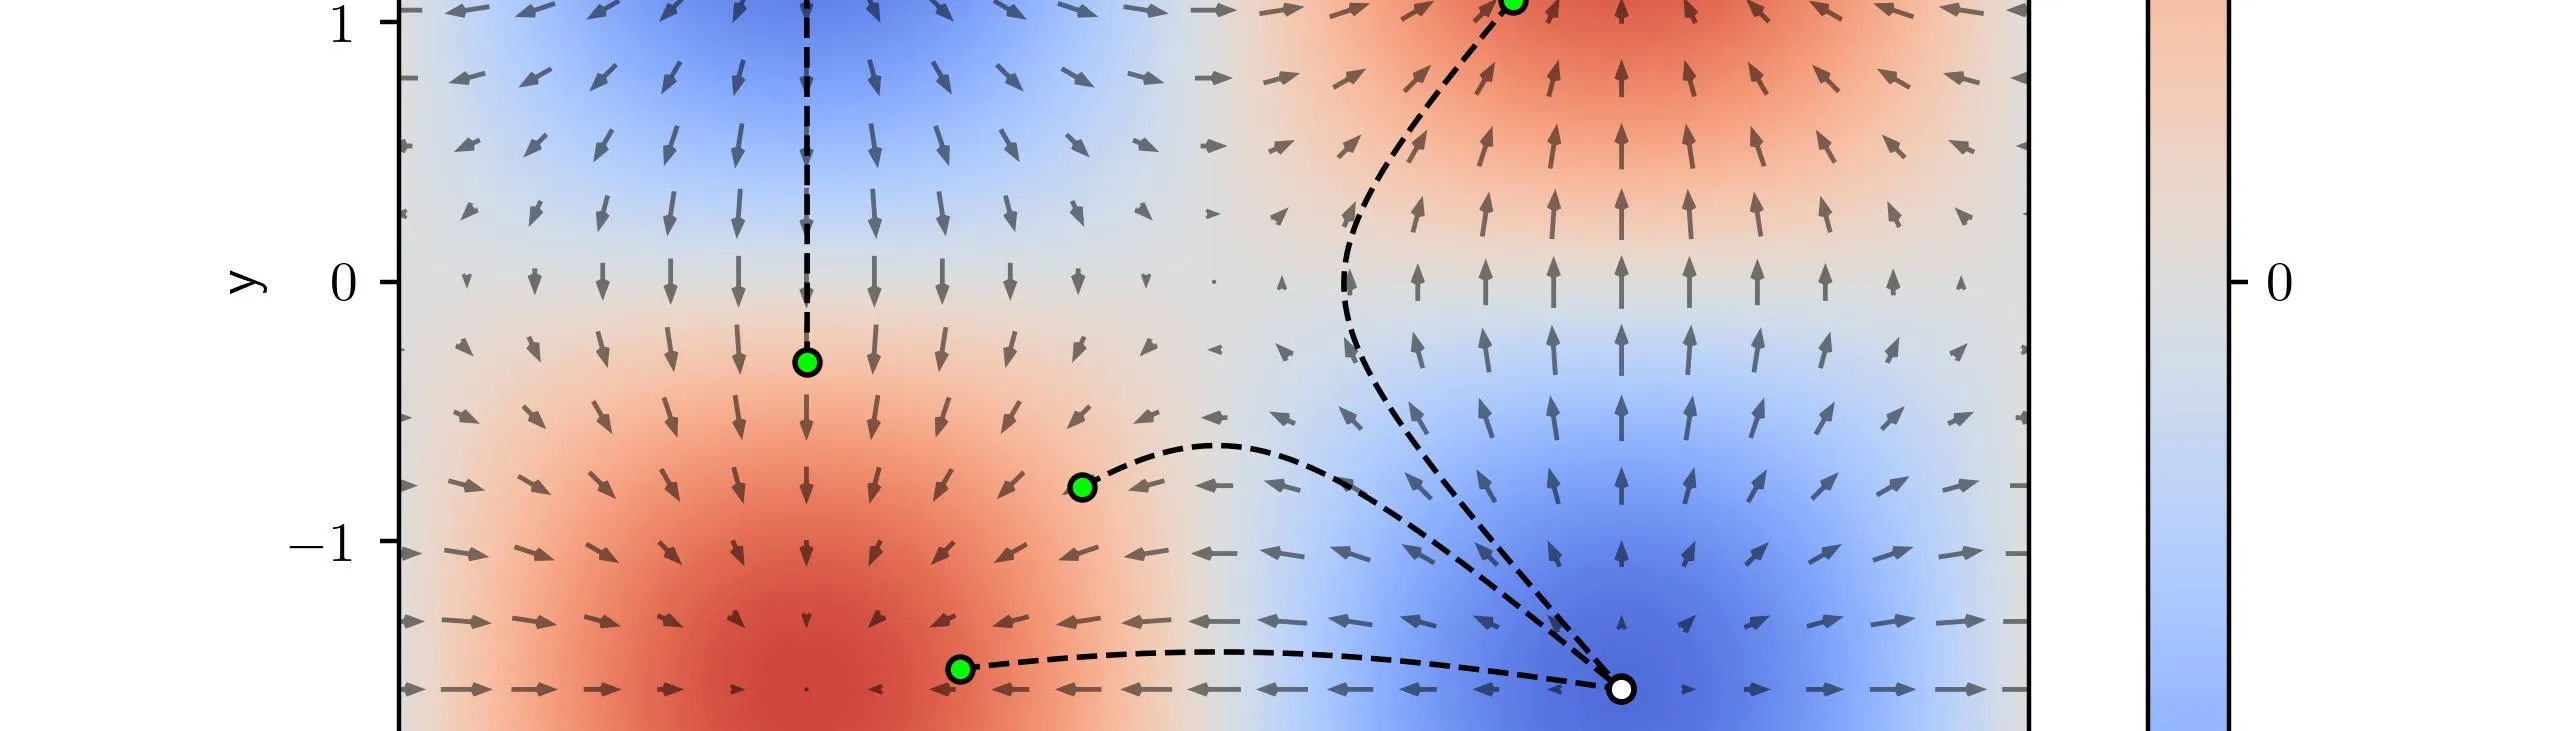
Le gradient est un vecteur qui pointe dans la direction de la plus forte montée de la fonction. Par conséquent, le négatif du gradient (-gradient) pointe dans la direction de la plus forte descente. C'est exactement l'information dont nous avons besoin pour savoir dans quelle direction faire notre pas.
La vidéo de 3Blue1Brown, bien que dans un contexte de réseaux de neurones, offre une visualisation spectaculaire de ce concept.
Gradient descent, how neural networks learn Chapter 2, Deep learning
Cette vidéo est une référence pour l'intuition visuelle derrière la descente de gradient. Elle explique brillamment le concept de gradient dans un espace à plusieurs dimensions.
Regardez la section allant de l'introduction à la minimisation. Elle commence par une fonction simple à une variable, puis généralise au cas de plusieurs variables. Portez une attention particulière à la manière dont le gradient est présenté comme le vecteur indiquant la direction de la plus forte pente. Le message clé est que pour minimiser la fonction, on doit se déplacer dans la direction opposée au gradient.
3. L'algorithme : La formule et le Taux d'Apprentissage
Maintenant que nous avons la direction (le négatif du gradient), nous devons définir la taille du pas. C'est le rôle du taux d'apprentissage (learning rate), souvent noté par la lettre grecque alpha ().
L'algorithme de la descente de gradient peut être résumé par les équations de mise à jour suivantes, qui sont appliquées de manière répétée :
Décortiquons ces équations :
- signifie que nous mettons à jour la valeur du poids .
- est le taux d'apprentissage. C'est un petit nombre positif (par exemple, 0.01) que nous choisissons. Il contrôle la taille du pas que nous faisons à chaque itération.
- est la dérivée partielle de la fonction de coût par rapport au poids . C'est la composante du gradient relative à . Elle nous dit comment le coût change lorsque nous modifions légèrement .
En substance, à chaque étape, nous calculons le gradient, le multiplions par le taux d'apprentissage, et soustrayons le résultat de nos paramètres actuels pour obtenir les nouveaux paramètres.
Le choix du taux d'apprentissage est crucial :
- Si est trop petit, les pas seront minuscules et l'algorithme prendra beaucoup de temps pour converger vers le minimum.
- Si est trop grand, les pas seront si grands que l'on risque de "sauter" par-dessus le minimum et de ne jamais converger. L'algorithme pourrait même diverger, avec un coût qui augmente à chaque étape.
L'article de Google "Linear regression: Gradient descent" explique ce processus de manière très concrète.
Linear regression: Gradient descent | Machine Learning
Cet article de la formation accélérée en Machine Learning de Google est une excellente ressource pratique. Il décrit l'algorithme de manière itérative et visuelle.
Lisez d'abord les étapes de l'algorithme pour bien comprendre le processus itératif. Ensuite, suivez l'exemple numérique. Observez comment les valeurs de Weight, Bias et Loss évoluent à chaque itération. Cela rend le processus très tangible. Explorez la section sur la convergence et les courbes de coût. La courbe de coût (loss curve), qui trace le coût en fonction des itérations, est un outil essentiel pour visualiser si le modèle apprend correctement. Enfin, la section sur les fonctions convexes explique une propriété importante : pour la régression linéaire avec l'erreur quadratique moyenne (MSE), la fonction de coût a la forme d'un bol. Cela garantit que la descente de gradient trouvera l'unique minimum global, c'est-à-dire la meilleure solution possible.
Pour une autre perspective sur l'importance du taux d'apprentissage, l'article "Understanding the Mathematics behind Gradient Descent" sur Towards Data Science propose des visualisations très parlantes.
Understanding the Mathematics behind Gradient Descent.
Cet article offre une bonne intuition mathématique et visuelle.
Concentrez-vous sur la section "The Learning rate". Les images illustrent parfaitement ce qui se passe lorsque le taux d'apprentissage est trop faible, trop élevé ou juste correct.
Conclusion
La descente de gradient est le moteur qui alimente l'apprentissage de nombreux modèles de machine learning. C'est l'algorithme qui, en s'appuyant sur les informations de la fonction de coût, ajuste intelligemment les paramètres du modèle pour minimiser l'erreur.
Points clés à retenir :
- La descente de gradient est un algorithme d'optimisation itératif qui cherche le minimum d'une fonction de coût.
- Il fonctionne en prenant des pas répétés dans la direction opposée au gradient de la fonction de coût, c'est-à-dire dans la direction de la plus forte descente.
- Le gradient indique la direction et l'ampleur de la plus forte pente de la fonction de coût.
- La taille de chaque pas est contrôlée par un paramètre crucial appelé le taux d'apprentissage ().
- Le processus se poursuit jusqu'à la convergence, c'est-à-dire lorsque le coût ne diminue plus de manière significative.
Maintenant que nous avons compris la théorie derrière l'entraînement d'un modèle simple (définir une fonction de coût et la minimiser avec la descente de gradient), nous sommes prêts à passer à la pratique. Dans la prochaine leçon, nous mettrons tout cela en action en entraînant notre tout premier modèle de machine learning, une régression linéaire simple, à l'aide de la bibliothèque Scikit-learn.