Bonjour ! Dans la leçon précédente, nous avons appris à nettoyer nos données en gérant les valeurs manquantes. C'est une étape cruciale, car une analyse effectuée sur des données incomplètes ou incorrectes est au mieux peu fiable, au pire trompeuse. Maintenant que nos données sont propres, nous pouvons passer à une phase plus excitante : l'extraction de connaissances.
L'objectif de cette leçon est d'apprendre à regrouper des données en fonction de catégories et à calculer des statistiques agrégées pour chaque groupe. C'est l'une des opérations les plus fondamentales et les plus puissantes de l'analyse de données. Vous apprendrez à répondre à des questions comme : "Quel est le chiffre d'affaires moyen par catégorie de produit ?", "Combien de clients avons-nous dans chaque pays ?", ou "Quelle est la note maximale obtenue par les étudiants de chaque classe ?". Pour cela, nous utiliserons la méthode .groupby(), un pilier de la bibliothèque Pandas.
1. La Stratégie "Split-Apply-Combine"
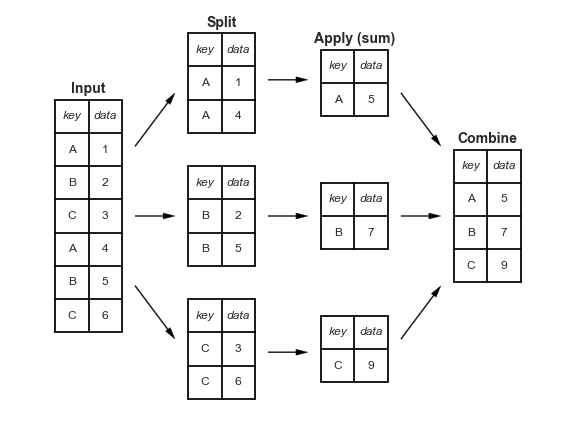
Au cœur de l'opération de groupement se trouve un processus en trois étapes, connu sous le nom de Split-Apply-Combine (Diviser-Appliquer-Combiner). Comprendre cette logique vous aidera à maîtriser groupby() intuitivement.
- Split (Diviser) : Pandas commence par parcourir la colonne que vous avez spécifiée et divise votre DataFrame en plusieurs sous-groupes. Chaque groupe contient toutes les lignes qui partagent la même valeur dans cette colonne.
- Apply (Appliquer) : Une fois les groupes formés, vous demandez à Pandas d'appliquer une fonction à chaque groupe indépendamment. Cette fonction est généralement une fonction d'agrégation, comme calculer une somme (
sum), une moyenne (mean), un comptage (count), etc. - Combine (Combiner) : Enfin, Pandas rassemble les résultats de chaque application dans un nouveau DataFrame, vous présentant un résumé concis de vos données.
L'image suivante illustre parfaitement ce processus :
2. Le Groupement Simple avec groupby()
Mettons cela en pratique. Imaginons que nous ayons un DataFrame simple contenant des données de ventes.
import pandas as pd

data = {
    'Categorie': ['Fruit', 'Legume', 'Fruit', 'Boulangerie', 'Legume', 'Fruit'],
    'Produit': ['Pomme', 'Carotte', 'Banane', 'Pain', 'Brocoli', 'Orange'],
    'Quantite': [10, 5, 8, 1, 4, 12],
    'Prix_Unitaire': [1.2, 0.5, 0.8, 2.5, 1.5, 1.0]
}
df_ventes = pd.DataFrame(data)
df_ventes['Chiffre_Affaires'] = df_ventes['Quantite'] * df_ventes['Prix_Unitaire']

print(df_ventes)
Résultat :
    Categorie  Produit  Quantite  Prix_Unitaire  Chiffre_Affaires
0       Fruit    Pomme        10            1.2              12.0
1      Legume  Carotte         5            0.5               2.5
2       Fruit   Banane         8            0.8               6.4
3  Boulangerie     Pain         1            2.5               2.5
4      Legume  Brocoli         4            1.5               6.0
5       Fruit   Orange        12            1.0              12.0
Maintenant, nous voulons connaître le chiffre d'affaires total pour chaque catégorie. C'est ici que groupby() entre en jeu. La syntaxe est très naturelle : df.groupby('colonne_de_groupement').fonction_aggregation().
# Grouper par 'Categorie' et calculer la somme pour chaque colonne numérique
ca_par_categorie = df_ventes.groupby('Categorie').sum()

print(ca_par_categorie)
Résultat :
             Quantite  Prix_Unitaire  Chiffre_Affaires
Categorie
Boulangerie         1            2.5               2.5
Fruit              30            3.0              30.4
Legume              9            2.0               8.5
Pandas a :
- Divisé le DataFrame en trois groupes : 'Boulangerie', 'Fruit', 'Legume'.
- Appliqué la fonction
sum()à toutes les colonnes numériques de chaque groupe. - Combiné les résultats en un nouveau DataFrame où l'index est maintenant la colonne de groupement ('Categorie').
L'article suivant de Data36 fournit une introduction très claire à ce concept.
Pandas groupby(), count(), sum() and Other Aggregation ...
Cet article explique les bases de l'agrégation et du groupement de manière très accessible.
Commencez par lire la définition théorique de l'agrégation. Ensuite, sautez la section de configuration et lisez la partie sur les méthodes d'agrégation de base (count, sum, min, max, mean). Enfin, concentrez-vous sur l'introduction à groupby() et son application pratique dans les sections "The pandas groupby() function" et "Pandas groupby() – in action".
3. Agréger avec plus de contrôle : la méthode .agg()
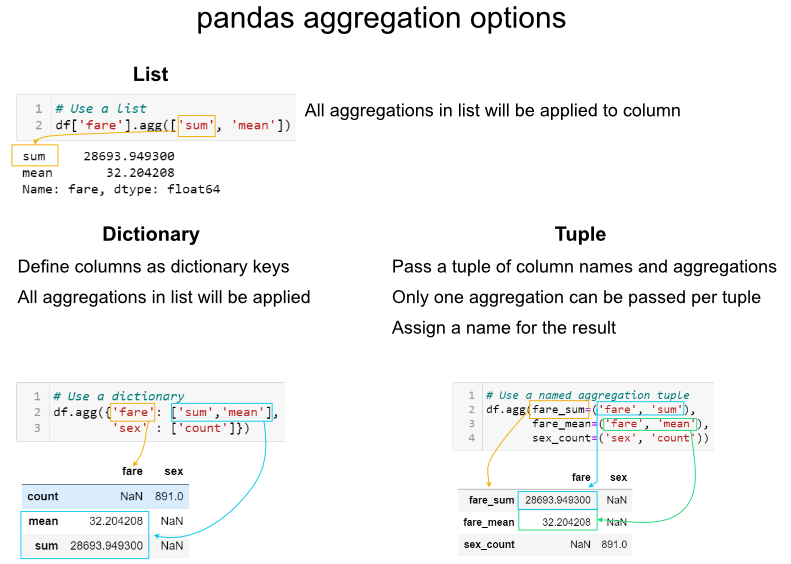
Que se passe-t-il si vous voulez appliquer plusieurs fonctions d'agrégation à la fois ? Ou des fonctions différentes à des colonnes différentes ? Enchaîner plusieurs appels à groupby() serait fastidieux. La méthode .agg() est la solution.
Appliquer plusieurs fonctions à une colonne
Supposons que pour le chiffre d'affaires, nous voulions à la fois la somme totale et la moyenne par catégorie. On peut passer une liste de fonctions à .agg().
# Sélectionner la colonne 'Chiffre_Affaires' après le groupement
# puis appliquer les agrégations
stats_ca = df_ventes.groupby('Categorie')['Chiffre_Affaires'].agg(['sum', 'mean', 'count'])

print(stats_ca)
Résultat :
                sum       mean  count
Categorie
Boulangerie     2.5   2.500000      1
Fruit          30.4  10.133333      3
Legume          8.5   4.250000      2
Nous obtenons bien la somme (sum), la moyenne (mean) et le nombre de ventes (count) pour chaque catégorie.
Appliquer des fonctions différentes à des colonnes différentes
Maintenant, un cas d'usage plus avancé et très courant. Nous voulons :
- La somme des 'Quantite' vendues.
- Le prix moyen ('Prix_Unitaire').
- Le nombre de produits différents ('Produit').
Pour cela, nous passons un dictionnaire à .agg(). Les clés du dictionnaire sont les noms des colonnes, et les valeurs sont les fonctions d'agrégation à appliquer.
resume_ventes = df_ventes.groupby('Categorie').agg({
    'Quantite': 'sum',
    'Prix_Unitaire': 'mean',
    'Produit': 'count'  # Ici 'count' compte le nombre de produits listés
})


# Renommons la colonne pour plus de clarté
resume_ventes.rename(columns={'Produit': 'Nombre_Produits'}, inplace=True)

print(resume_ventes)
Résultat :
             Quantite  Prix_Unitaire  Nombre_Produits
Categorie
Boulangerie         1           2.50                1
Fruit              30           1.00                3
Legume              9           1.00                2
Cette syntaxe avec un dictionnaire est extrêmement puissante et flexible. L'image suivante résume bien les différentes options pour l'agrégation.
La vidéo suivante de Alex The Analyst est une excellente démonstration de ces techniques.
Group By and Aggregate Functions in Pandas | Python Pandas Tutorials
Cette vidéo vous guide pas à pas dans l'utilisation de groupby() et .agg().
Regardez d'abord l'introduction pour comprendre comment .groupby() fonctionne et comment appliquer une première agrégation simple (.mean()). Ensuite, voyez comment utiliser d'autres agrégations comme .count() et .sum(). Enfin, portez une attention particulière à la section sur la méthode .agg(), qui montre comment passer un dictionnaire pour appliquer plusieurs fonctions à des colonnes spécifiques.
4. Groupement par plusieurs colonnes
La puissance de groupby() ne s'arrête pas là. Vous pouvez grouper vos données selon plusieurs critères à la fois en passant une liste de noms de colonnes.
Ajoutons une colonne 'Pays' à notre DataFrame pour rendre l'exemple plus intéressant.
df_ventes['Pays'] = ['France', 'Espagne', 'France', 'France', 'Italie', 'Espagne']


# Grouper par Pays ET par Categorie
ventes_par_pays_cat = df_ventes.groupby(['Pays', 'Categorie']).agg({
    'Chiffre_Affaires': 'sum'
})

print(ventes_par_pays_cat)
Résultat :
                     Chiffre_Affaires
Pays    Categorie
Espagne Fruit                    12.0
        Legume                    2.5
France  Boulangerie               2.5
        Fruit                    18.4
Italie  Legume                    6.0
Le résultat a maintenant un MultiIndex (index hiérarchique) sur les lignes. Cela nous donne un résumé très détaillé de nos ventes.
Le visionnage de la vidéo suivante de Hussam Hourani, une des sources que vous appréciez, peut également renforcer votre compréhension de ces concepts en arabe.
دروس لغة بايثون - تحليل البيانات Panda( بالعربي) - الدرس #7 Python in Arabic
Cette vidéo en arabe couvre les concepts de groupement et d'agrégation dans Pandas, ce qui peut vous offrir une perspective complémentaire.
La vidéo explique le concept de groupby() et montre comment appliquer diverses fonctions d'agrégation (mean, sum, count) avec des exemples pratiques. Regardez-la pour consolider les notions vues jusqu'à présent.
5. Fonctions d'agrégation utiles à connaître
En plus de sum, mean, et count, voici quelques autres fonctions très utiles :
size(): Compte le nombre total de lignes dans chaque groupe (y compris lesNaN, contrairement àcount()).nunique(): Compte le nombre de valeurs uniques dans une colonne pour chaque groupe.min(),max(): Retourne la valeur minimale ou maximale.std(): Calcule l'écart-type (standard deviation).describe(): Une fonction très pratique qui calcule plusieurs statistiques descriptives d'un seul coup (count, mean, std, min, max, percentiles).
# Obtenir un résumé statistique complet du chiffre d'affaires par catégorie
resume_complet = df_ventes.groupby('Categorie')['Chiffre_Affaires'].describe()
print(resume_complet)
Résultat :
             count       mean       std  min   25%   50%    75%   max
Categorie
Boulangerie    1.0   2.500000       NaN  2.5  2.50  2.50  2.500   2.5
Fruit          3.0  10.133333  3.132624  6.4  9.20 12.00 12.000  12.0
Legume         2.0   4.250000  2.474874  2.5  3.37  4.25  5.125   6.0
Exercice Pratique
Utilisons un nouvel ensemble de données sur des employés pour mettre en pratique ce que nous avons appris.
import pandas as pd
import numpy as np

data_employes = {
    'Departement': ['RH', 'IT', 'Vente', 'IT', 'Vente', 'RH', 'IT'],
    'Salaire': [45000, 72000, 60000, 85000, 55000, 48000, 90000],
    'Anciennete': [3, 5, 4, 8, 3, 4, 7],
    'Genre': ['F', 'M', 'M', 'M', 'F', 'F', 'M']
}
df_employes = pd.DataFrame(data_employes)
Vos tâches :
- Quel est le salaire moyen par département ?
- Pour chaque département, comptez le nombre d'employés et calculez l'ancienneté maximale. Utilisez la méthode
.agg(). - Calculez le salaire total versé, groupé par 'Departement' et par 'Genre'.
- Quel département a le plus grand écart de salaires (la différence entre le salaire max et min) ? Pour répondre, vous pouvez définir une petite fonction et l'utiliser avec
.agg().
Solutions
# 1. Salaire moyen par département
salaire_moyen_dept = df_employes.groupby('Departement')['Salaire'].mean()
print("1. Salaire moyen par département:")
print(salaire_moyen_dept)
print("\n" + "="*40 + "\n")


# 2. Nombre d'employés et ancienneté max par département
stats_dept = df_employes.groupby('Departement').agg({
    'Salaire': 'count', # On peut compter sur n'importe quelle colonne sans NaN
    'Anciennete': 'max'
}).rename(columns={'Salaire': 'Nombre_Employes'})
print("2. Nombre d'employés et ancienneté maximale par département:")
print(stats_dept)
print("\n" + "="*40 + "\n")


# 3. Salaire total par département et par genre
salaire_total_genre = df_employes.groupby(['Departement', 'Genre'])['Salaire'].sum()
print("3. Salaire total par département et par genre:")
print(salaire_total_genre)
print("\n" + "="*40 + "\n")


# 4. Département avec le plus grand écart de salaires
def ecart_salaire(series):
    return series.max() - series.min()

ecart_par_dept = df_employes.groupby('Departement')['Salaire'].agg(ecart_salaire)
print("4. Écart des salaires par département:")
print(ecart_par_dept)
print(f"\nLe département avec le plus grand écart de salaires est : {ecart_par_dept.idxmax()}")
Conclusion
Vous venez de débloquer une des compétences les plus importantes pour tout analyste de données. La capacité à segmenter des données en groupes logiques et à en extraire des résumés statistiques est au cœur de la découverte d'informations cachées dans les données brutes.
Les points clés à retenir :
- L'opération
groupbysuit une logique simple et puissante : Split-Apply-Combine. - On utilise
.groupby('colonne')pour créer des groupes, puis on enchaîne avec une fonction d'agrégation comme.sum(),.mean(), etc. - La méthode
.agg()offre une flexibilité maximale, vous permettant d'appliquer plusieurs fonctions ou des fonctions différentes à des colonnes spécifiques via un dictionnaire. - Il est possible de grouper par plusieurs colonnes en passant une liste, ce qui crée un
MultiIndexpour une analyse plus fine.
Maintenant que nous savons comment analyser et résumer les données au sein d'un même DataFrame, que se passe-t-il si nos informations sont réparties dans plusieurs tables ? Par exemple, une table avec les informations des ventes et une autre avec les informations des clients. Dans la prochaine leçon, nous apprendrons à fusionner ces différentes sources de données en utilisant pd.merge(), une autre compétence essentielle de votre boîte à outils d'analyste.